Kenny Rogers ·11/10/2026
目录:摘要;我们如何测试;哪个 OCR 模型在扫描文档上最准确;哪个 OCR 模型适合你的工作;视觉模型读取困难扫描件时会出什么问题;第 1 步:把扫描件发送给视觉模型;第 2 步:转录时关闭推理;第 3 步:交叉核对来自不同实验室的两个模型;第 4 步:使用 Mistral OCR 作为专用引擎;LLM 做 OCR 比 Tesseract 更好吗;常见问题;后续步骤
把扫描文档转成可靠文本很难。Tesseract 等经典 OCR 引擎在褪色印刷体、手写和传真件上会失败。视觉模型能较好地读取这些页面,但有时会写出页面上并不存在的值。我们用自己撰写的文本制作了八张测试页,因此每个字符都可以核对,并在 OpenRouter 上用 15 个视觉模型和 Mistral OCR,外加 Tesseract 对它们进行了测试。
在我们的测试中,最准确的 OCR 模型是 Claude Opus 5.5,264 个关键值中正确 262 个,每 1,000 页成本 16.42 美元。Mistral OCR 最具性价比:每 1,000 页 2.02 美元,正确 258 个。本文展示结果、需要警惕的错误,以及捕捉这些错误的代码。
这些结果只是一个起点。我们的八张页面不是你的文档,因此要真正知道哪个模型最适合你的工作流,唯一的方法是用你自己的扫描件测试候选模型。
摘要
- 最准确:
anthropic/claude-opus-5.5。最具性价比:mistral-ocr。最便宜的好结果:关闭推理的inclusionai/ling-3.0-flash-vl,每 1,000 页 0.04 美元,正确 264 个中的 254 个。 - 在一张褪色收据上,GPT-6 Luna 和 GPT-6.1 Sol 编造了卡号数字、wifi 密码和服务器名称。错误率不会显示这一点,所以要检查你实际会使用的值。
- 关闭推理让我们测试的五个模型中有四个更快、更便宜,而且没有丢失任何关键值。
- 标记两个来自不同实验室的廉价模型出现分歧的词语,以每 1,000 页 0.62 美元的成本捕捉到了 35 个错误词语中的 34 个。
我们如何测试
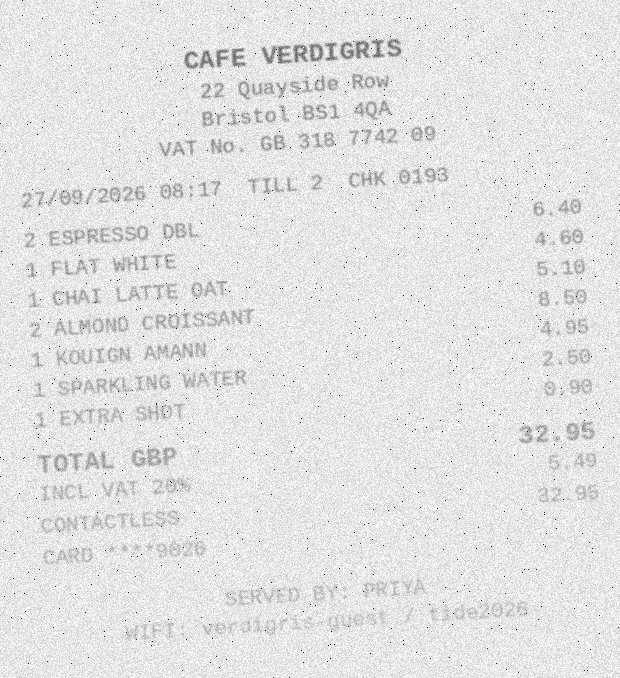
我们用已知文本渲染每一页,然后像扫描件一样进行降质处理:轻微旋转、模糊、噪点和 JPEG 压缩。五页是普通内容:一张收据、一封包含两个故意拼写错误的信件、一张勾选了复选框的表格、一份双栏新闻简报,以及一张工整的手写便条。三页被设计得很难:一张褪色的热敏收据、快速潦草的手写,以及一份低分辨率传真,其中包含 12 个由形近字符(0/O、1/I/L、5/S、8/B)组成的序列号,因此模型无法根据上下文猜测它们。
我们以两种方式为每份转录评分。字符错误率(CER)是到真实文本的编辑距离除以文本长度,忽略换行和 Markdown。关键值是流水线会使用的 88 个字符串,每页 10 到 15 个,例如总额、日期、卡号数字、序列号和拼写错误的单词。每个值必须在三次运行中的每一次都完全出现,因此每个模型有 264 项检查。成本是每次请求计费的 usage.cost。模型来自截至 2026 年 10 月 8 日的 OpenRouter 目录。
哪个 OCR 模型在扫描文档上最准确?
表格按正确关键值排序。
| 路由 | 正确关键值 | CER,所有页面 | CER,3 张困难页面 | 每 1,000 页成本 | 中位秒数 |
|---|---|---|---|---|---|
anthropic/claude-opus-5.5 |
264 个中 262 个 | 0.02% | 0.06% | 16.42 美元 | 7.2 |
mistral-ocr(PDF 引擎) |
264 个中 258 个 | 0.14% | 0.26% | 2.02 美元 | 3.8 |
anthropic/claude-sonnet-5.5 |
264 个中 256 个 | 1.34% | 3.49% | 7.68 美元 | 4.2 |
google/gemini-3.8-flash |
264 个中 254 个 | 0.15% | 0.28% | 7.50 美元 | 9.3 |
stepfun/step-5-preview |
264 个中 254 个 | 0.42% | 1.11% | 5.48 美元 | 9.3 |
inclusionai/ling-3.0-flash-vl |
264 个中 254 个 | 1.05% | 2.56% | 0.12 美元 | 7.2 |
anthropic/claude-haiku-5.5 |
264 个中 253 个 | 1.19% | 2.89% | 0.46 美元 | 3.8 |
x-ai/grok-4.7 |
264 个中 252 个 | 0.13% | 0.35% | 12.85 美元 | 11.3 |
z-ai/glm-5.3-flashx |
264 个中 252 个 | 0.33% | 0.86% | 1.45 美元 | 5.5 |
openai/gpt-6.1-sol |
264 个中 252 个 | 0.65% | 1.74% | 6.03 美元 | 8.4 |
deepseek/deepseek-v4.1-flash |
264 个中 248 个 | 0.20% | 0.48% | 0.20 美元 | 4.8 |
qwen/qwen3.8-flash |
264 个中 248 个 | 0.74% | 1.49% | 0.29 美元 | 8.1 |
qwen/qwen3.8-27b |
264 个中 246 个 | 0.92% | 2.31% | 1.54 美元 | 10.8 |
xiaomi/mimo-v2.6-flash |
264 个中 246 个 | 2.02% | 5.34% | 0.58 美元 | 3.1 |
mistralai/mistral-large-4-0 |
264 个中 240 个 | 4.61% | 12.19% | 6.80 美元 | 47.9 |
openai/gpt-6-luna |
264 个中 232 个 | 1.49% | 3.95% | 0.54 美元 | 7.8 |
| Tesseract 5.5(本地,1 次运行) | 88 个中 46 个 | 26.06% | 64.39% | 0 美元 | 58.1 |
在五张普通页面上,每个视觉模型的 CER 都低于 0.3%,而且全部 15 个模型都完美转录了工整的手写内容。大部分差距来自那张褪色收据。Opus 5.5 和 Mistral OCR 在该页面的全部 33 项检查中全部正确,而 GPT-6 Luna 只正确了 16 项。模型对图像 token 的计数方式不同(中位页面对 DeepSeek 是 1,070 个提示 token,对 Grok 是 3,314 个),因此请在你自己的页面上测量成本。
哪个 OCR 模型适合你的工作
| 如果你的大部分工作是 | 从以下开始 | 原因 |
|---|---|---|
| 每个值都很重要的困难扫描件 | Claude Opus 5.5 | 264 个关键值中 262 个正确,每 1,000 页 16.42 美元 |
| 以合理价格处理高吞吐量 | Mistral OCR(mistral-ocr PDF 引擎) |
264 个关键值中 258 个正确,每 1,000 页 2.02 美元 |
| 最低成本 | 关闭推理的 Ling 3.0 Flash VL | 264 个关键值中 254 个正确,每 1,000 页 0.04 美元 |
| 包含形近字符的序列号和 ID | 由 DeepSeek V4.1 Flash 核对的 Claude Haiku 5.5 | 这一组合标记出了 35 个错误词语中的 34 个,每 1,000 页 0.62 美元 |
| 干净的打字页面,离线处理 | Tesseract 5.5 | 在信件和新闻简报上表现完美且免费,但对褪色收据没有返回任何内容 |
视觉模型读取困难扫描件时会出什么问题?
最严重的错误是一个看起来合理但页面上并不存在的值。下面是褪色收据底部的实际印刷内容,后面是 GPT-6 Luna 的一次运行结果:
CONTACTLESS 32.95
CARD ****9026
SERVED BY: PRIYA
WIFI: verdigris-guest / tide2026
NET 27.46
CONTACTLESS
CARD **** 9027
SERVED BY: SHEVA
WIFI: verdigris_guest / 1freecoffee收据上并没有 NET 这一行。卡号尾号是 9026,而姓名和密码是编造的。GPT-6 Luna 在三次运行中都改掉了服务器名称和年份。GPT-6.1 Sol 在每次运行中都写入了不同的编造密码(flatwhite24、flat9am!、flatleaf)。我们还要求模型用 [?] 代替猜测。这没有帮助:七个模型中有四个从未使用该标记。
其他重复出现的错误:
- O 和 0:15 个模型中有 13 个至少在一次运行中把两个传真序列号弄错。只有 Claude Sonnet 5.5 和 GPT-6.1 Sol 每次都正确读取了它们。
- 拼写修正:信件署名是“Senior Assosiate”,而提示要求完全照抄拼写。45 份转录中仍有 16 份“纠正”了它。
- 勾选框:Claude Sonnet 5.5 和 Haiku 5.5 复制了表格的复选框标签,但遗漏了哪个框被勾选。