
Jess Weng 2026年10月14日 10分钟 返回博客 创建智能体 分享
要点速览
- 当长时间运行的智能体积累的上下文超过模型可承载的量时,就会出现「上下文腐化」(context rot),导致准确率下降。
- Deep Agents 是 LangChain 开源的智能体运行框架,它使用五种技术把上下文移出活跃窗口(但不删除),以防止上下文腐化。
- 在 Deep Agents 中,智能体的记忆以普通文件形式存放在你可控的存储中,因此你可以切换模型或提供商,同时保留它学到的全部内容。
如果你曾在考前一晚突击复习,你就懂那种感觉:学得越多,前面几章反而开始记不清了。
智能体也有同样的问题。当它们承担更长的任务时,会接收越来越多的信息(指令、工具结果、文件等);最终这些内容会远远超出模型的上下文窗口所能舒适容纳的上下文。模型携带的历史、噪声和工具输出越多,其准确率和推理能力往往越差。
在智能体工程领域,我们称之为上下文腐化。本文介绍管理智能体上下文窗口的技术,以及 Deep Agents 框架如何通过名为「中间件」(middleware)的概念将这些技术注入智能体的运行过程。
理解上下文工程技术
简而言之,智能体就是一个被运行框架包裹起来的模型。
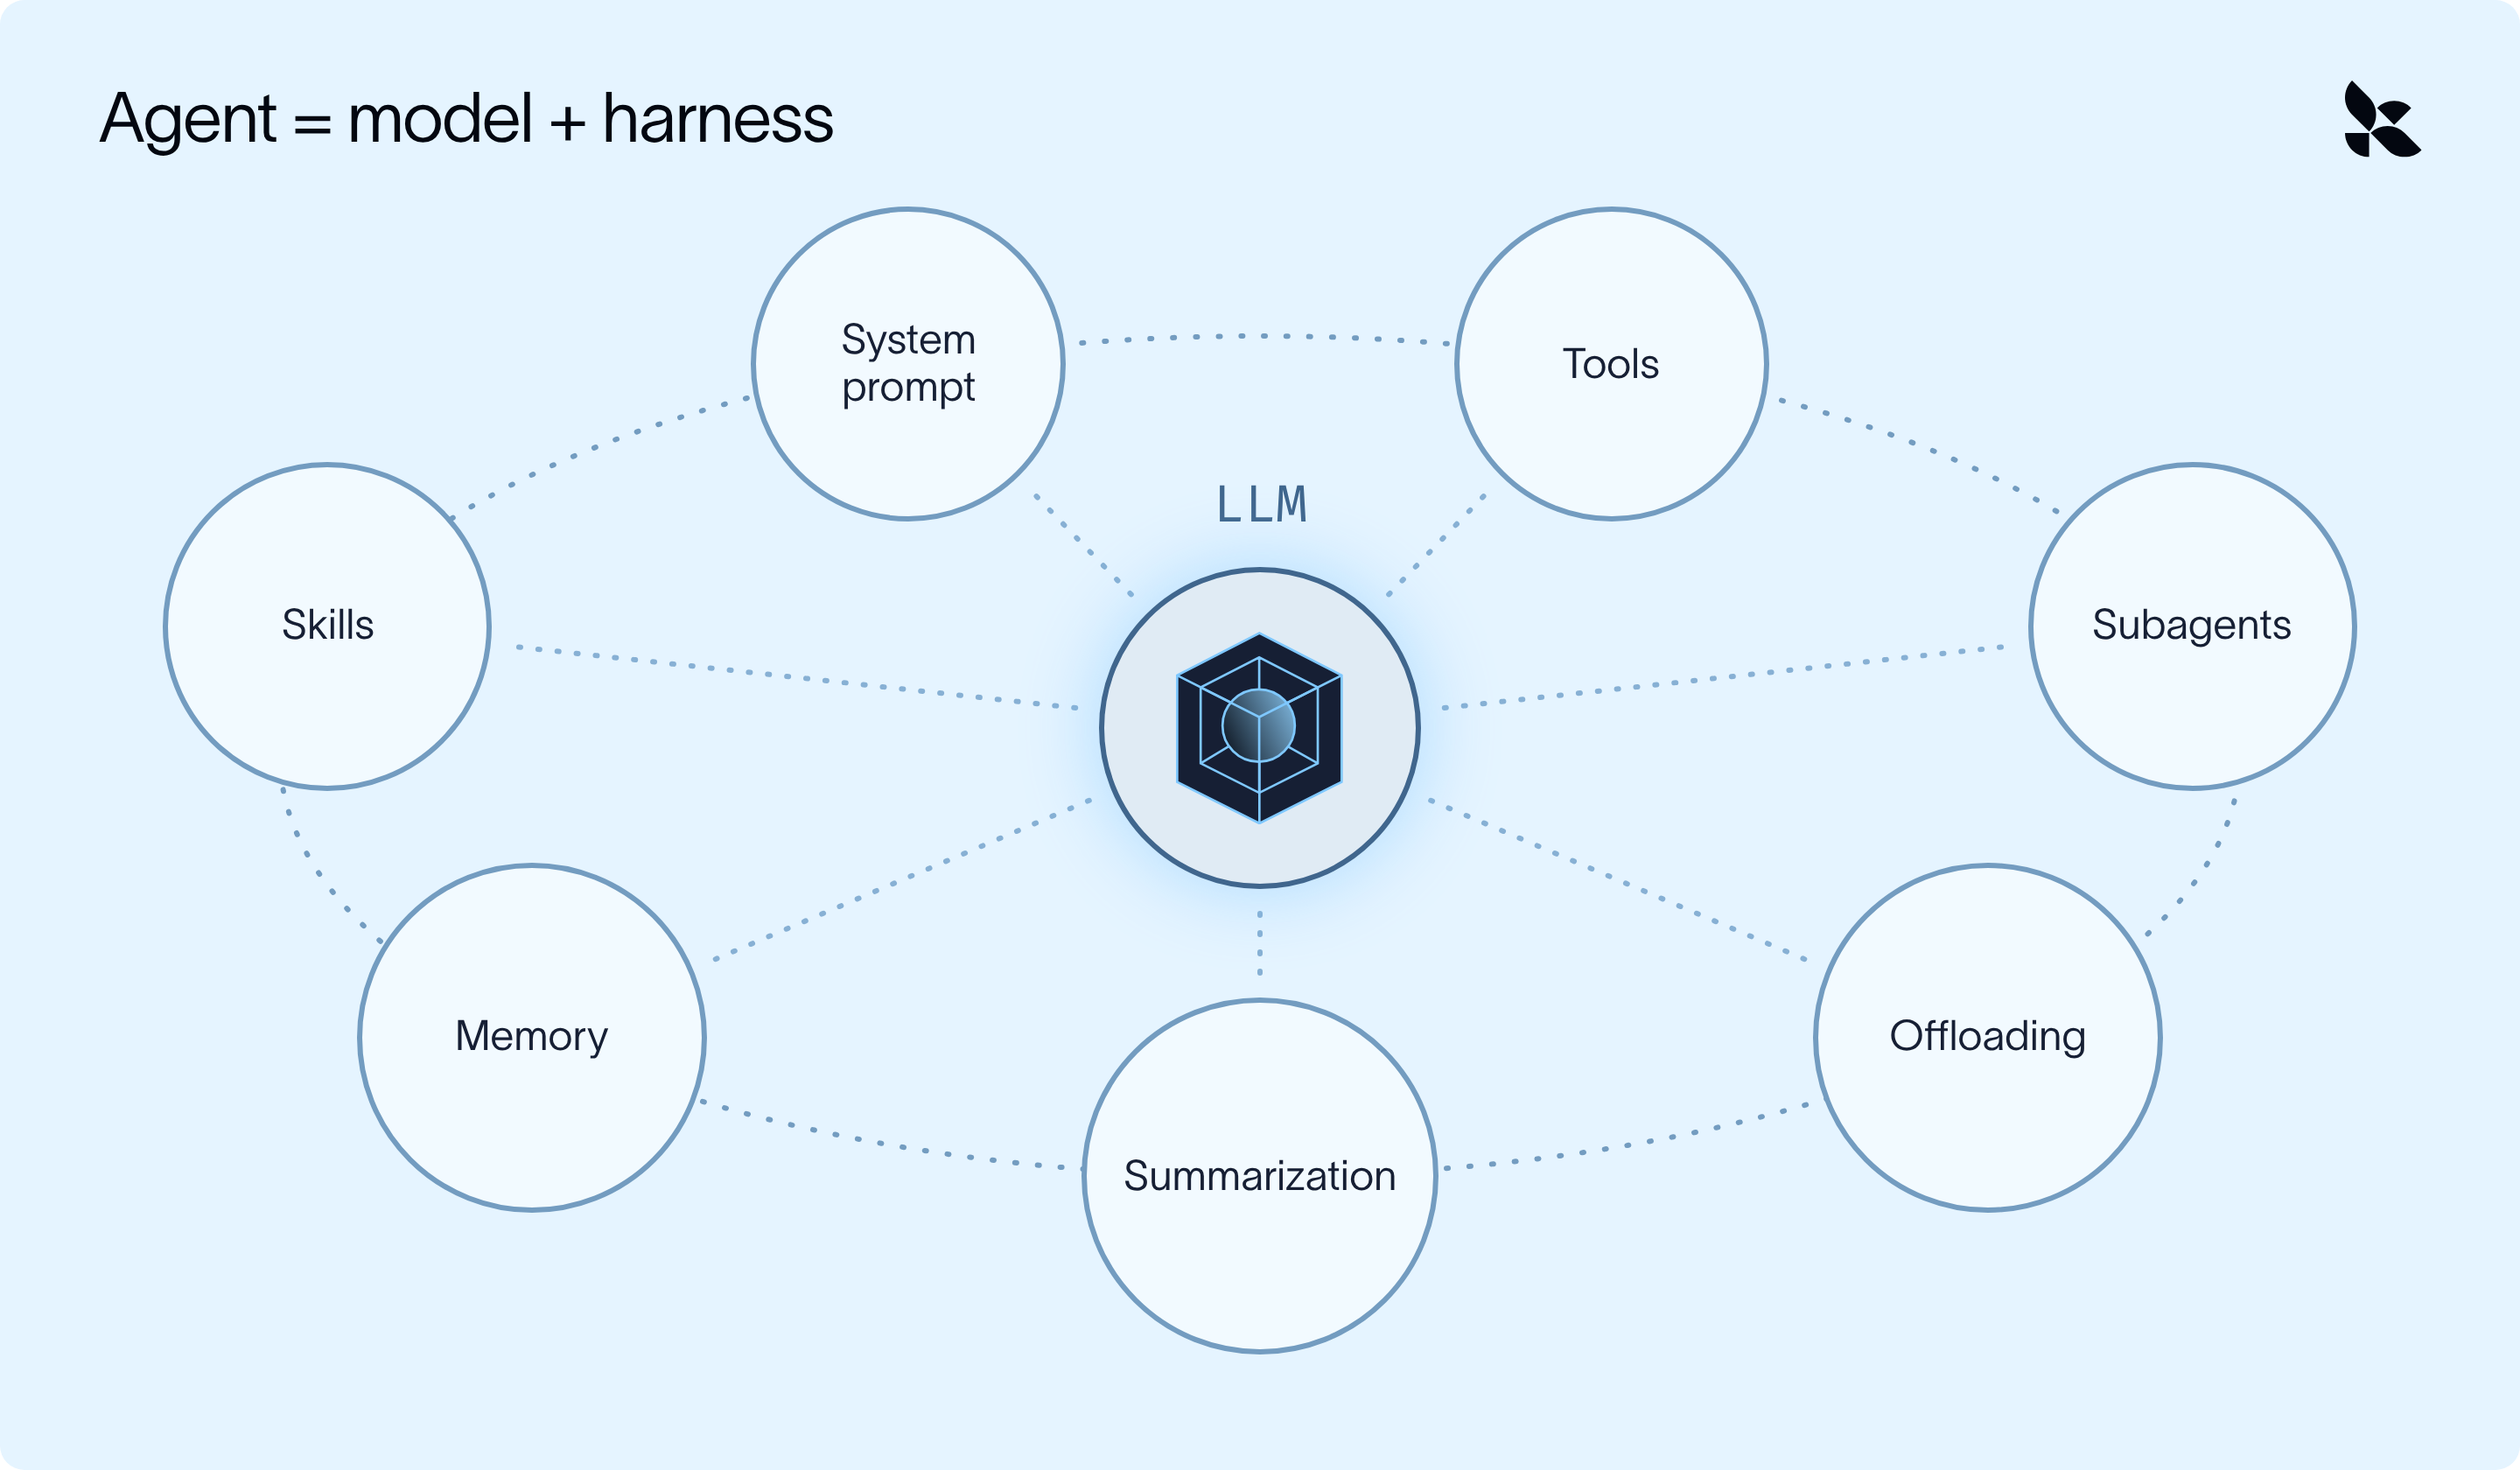
智能体可用于应对上下文腐化的上下文工程技术主要分为两类:
- 阻止不必要的信息进入上下文窗口
- 管理和过滤已经存在于上下文窗口中的内容
运行框架会有策略地应用这些方法,以便针对给定任务让模型在正确的时间获得正确的上下文(检索)。
然而,要搭建一个能很好做到这一点的运行框架,说起来容易做起来难,需要大量工作(如果你属于考前一晚突击复习的那类人,可能会觉得工作量太大了)。
Deep Agents 是 LangChain 开源的运行框架。它用一系列技术包裹你选择的模型,把上下文移出活跃窗口(移入文件、摘要或独立的智能体),使主智能体只携带它需要的内容(并且之后需要时还能恢复原始数据):
- 卸载(Offloading):大型工具结果和用户消息会保存到文件系统,模型只看到预览。
- 摘要(Summarization):当对话接近上下文上限时,较早的消息会被压缩成摘要。
- 技能(Skills):任务知识只在模型判断其相关时才加载。
- 子智能体(Subagents):噪声较大的工作在独立的上下文窗口中运行,只把结果返回。
- 长期记忆(Long-term memory):智能体学到的内容会保存到文件,并延续到下一次对话。
将上下文工程应用于常见用例
让我们看看上述技术如何应用于一个真实场景:竞品分析智能体。这个智能体每周一会调研五家竞争对手,并按团队模板撰写报告。单次运行大致如下:
- 拉取公司 A 的市场数据导出(数万行)
- 搜索新闻,阅读几篇文章并做笔记
- 对公司 B 到 E 重复上述步骤
- 起草报告,根据你的反馈修改并排版
到第 4 步时,该智能体在每次模型调用中都携带着五份原始导出、数十条搜索结果和两份过时草稿。其中大部分内容对最终报告的排版并无用处。
检索方法(RAG 或文件系统搜索)能帮助智能体只拉取它需要的内容,但这只解决了一半问题。即便是一个精准的智能体,也会积累不必要的消息、工具结果和中间工作产物,因此运行框架还必须管理上下文中以及上下文周边已有的内容。
如何实现这些技术:中间件
智能体在一个循环中运行:模型决定做什么,调用工具,读取结果,然后重复,直到任务完成。中间件 是插入该循环中特定位置的代码:例如在智能体启动之前、在每次模型调用前后,或在每次工具调用前后。
- 在每个位置上,它可以读取上下文,并在下一步运行前对其进行修改。
- 本文中的每一项上下文工程技术,都是挂接到这些位置之一的一段中间件。
- 其中大部分功能是内置的,因此你无需编写任何中间件即可使用这些技术(除非你想自定义某些特定功能)。
卸载:将内容留在上下文窗口之外
我们的智能体并不总是需要看到每次工具调用或人类消息返回的全部数据,尤其是在数据量很大的情况下。
例如,每次调用 pull_market_report 工具都会返回一份完整的数据导出(数千行);然而,智能体只需要其中的几个数字,因此可以限制模型只看到这几行。
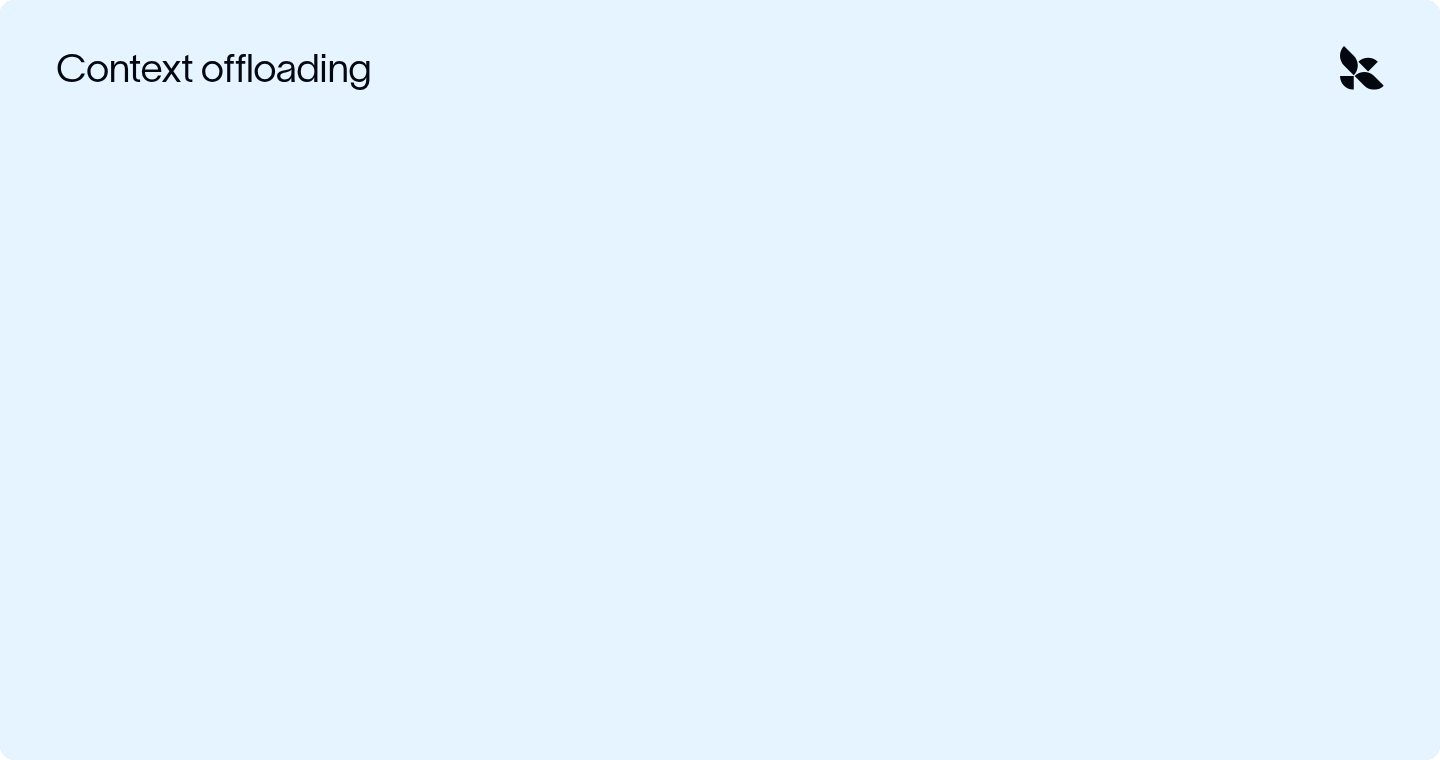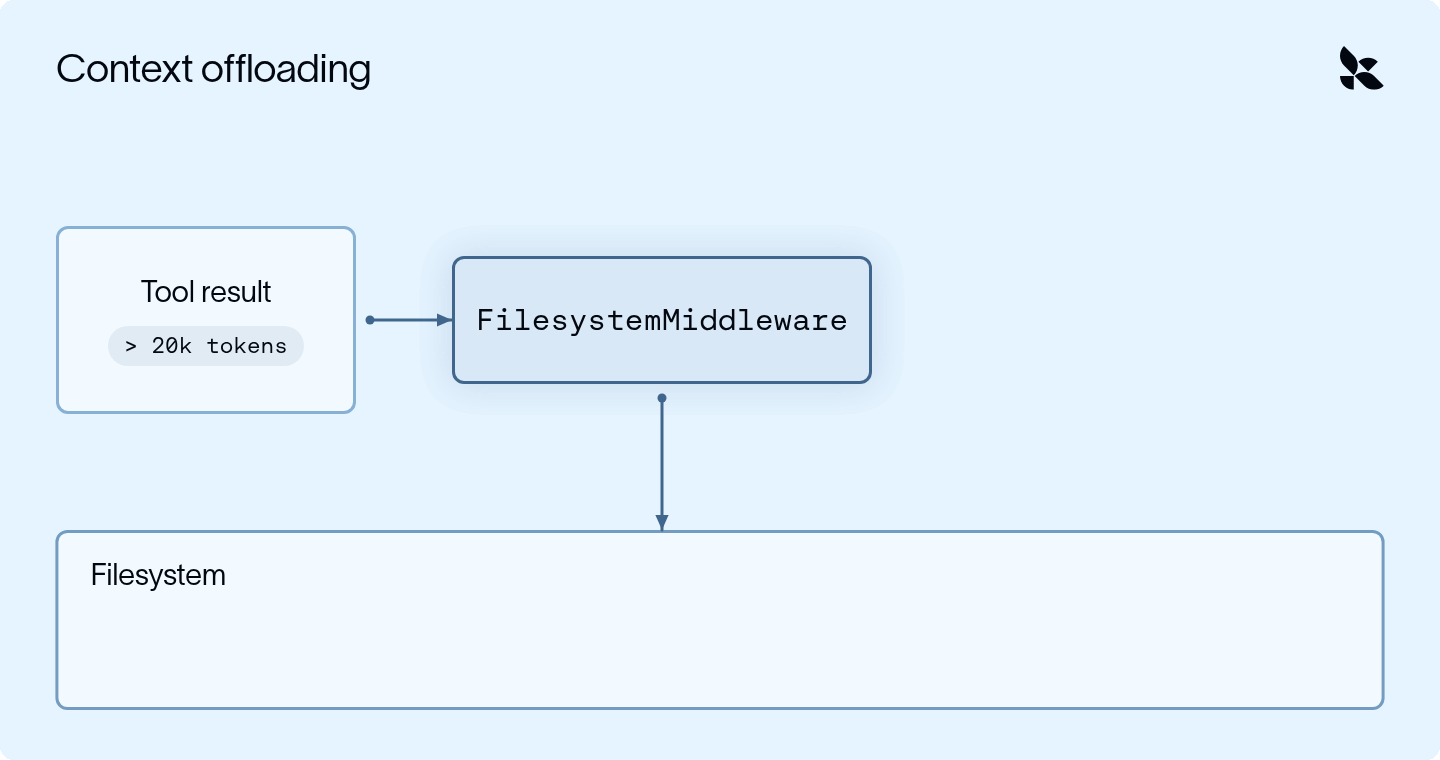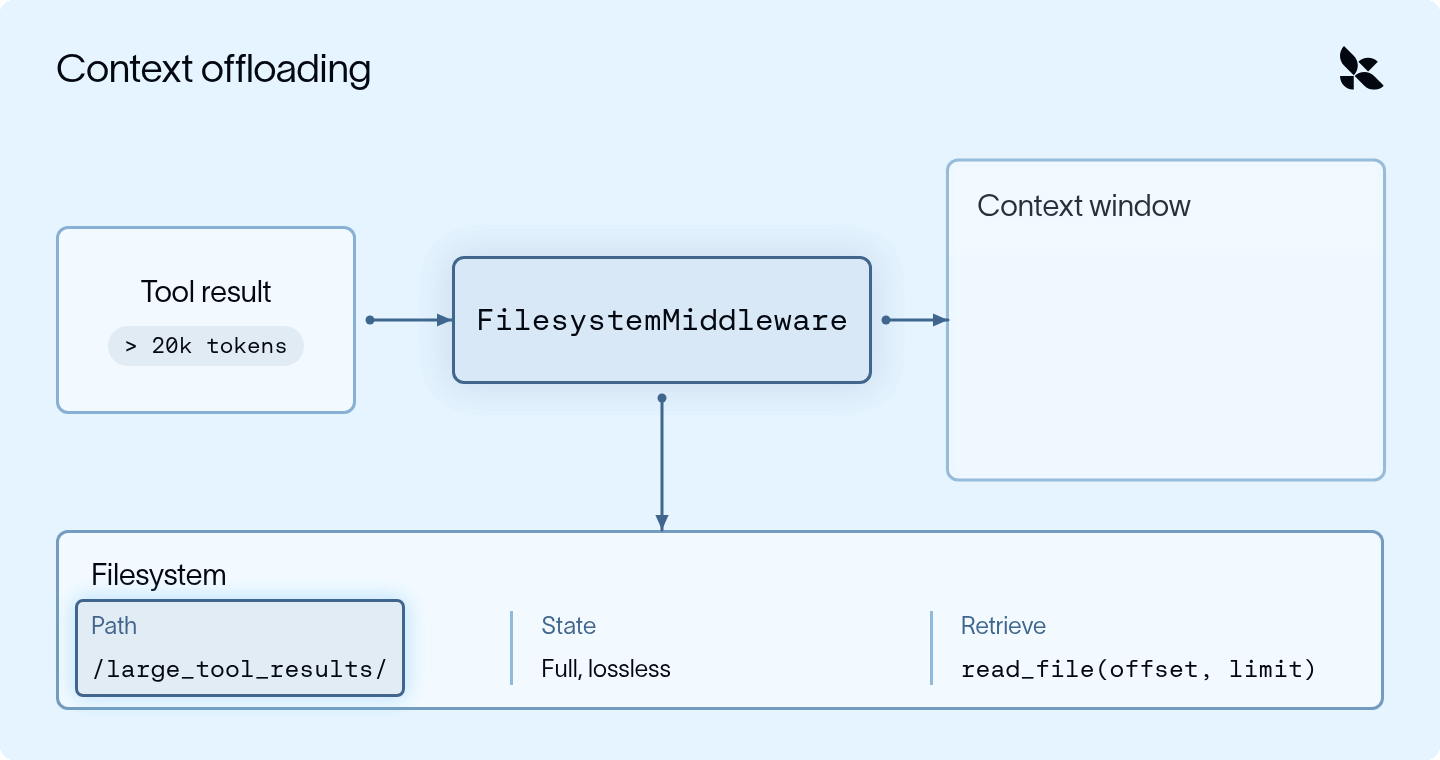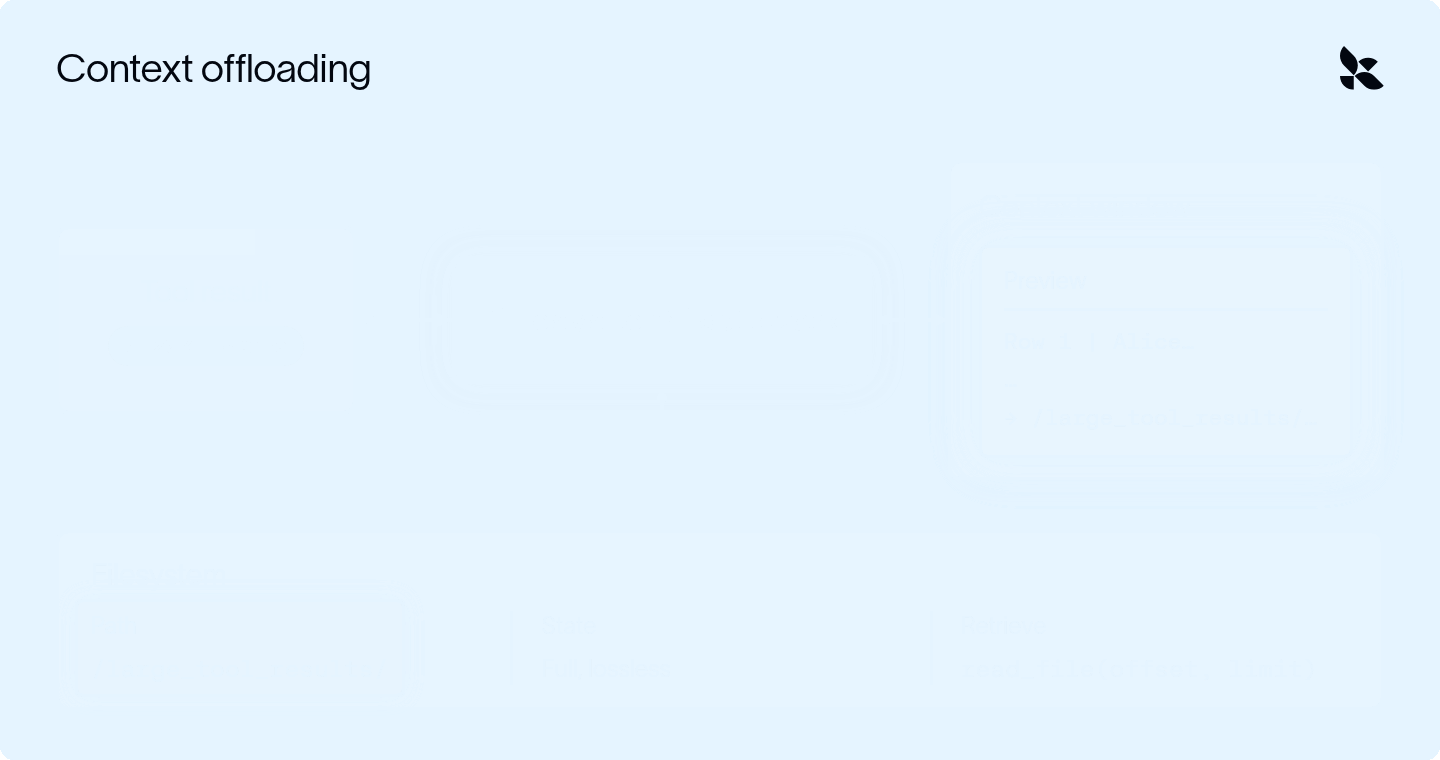
FilesystemMiddleware 在每次调用工具时运行:
- 当工具结果超过约 20,000 个 token 时,完整结果会在进入对话之前被写入 /large_tool_results/{tool_call_id}。
- 模型只会看到一段简短的预览(开头和结尾的几行)以及文件路径。
- 当智能体之后需要公司 B 的季度营收时,它会用 read_file 分页读取该文件。
过大的用户/人类消息(例如粘贴的通话记录)会以更高的阈值(50,000 个 token)得到同样的处理,并被保存到 /conversation_history/。
摘要:压缩已有内容
尽管我们会尽力将冗长的工具调用结果卸载(offload)到上下文之外,但在长时间运行中,上下文仍会逐渐堆积(例如对五家公司进行搜索、记录笔记和起草文稿)。摘要(Summarization)可以把智能体的整个上下文窗口浓缩成一份对迄今为止所发生事情的总结,从而让它能够继续开展研究任务。
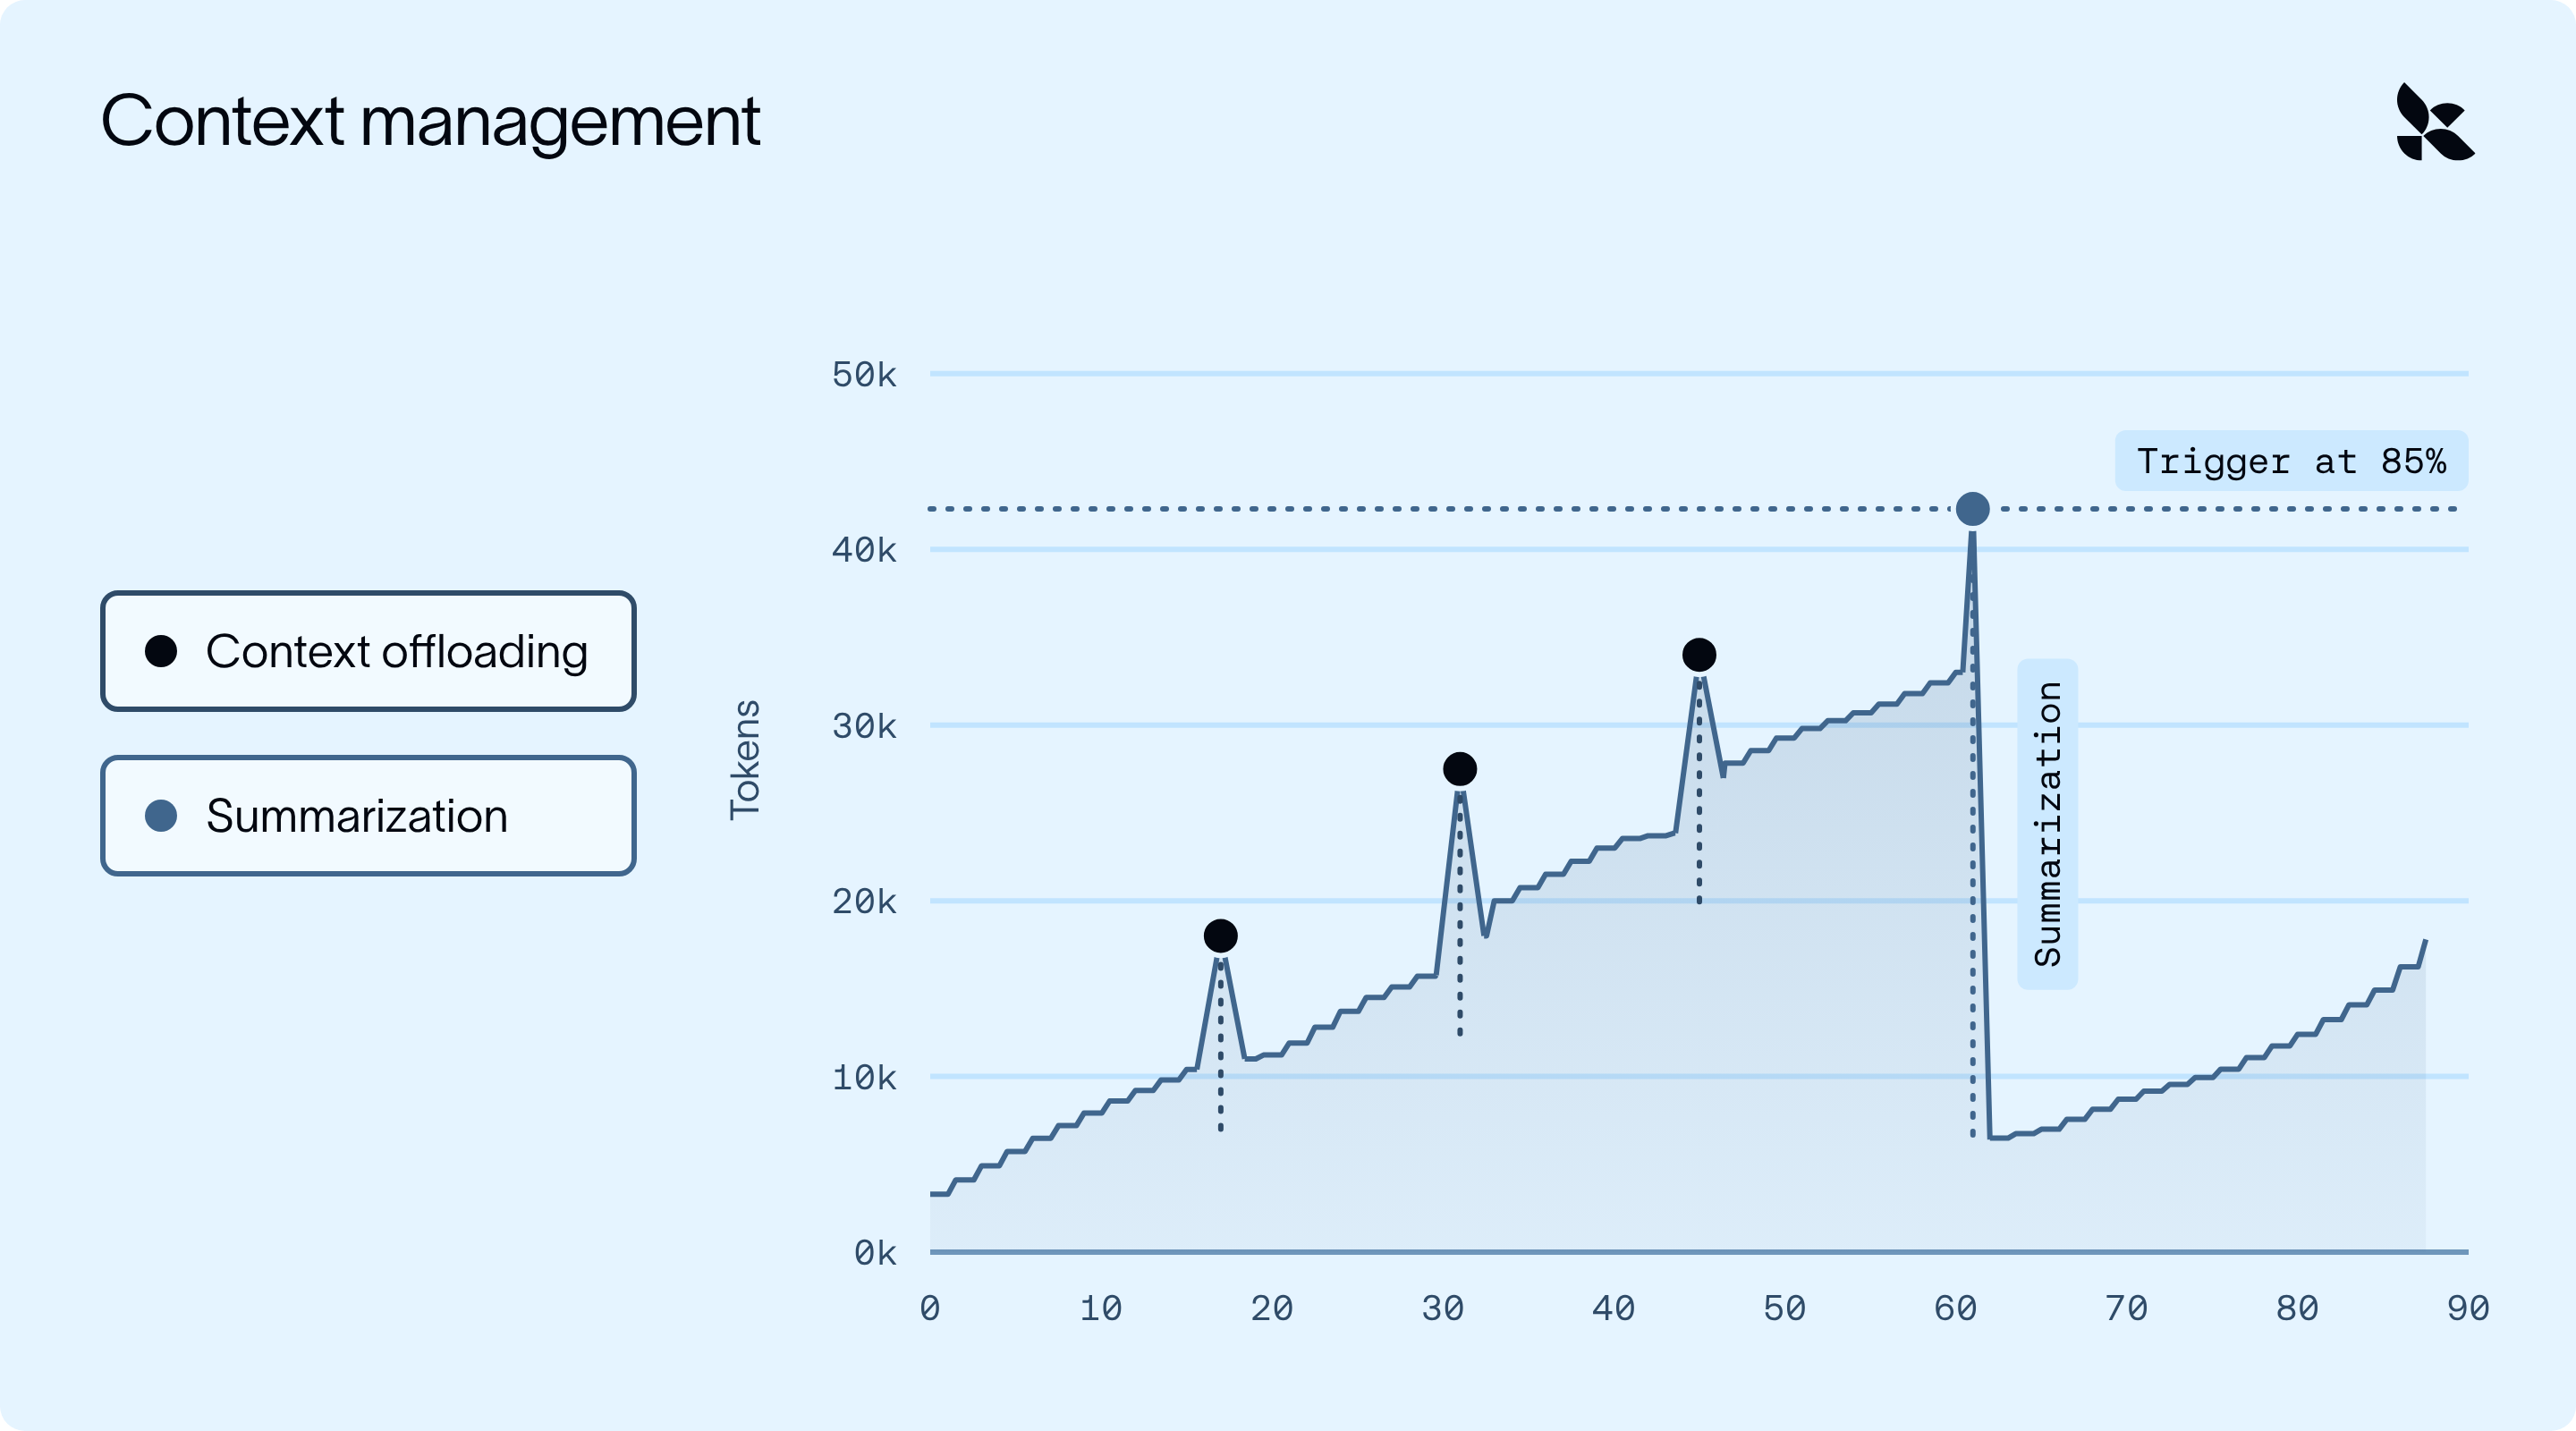
- 图中的尖峰代表大型工具结果或人类消息的到来;卸载机制会在模型看到它们之前,将每一条替换为一段简短预览,因此上下文只会小幅增长。
- 摘要机制则应对缓慢攀升:一旦使用量达到 85%,较早的消息就会被浓缩为一份摘要,上下文随之回落。
SummarizationMiddleware 会在每次模型调用前检查 token 使用量:
- 一旦使用量越过阈值(默认是模型上下文窗口的 85%),就会发起一次独立的 LLM 调用,将较早的消息浓缩为一份摘要。
- 较早的消息会从上下文窗口中移除,而最近的消息则原样保留。
- 模型现在会先看到摘要,再看到最近的消息(因此近期内容不会被改写)。
两个重要细节:
- 可恢复。 被摘要的消息会写入 /conversation_history/{session_id}.md。如果智能体在起草时需要 A 公司研究中的某个细节,它可以重新读回。
- 会循环。 随着运行继续,使用量会再次攀升,下一次摘要会包含上一份摘要。
你也可以在话题切换时进行摘要,而不只是在达到某个 token 阈值时。自定义摘要提示词(prompt)会很有帮助。
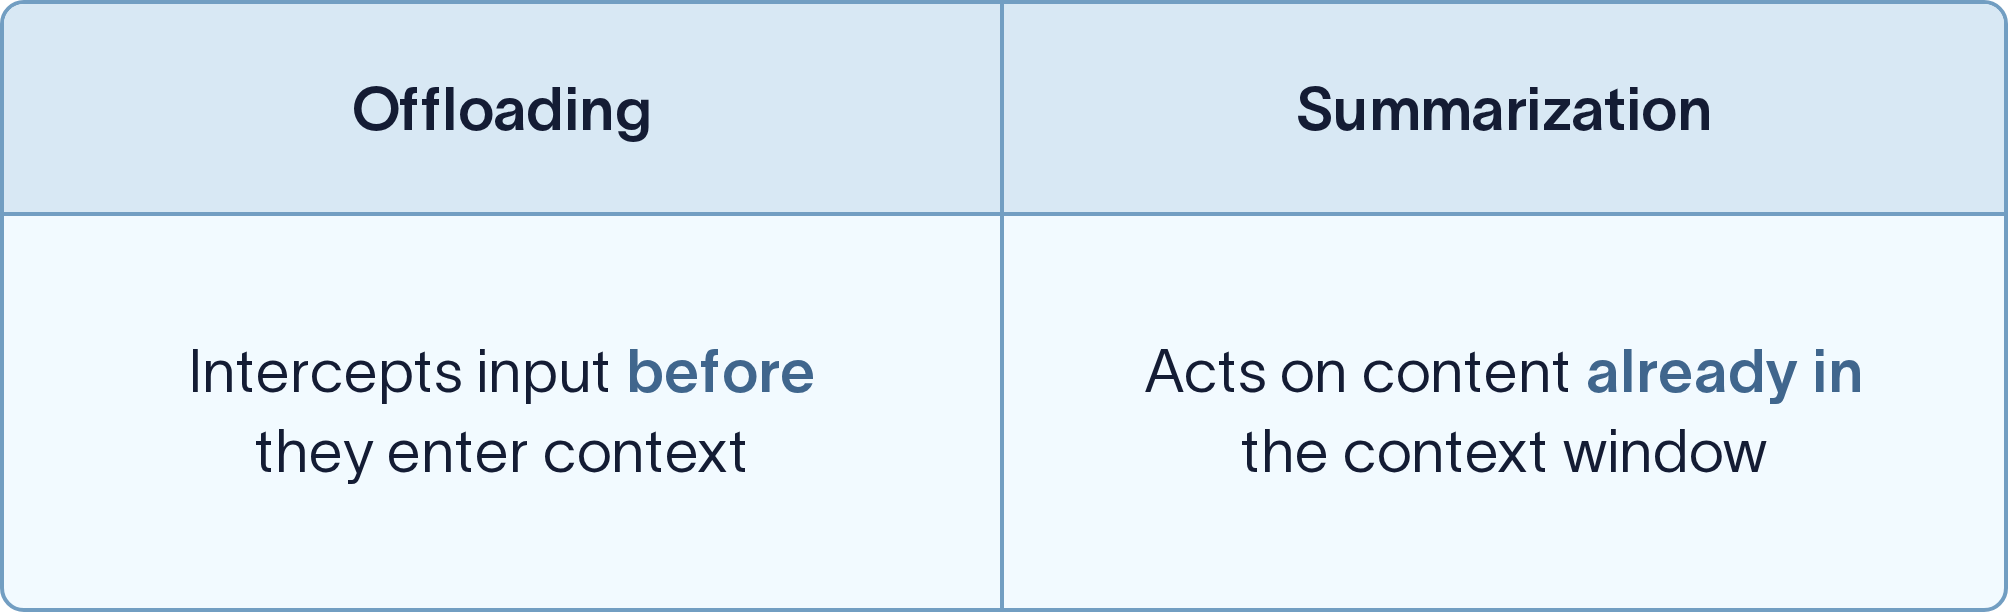
我们关于 Deep Agents 上下文管理 的文章对这两者都有更详细的介绍。
技能:只在需要时加载信息
假设你的销售团队有固定的季度业务回顾(QBR)格式。智能体每季度只需要一次这些说明,因此把它们放在系统提示词里,就意味着每次调用都要为它们付出代价(token 和响应时间)。相反,你可以把这些信息打包成一个技能(skill)。
技能是一个说明文件夹(可附带脚本和参考文档),为智能体提供完成某项专门任务所需的内容。
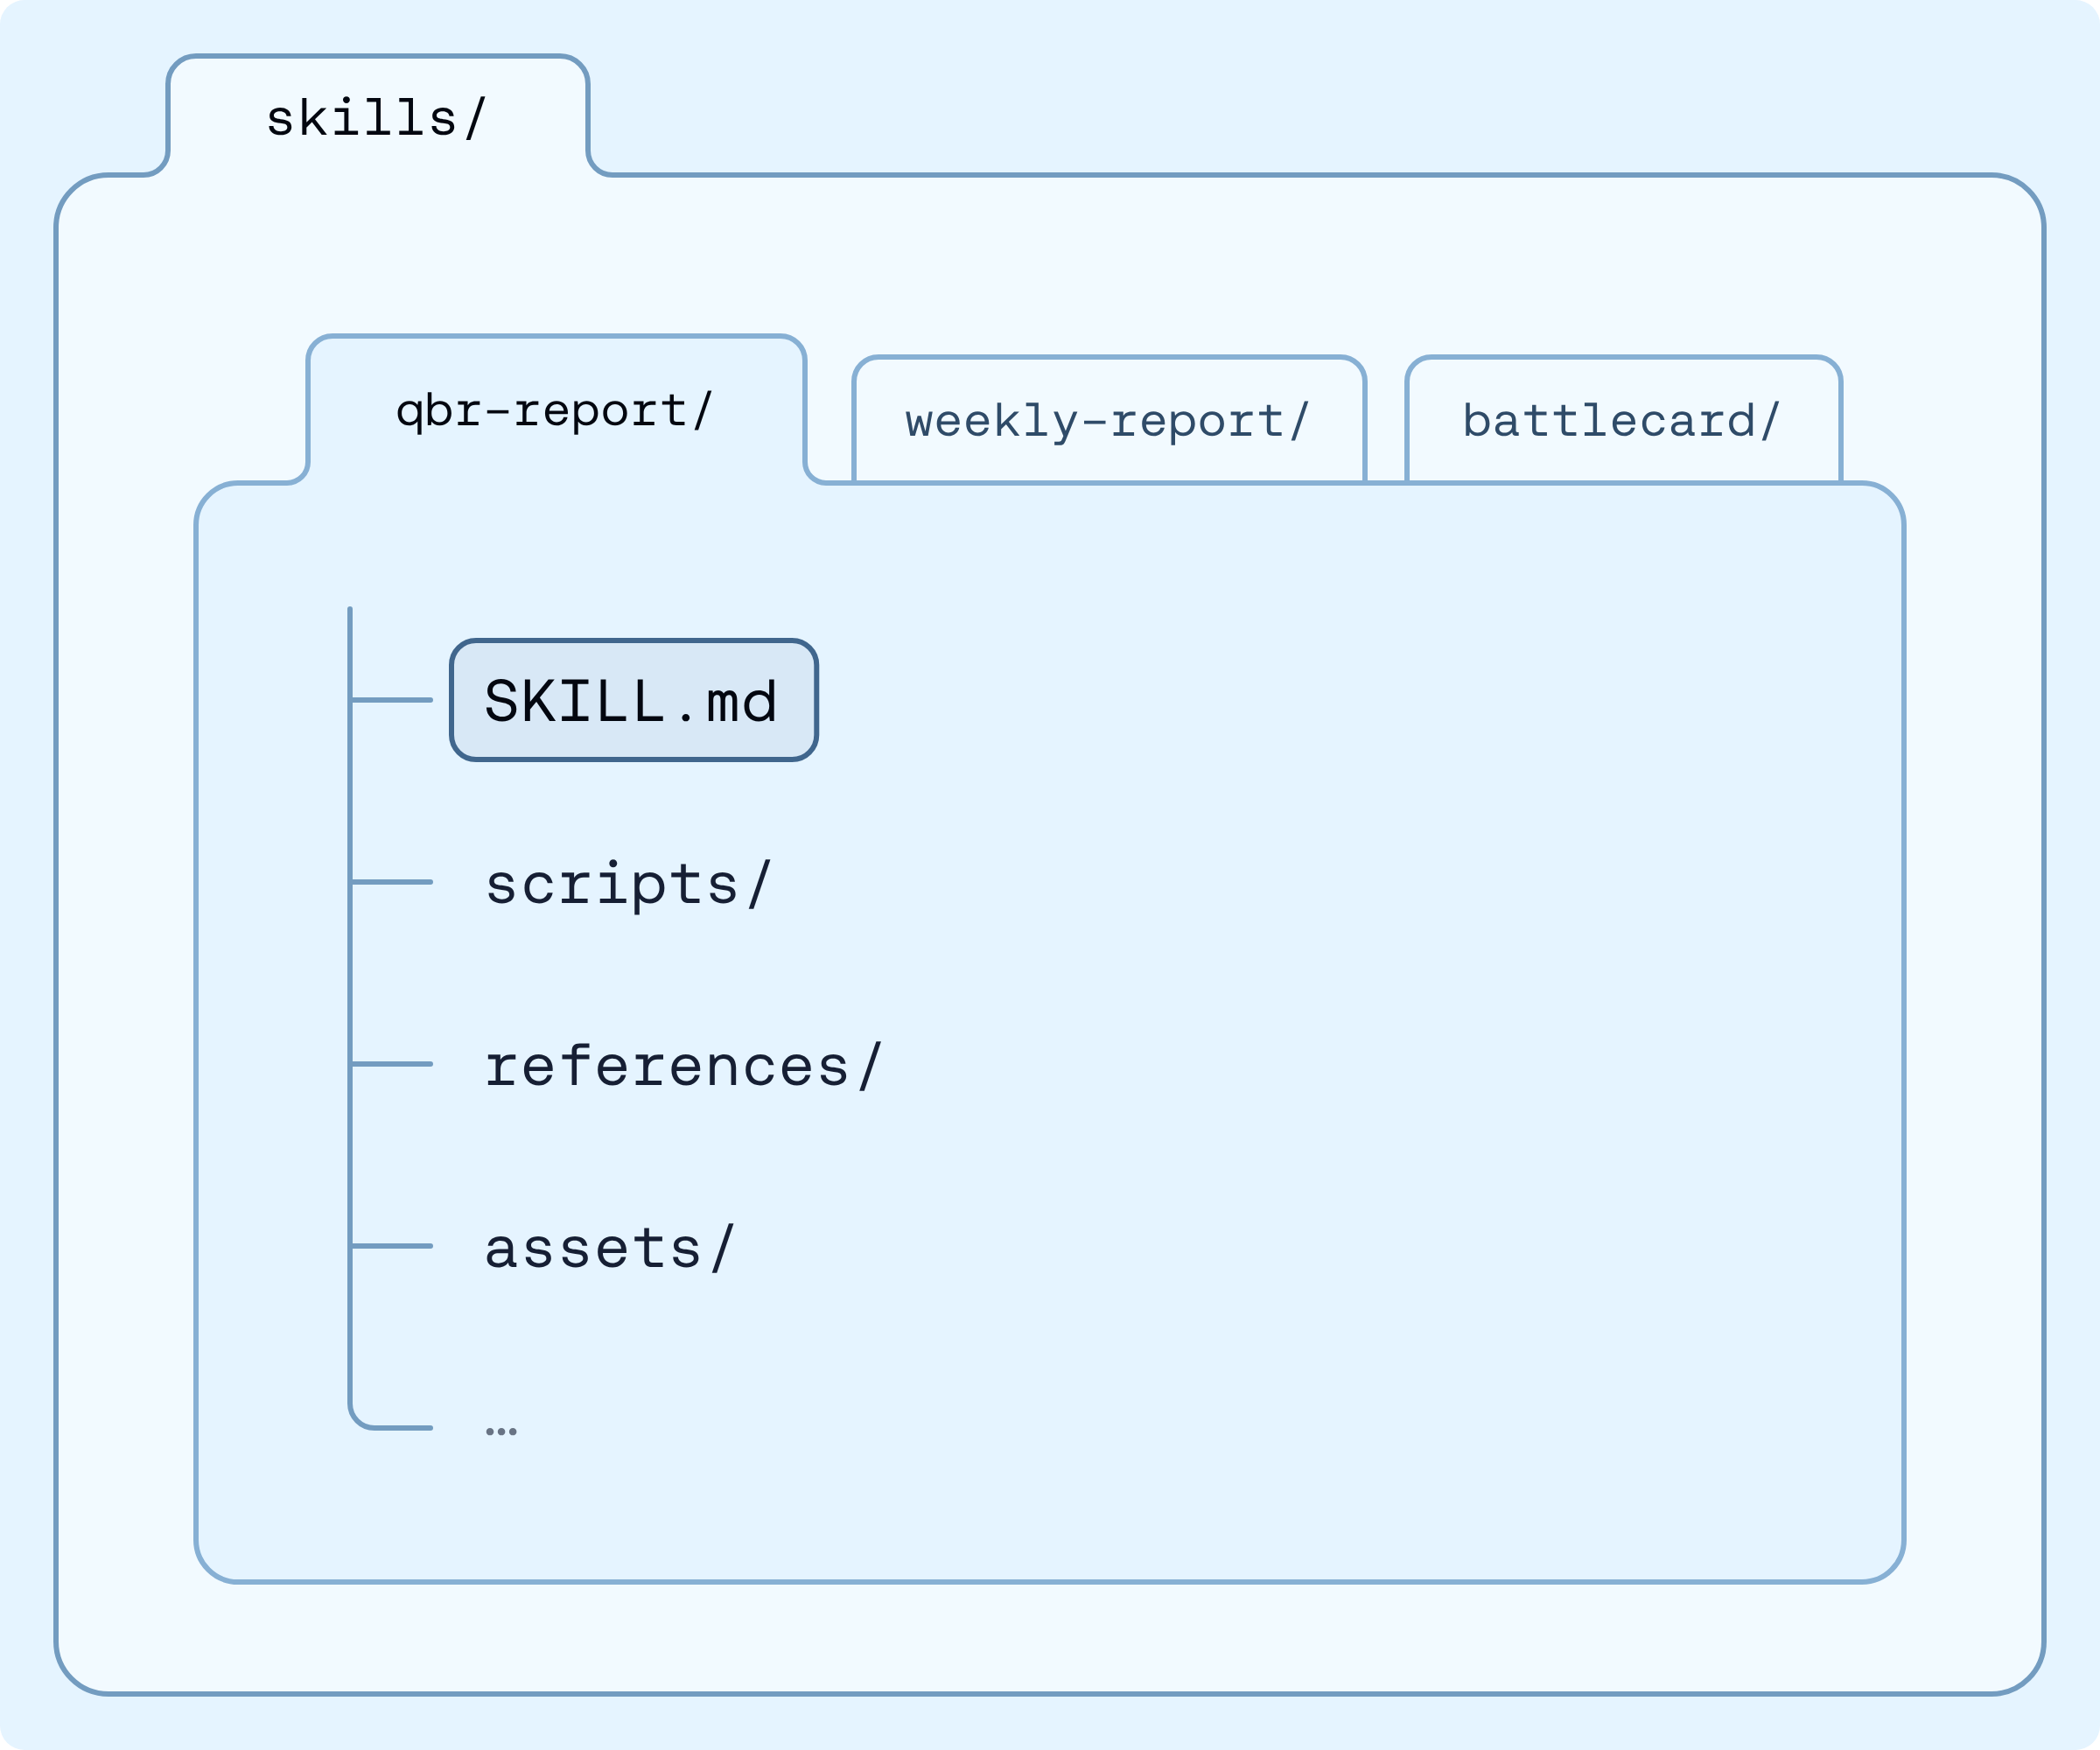
智能体预先只会看到一段简短描述,只有当 QBR 出现时才会加载 qbr-report 的完整说明(其他任务永远不会携带它们)。
技能分层加载上下文,因此在某些内容真正相关之前,上下文窗口保持很小。这被称为渐进式披露(progressive disclosure):模型预先看到一个“菜单”,在需要时再拉取完整“配方”,因此十个技能消耗的上下文大约相当于十条单行说明。
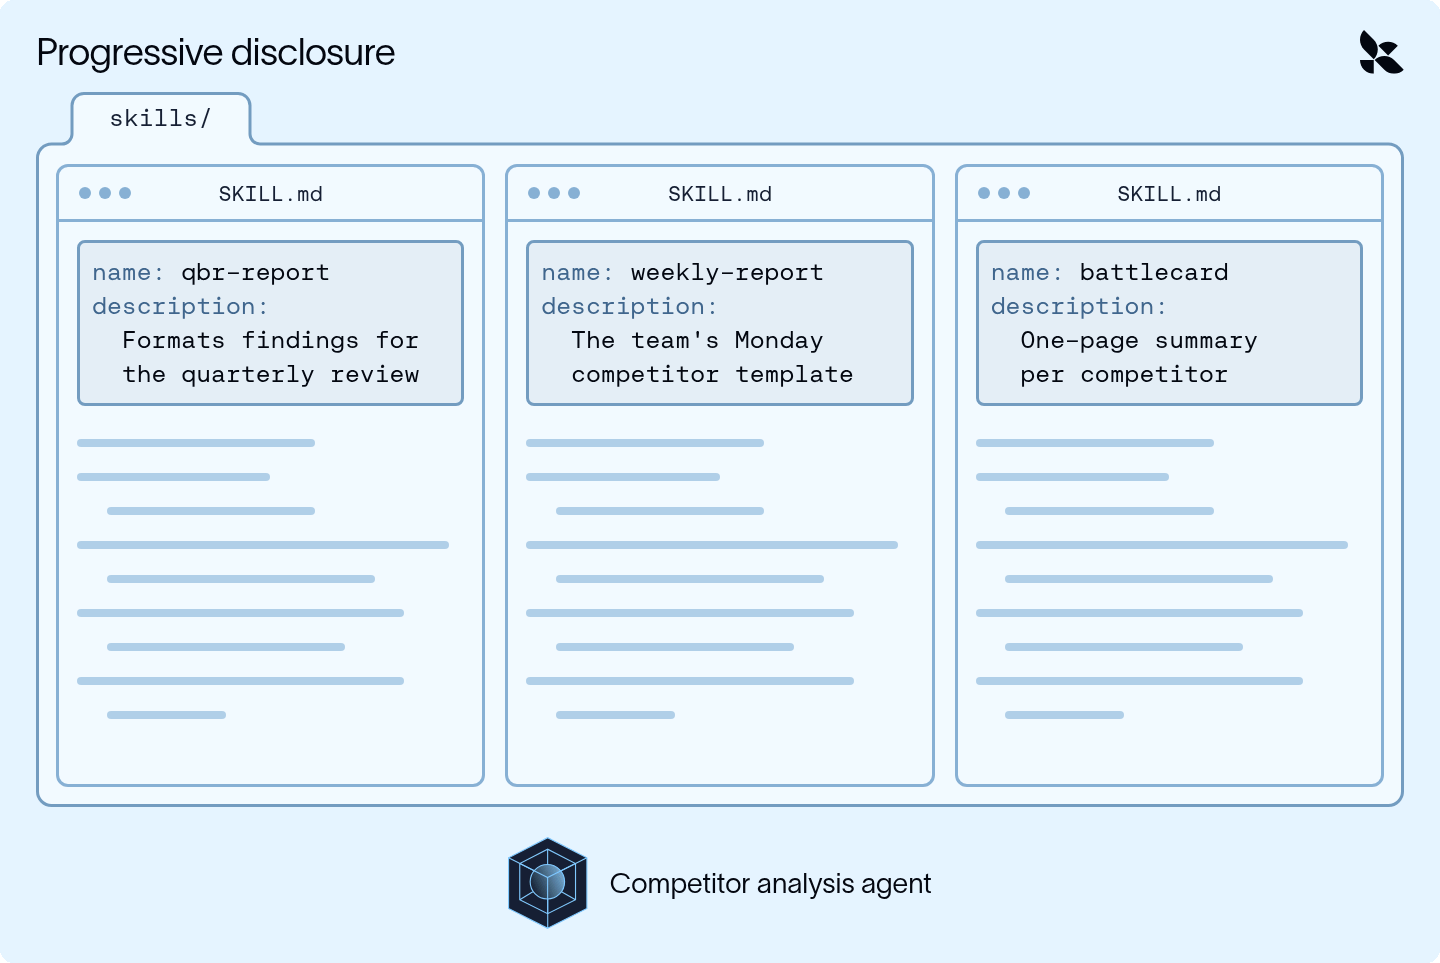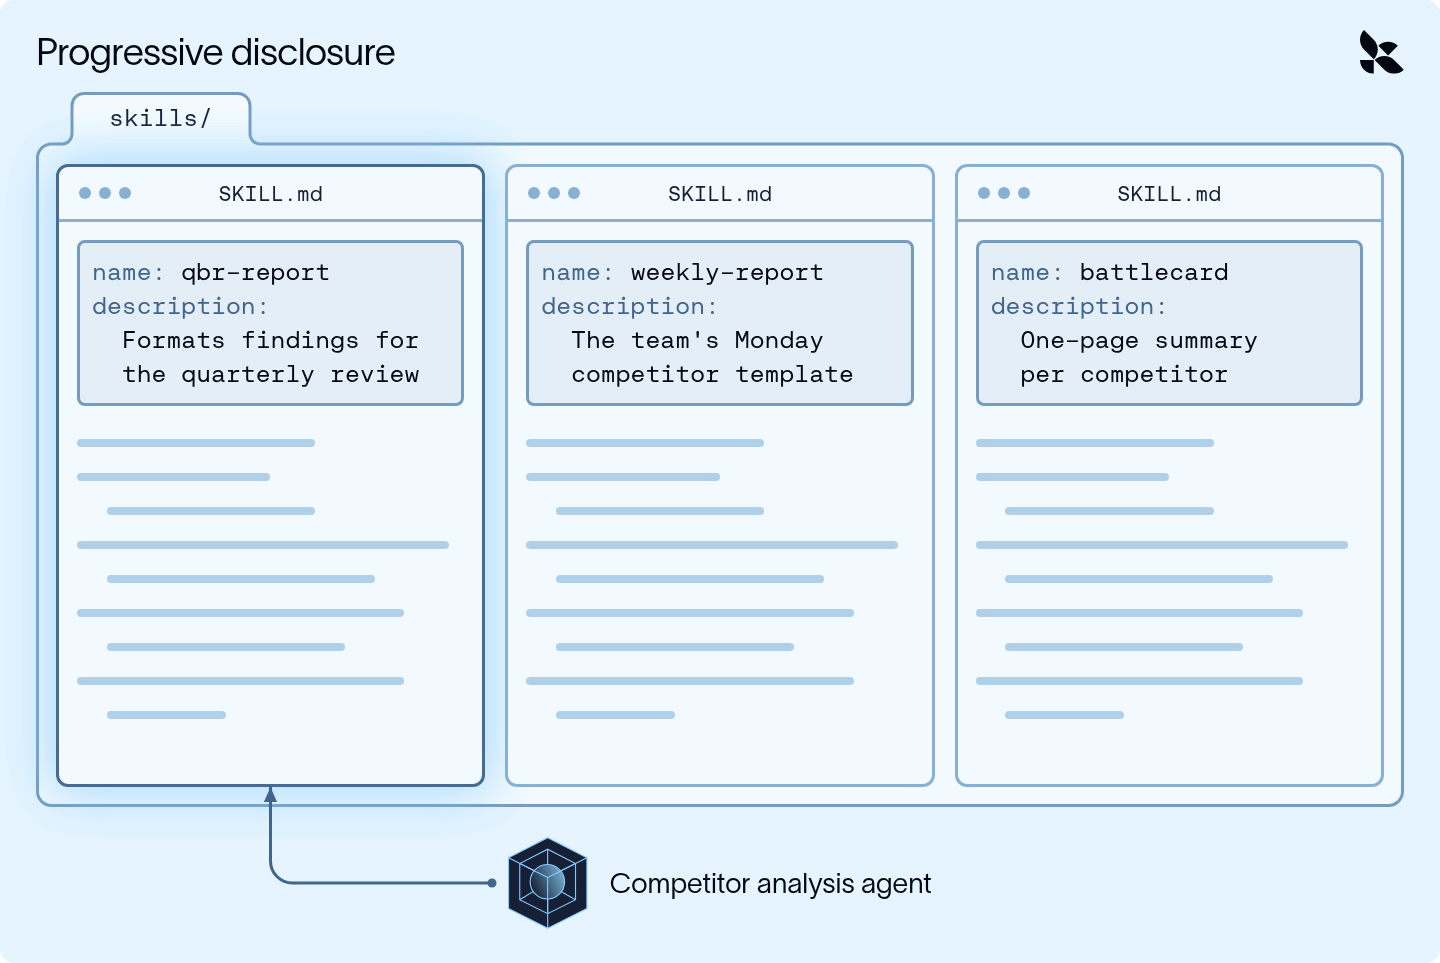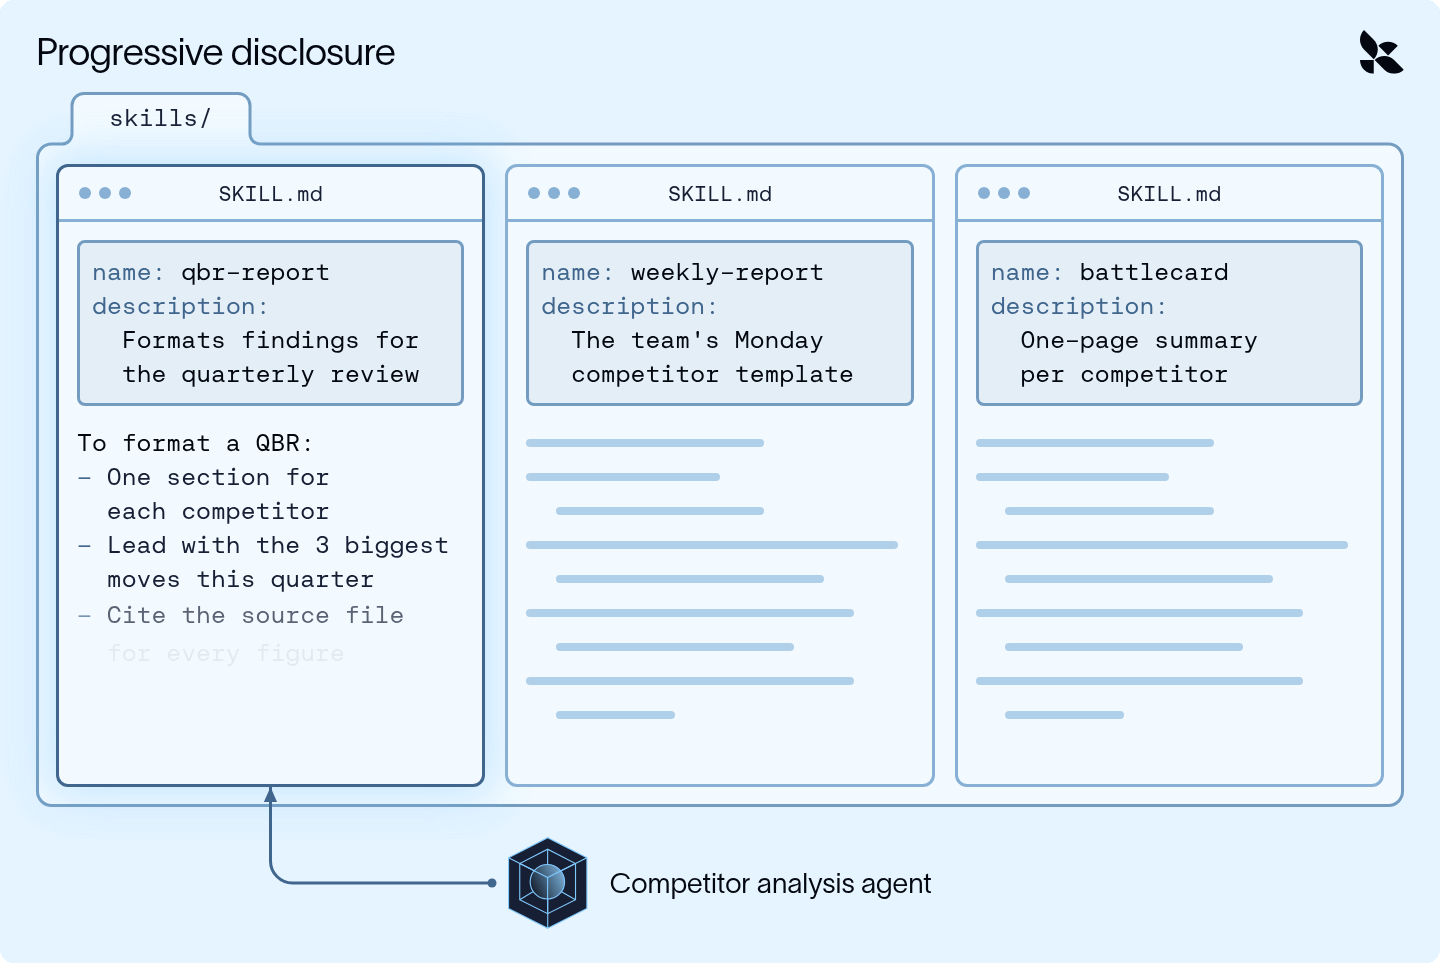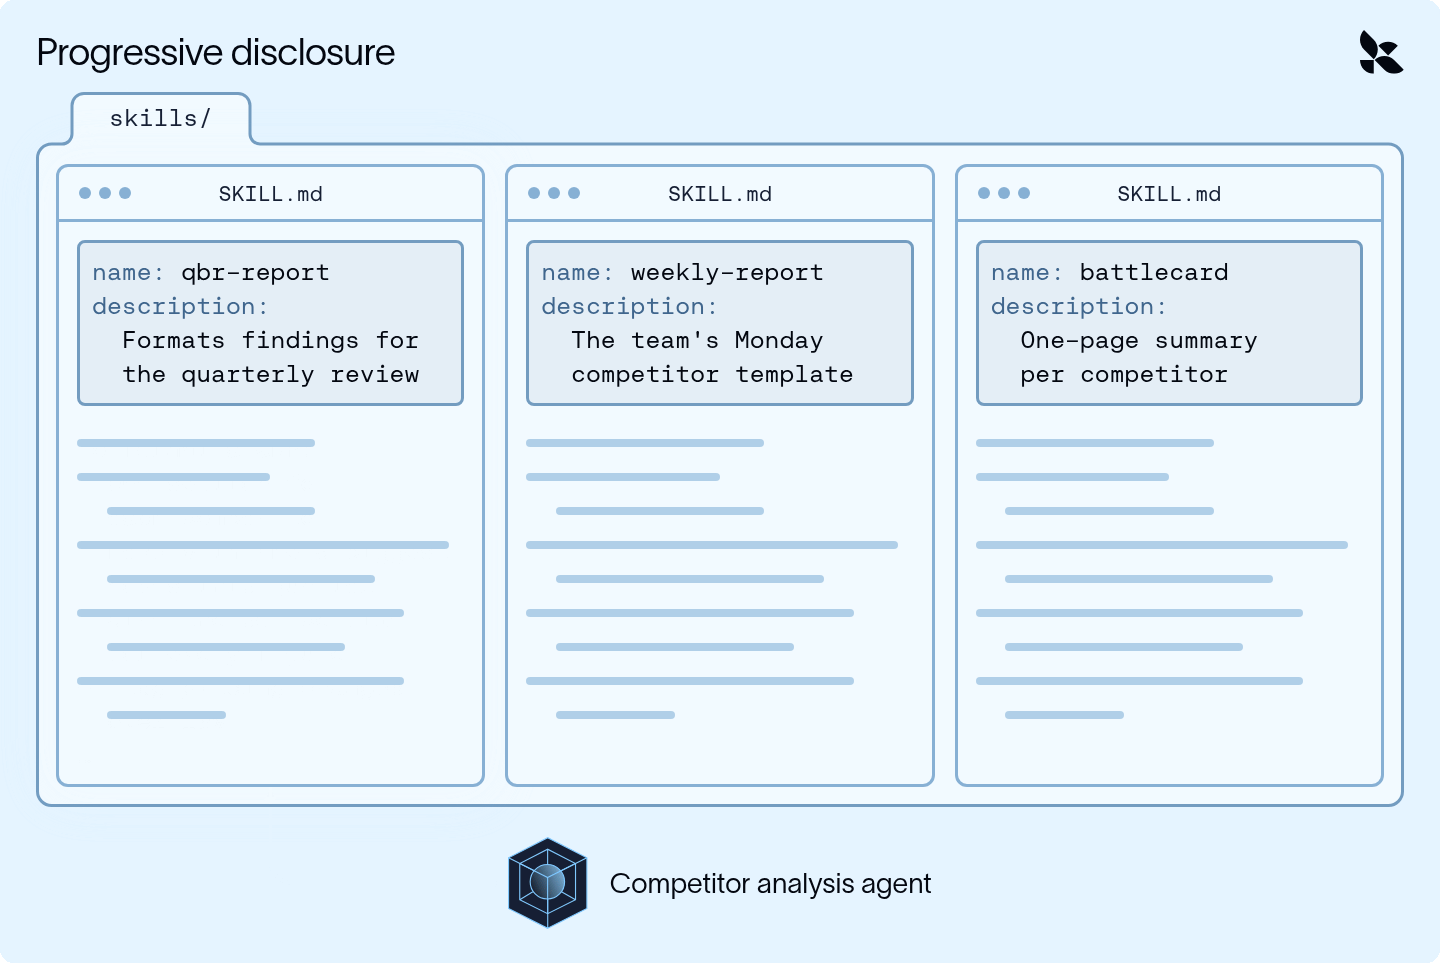
你把智能体指向你的技能文件夹,SkillsMiddleware 会使用两个钩子:
- 在智能体启动之前,它扫描技能文件夹,只读取每个 SKILL.md 的头部。
- 在每次模型调用时,它把这些名称和描述加入系统提示词。
完整说明只有在模型判断某个技能相关时才会进入上下文(并通过 read_file 工具读取),因此我们的智能体在没有模板的情况下进行研究,只在需要格式化 QBR 时才加载它。