作者:Harrison Chase(哈里森·蔡斯)
日期:2026 年 11 月 21 日
阅读时长:6 分钟
返回博客|创建 Agent
要让 AI 真正为你的公司发挥作用,缺的并不是更好的模型,也不只是更多的上下文——真正缺的是更好的知识。这种知识关乎你的公司如何运作、有哪些运营标准、数据存放在哪里以及如何访问。
你最高效的员工之所以高效,是因为这些知识装在他们脑子里。他们知道该找谁、去哪里找答案、为什么某件事要按某种特定方式来做。这些知识往往是隐性的、默会的、零散的——有时只存在于某个人脑中,有时散落在各种文档里。
要让 AI 真正为你的公司发挥作用,你需要收集、整理并维护一份知识的表示,再把它交给 Agent。帮你完成这件事的系统,我们称之为「知识工厂」。
在 LangChain,我们已经用几种方式建起了这样的知识工厂。我们内部的 GTM(Go-To-Market,市场进入)Agent 和内容工作室 Agent 都由知识工厂驱动。LangSmith Engine(我们那个运行在 trace 之上、给出修复建议的 Agent)也会为每个 Agent 维护一个知识工厂。本文分享我们的经验教训。
上下文 vs. 知识
上下文是 Agent 在执行任务时可用的信息。
知识是我们维护的、可复用的理解,让 Agent 能正确地完成该任务:某个指标是什么意思、该信任哪个来源、我们如何处理某种特定情况。知识有时会被写下来,但往往不会。
知识工厂把零散的文档和经验转化为知识,而这些知识可以成为未来工作的上下文。
因此,知识是 Agent 将获得的一种上下文形式,但它往往不是(也不应该是)Agent 获得的唯一上下文。其他类型的上下文你已经在可靠地摄取和存储,可以直接提供给 Agent(见下文关于快速变化数据的部分)。
从软件工厂到知识工厂
过去一年半里,「软件工厂」的概念迅速升温。其理念是:与其让你的顶尖工程师亲自构建软件,不如让他们去构建工厂(即系统),帮助公司里的每个人更高效地构建软件。软件的实际构建工作可以交给 Agent 完成。
如今,一般的知识工作也在走类似的路。Agent 已经足够强大,能做演示文稿、发布视频、做外呼。你应当尽可能利用它们来完成这些任务。但要让它们完成这些任务,它们需要那些隐性的、默会的、零散的知识。
这正是你应该投入资源的地方。你需要构建这些知识,更重要的是构建一个工厂来收集、整理和维护这些知识。只有这样,你才能把更多一般性知识任务外包给 Agent。
知识的组成部分
通常,你需要维护以下几类知识。
- 如何完成工作——技能(Skills)。 按公司期望的方式完成任务所需的流程、指令和脚本。
- 业务如何运作——领域知识(Domain knowledge)。 关于产品、客户、竞争对手和组织的定义、政策与事实。
- 从哪里获取最新信息——数据访问指引(Data access guidance)。 该用哪些数据源、数据存放在哪里,以及如何查询。
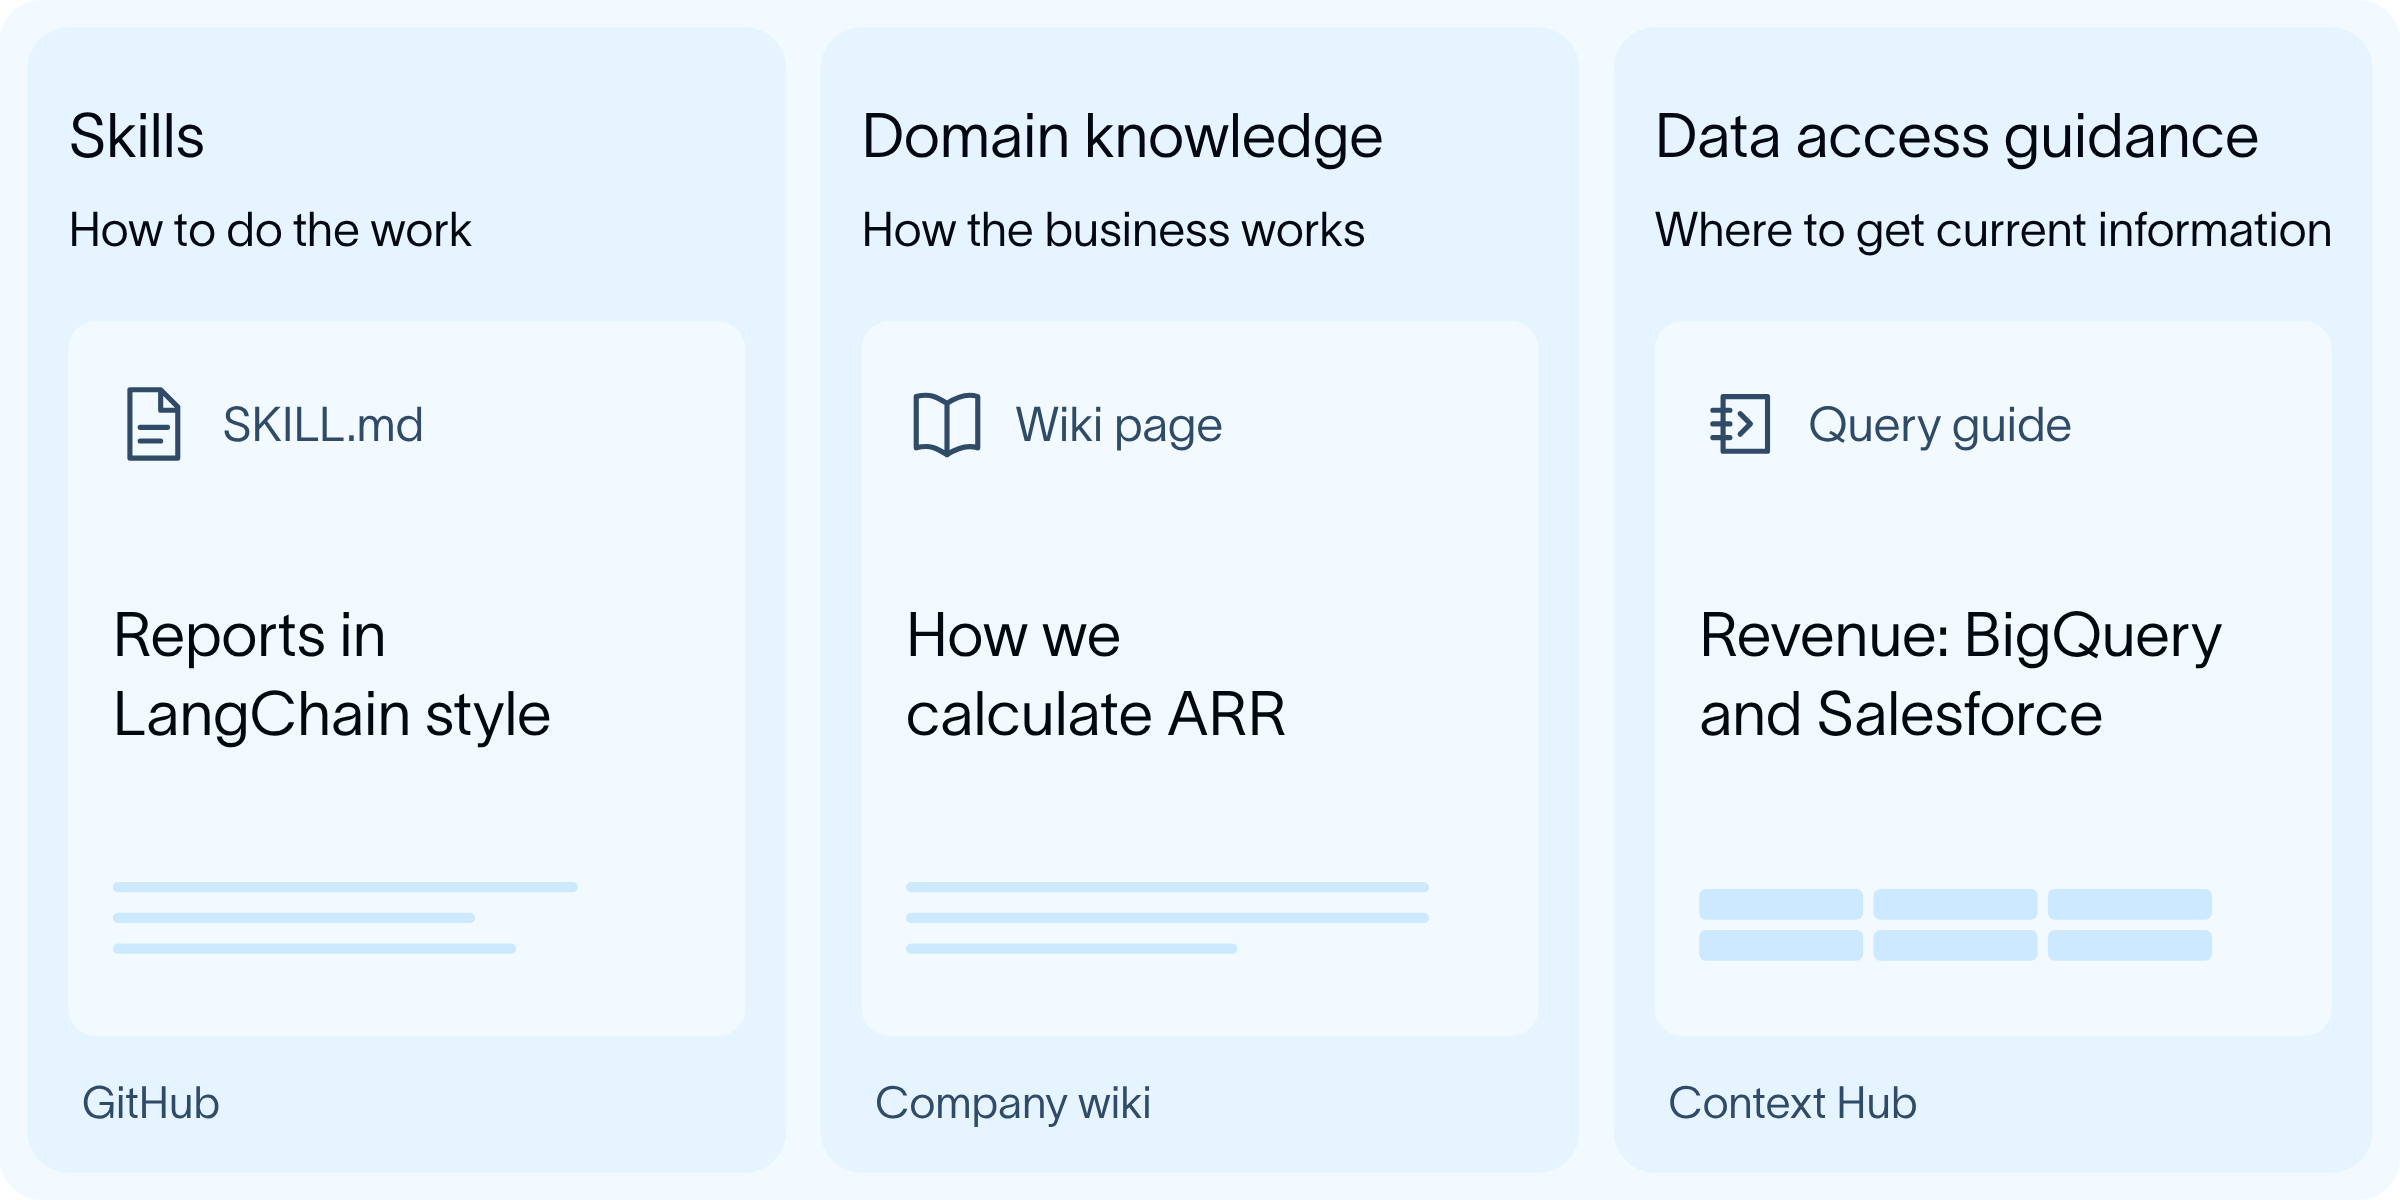
技能(Skills):这是关于在公司内部如何“正确”做事的流程,包括指令和脚本,用来按公司要求的特定方式完成任务。很多时候,这些内容从未被写下来过(而是一代代同事之间口口相传)。你应当努力把它们写下来。
领域知识(Domain knowledge):这是不容易频繁过时的知识,通常是关于人员、产品、竞争对手的核心信息。这类信息往往已经被写下来过——但通常并不完整(甚至不正确),仅仅是因为这里的知识量实在太大。
数据访问指引(Data access guidance):你应当有一套良好的数据策略(如 Snowflake、Databricks 等),这是让智能体真正有用的基础。如果数据的权威来源已经在那里,并且完整且保持最新,就无需再维护一份单独的副本。相反,你需要新维护的,是关于数据存放在哪里以及如何查询它的清晰指引。
知识工厂的组成部分
要让智能体真正有用,上述所有信息都是必需的。不要试图手动维护它们,那是一项极其艰巨的工程。相反,你需要建立一个用于维护这些信息的系统。总体而言,这套系统的组成部分如下:
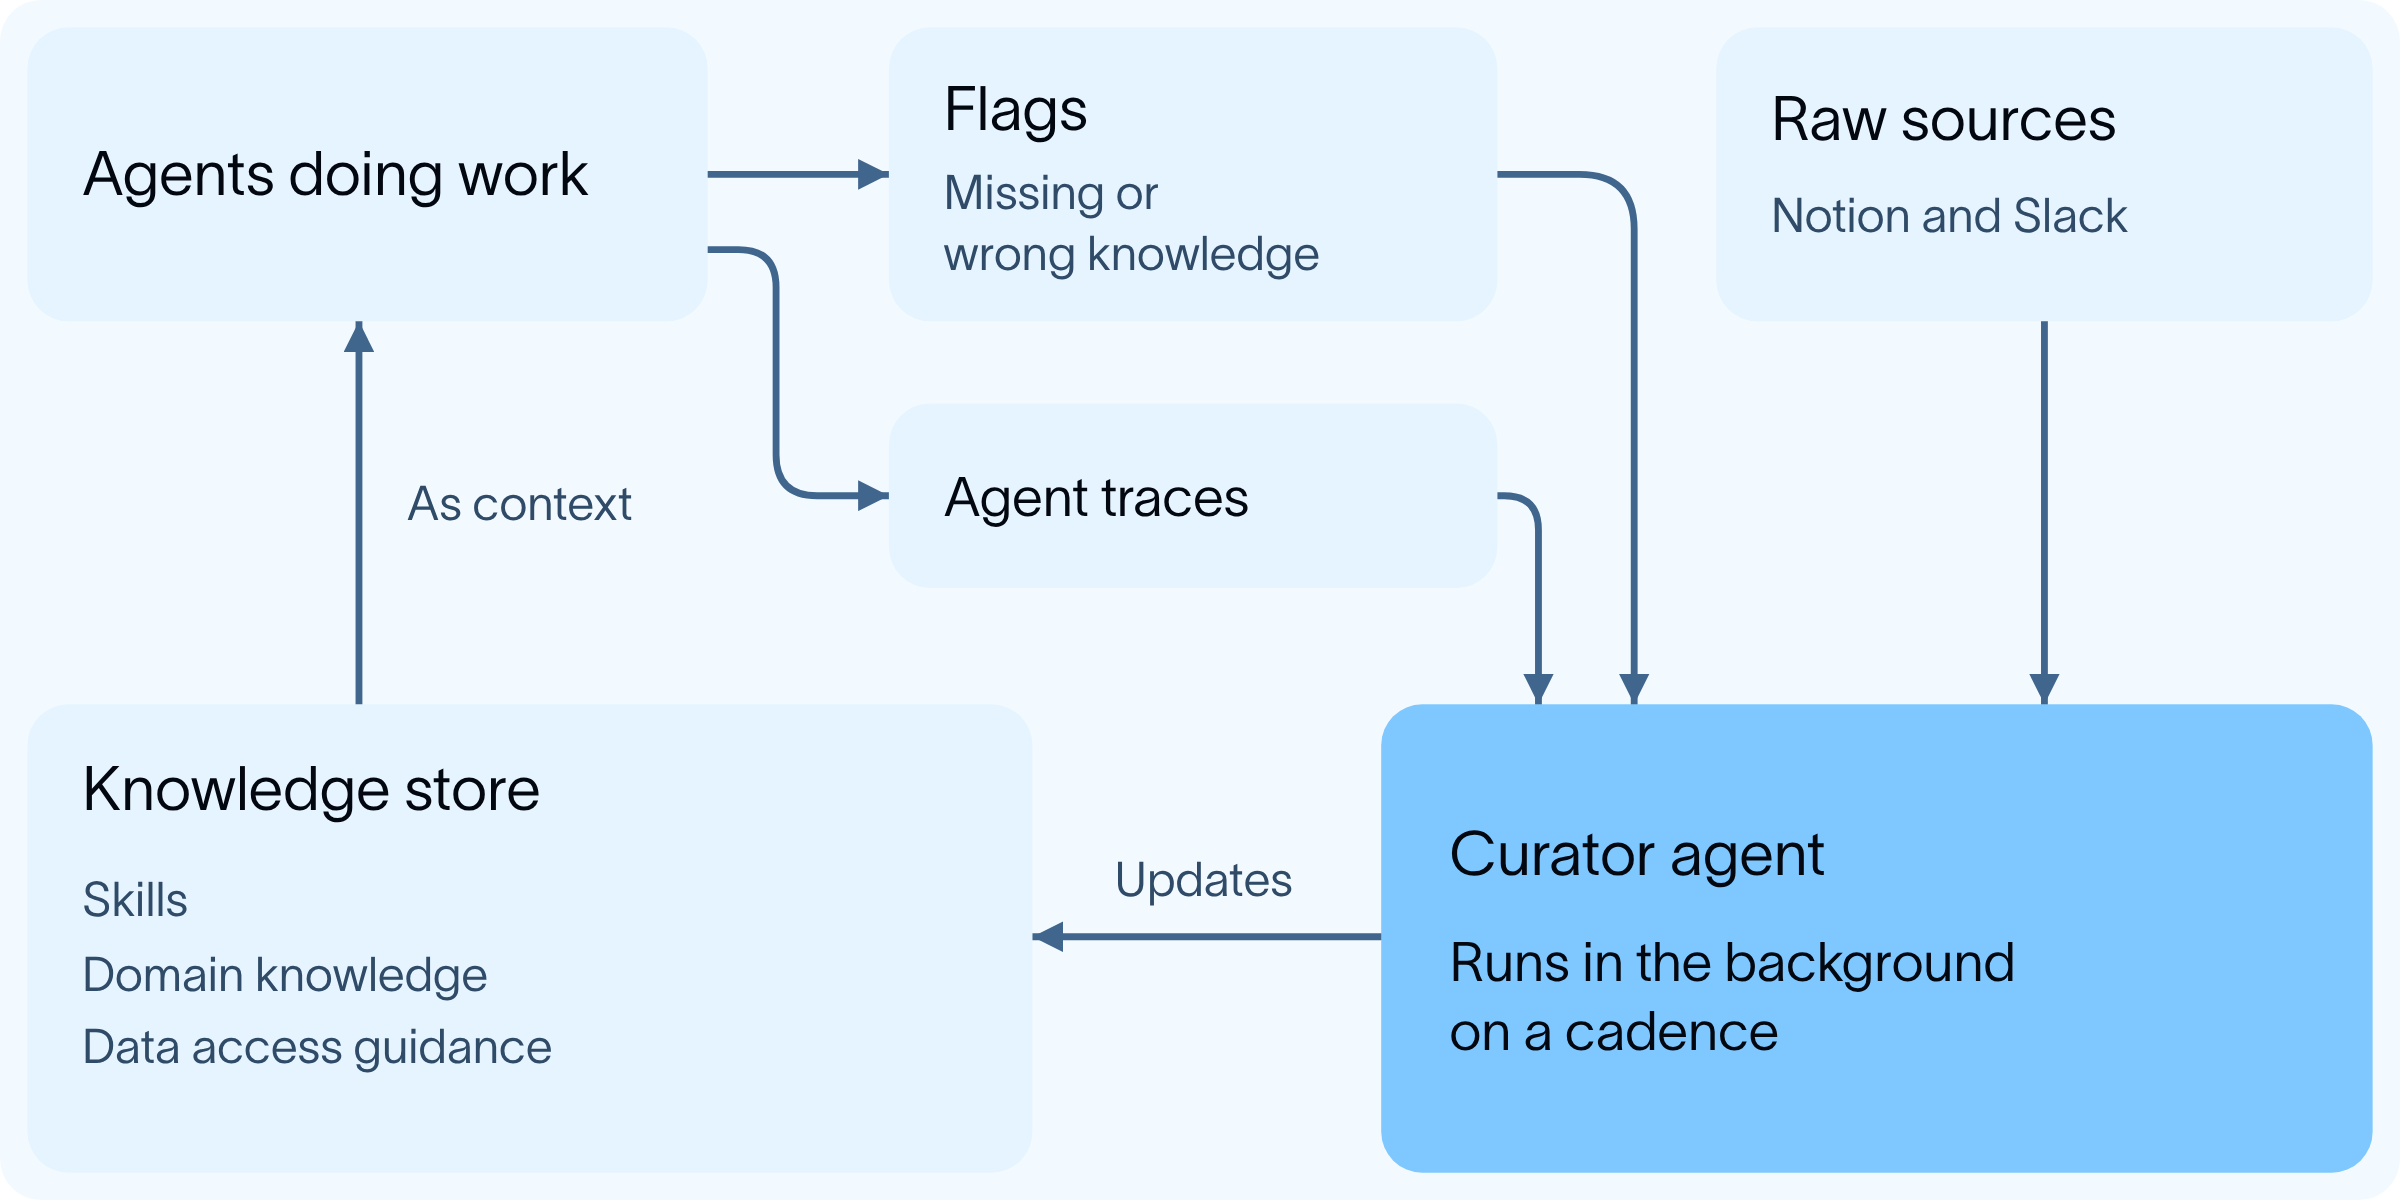
让智能体标记缺失知识的方式:了解哪些知识片段缺失的最佳方式之一,是让智能体在工作过程中主动标记出来。如果它们被要求做某件事,却找不到相关信息,或者发现找到的信息有误,就应当标记出来!给智能体提供一个工具,至少要能报告哪里有问题,并可选地建议正确的更新内容。
策展智能体:负责更新、策展和维护这些知识的智能体:这些知识不应靠人工保持最新,工作量太大。也不应仅由使用这些知识的智能体来维护更新:它们擅长标记错误或缺失之处,但修复这些问题需要深入理解底层知识及其他数据来源。如果让那些主要忙于完成自身目标的智能体去妥善更新和维护这些知识,知识库就会变得混乱且充满矛盾。相反,你需要一个在后台运行、按某种节奏(on some cadence)更新这些知识的策展智能体。它应当有权访问所有原始数据源(Notion、Slack 等),这些知识可能分散在这些地方;它应当有权访问智能体追踪记录(agent traces),从而了解人们如何使用智能体,并将其固化为技能;它还应当有权访问智能体标记为错误的内容(即上一节所述内容)。
知识的存储:在某些方面,这其实是最不重要的部分。你可以把这些知识以技能格式存储在 GitHub 中,也可以放在 Notion 的单个文件里,或以 OKF 格式存储在 LangSmith Context Hub 中,还可以存入 Neo4j 的知识图谱里。策展智能体应当知道如何与所有这些格式交互(这并不难)。从另一些方面看,这又是探索最少的领域。记忆(memory)该如何表示?作为行业,我们已经在“程序性记忆”上趋于采用技能的形式。对于更多的语义记忆,很可能会出现另一种标准(OKF?)。现在为时尚早,尚无标准出现,因此最好不要对这个格式规定得过于死板,也不要把它搞得过于复杂。
整合起来
最后,用一个端到端的例子来收尾:一个 agent 正在准备一份收入报告。
agent 会需要一些基础上下文:原始收入数据,存储在 BigQuery 和 Salesforce 中。
然后是知识。知识可能由几种不同类型组成:
- 技能:如何以 LangChain 风格创建报告。这些技能以标准技能格式存储在 GitHub 中。
- 长期知识:我们计算 ARR 的方式。这些知识存储在公司的 wiki 中。
- 如何访问快速变化的知识:如何访问 BigQuery/Salesforce 中的原始数据。这些同样以技能形式存储,但这次是在 Context Hub 中。
agent 开始运行。它可能注意到我们在 BigQuery 中重命名了某一列。它即时推断出正确的列名。它使用自己拥有的工具来上报问题、标记这一点,并建议正确的列名。
在它创建报告之后,我们的财务负责人与 agent 同步协作,修复了一些格式问题,包括告诉它使用我们现在需要用于所有 LangChain 文档的新标题。
当晚,curator agent 看到了被标记的问题。它还检查了 agent 的追踪记录,注意到与我们的财务负责人之间的这轮来回沟通。它相应地更新了相关技能(在获取数据时使用新列,在起草报告时使用新标题)。
