

表现最强的 AI Agent 挑战赛作品背后的 4 种工程模式
2026 年 9 月 2 日 Sergio Villani Google Cloud AI 技术解决方案 分享

我们刚刚结束了 Google for Startups AI Agents Challenge(Google for Startups AI Agent 挑战赛),全球数千名开发者提交了自己的 Agent 作品。我们的评审团按三条赛道为参赛作品打分。
在所有提交作品中,“多智能体系统”大概是最常见的说法;但细看之下,其中一些的确是真正复杂的多 Agent 解决方案,而另一些其实只是一个模型在用一连串提示词工作,只是给各个步骤贴上了 Agent 的名字而已。
纵观这个光谱,那些在每条赛道上真正名列前茅的作品,反复呈现出同样几种工程决策与模式。下面这四种值得你在自己的项目中借鉴。它们来自真实的代码提交,为避免针对任何单一团队,这里不署名介绍:
- 双向 MCP(Model Context Protocol,模型上下文协议): Agent 既是自身工具的客户端,也是其他 Agent 可以调用的服务端。
- 事件驱动并发: Agent 并行响应同一共享信号,而不是在调用链中相互等待。
- 同标准回退(Same-bar fallback): 在主模型过载时,由一个更小的模型接替,且不降低质量校验标准。
- 分层路由: 先运行廉价且确定性的检查,再让模型介入。
模式一:你为自己构建的工具,同样可以服务其他智能体
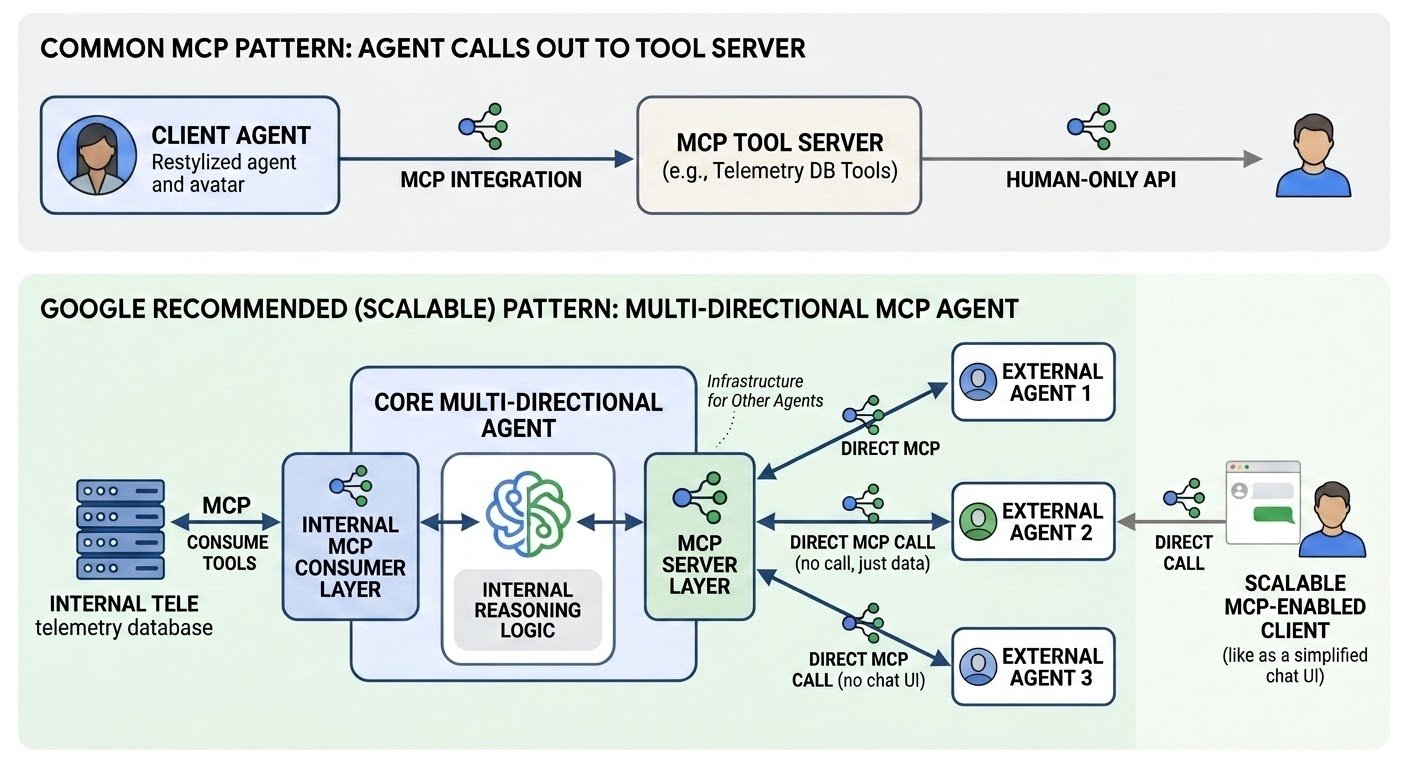
大多数参赛作品只用了 MCP(Model Context Protocol,模型上下文协议)的一个方向:智能体向外部工具服务器请求数据。然而有一支团队把 MCP 的使用扩展到了两个方向。他们的智能体在内部通过自己的 MCP 工具层来访问遥测数据库,然后又将这同一套推理能力以 MCP 服务器的形式对外暴露,让另一个智能体可以直接向它提问,完全不需要为人类构建聊天界面。
在谈到对外暴露那一半之前,内部这一半本身就很有意义。一个朴素版本的智能体会直接对遥测数据库执行 SQL 查询,然后把所有行一股脑塞进模型的上下文里——而在真实的生产数据库上,这恰恰就是单次请求把 token 预算打爆的原因。而通过 MCP 工具层,智能体可以程序化地检查和过滤数据,只取回一个任务的执行计划或某一条具体的堆栈跟踪,而不是整张表,这样上下文就小到足够拿来推理。把数据库访问交给工具来中介,而不是直接暴露裸连接,也正是让这种模式中"对外暴露"那一半成为可能的前提。一个只返回有界、定制化答案的工具,交给一个你无法控制的调用者是安全的;而一个裸的 SQL 连接,无论如何都不能这么做。
正是这个决定改变了产品本身的形态。一旦智能体自己的推理已经处在工具接口之后,对外暴露它就只是在这套工具前面再起一个 MCP 服务器。在这个案例里,这意味着在终端或 IDE 中工作的编码智能体可以直接调用这个性能智能体,询问某个具体任务的情况,就像调用任何其他工具一样。人类不必打开仪表盘、在聊天框里描述问题、再把答案复制回自己的工作流。聊天界面是一个终点,而 MCP 服务器可以成为其他智能体赖以构建的基础设施,无需任何人为它们写第二次集成。
容易忽略的部分是:一旦你在为一个你无法控制的调用者提供服务,这个服务器就需要真正的访问控制。任何能访问到它的人,现在都可以直接调用你的推理层。一个只供你自己智能体调用的工具接口不需要考虑这些;而一个对外开放调用的工具接口则必须考虑。
今天就可以这样做: 如果你的智能体已经在内部通过 MCP 与自己的数据交互,不妨先评估一下,把这些工具对外暴露需要多少额外工作量,再决定是否去构建一个功能重复的、只面向人类的 API。
模式二:让智能体并行响应同一事件
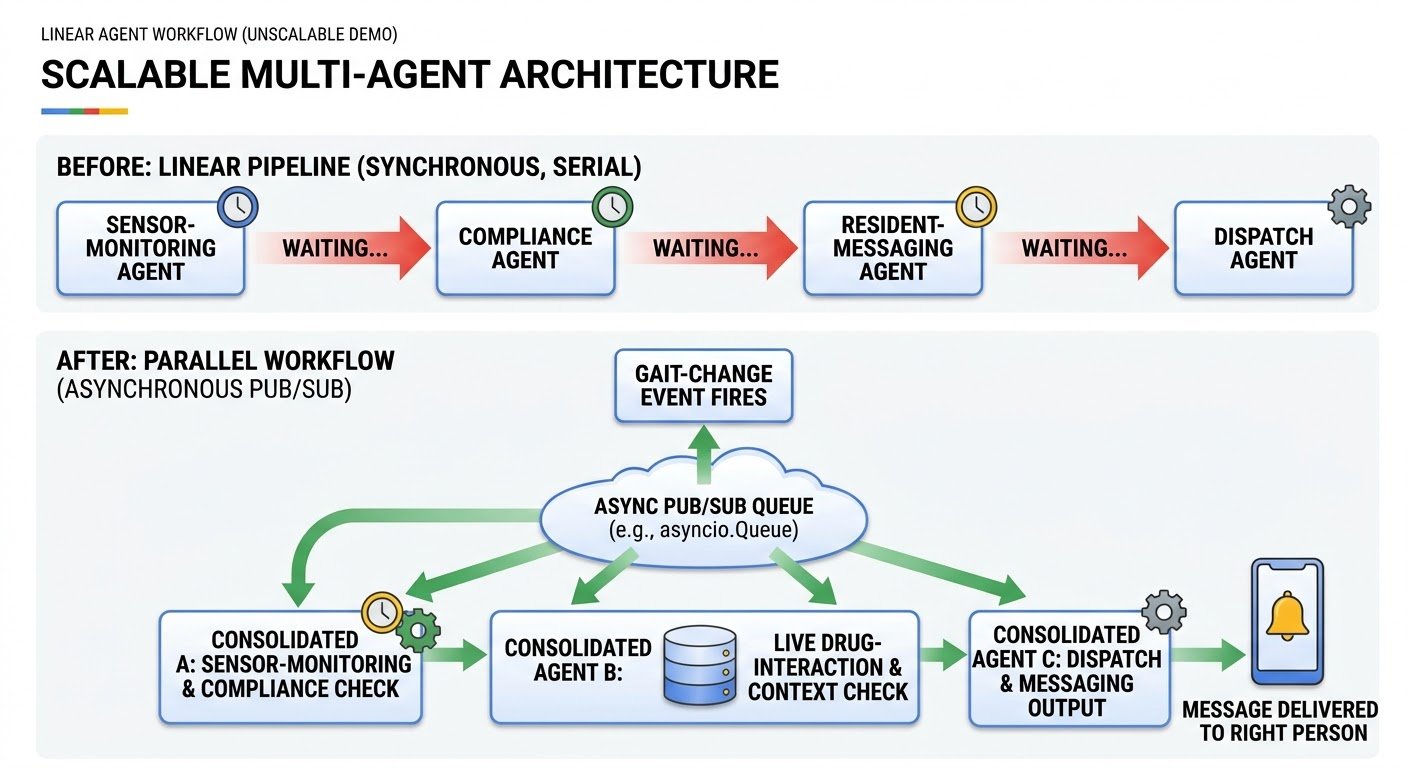
有一支队伍的初版方案是一条线性流水线:一个负责传感器监测的智能体调用合规智能体,合规智能体再调用住户消息智能体,最后由消息智能体调用调度智能体。作为演示它跑得很顺,但放到真实业务场景里就垮了——要在步态变化中识别跌倒风险,实时交叉比对药物相互作用数据库,并在可干预的窗口关闭之前把消息送到对的人手上。
解决办法是一条基于事件总线的异步架构,底层由四个独立的 asyncio.Queue 实例组成,每个智能体一个,每个队列都有自己的工作协程从中拉取任务。智能体不再由 A 同步调用 B 并等待返回值,而是向具名主题发布带类型的事件,并订阅自己关心的主题。一次步态速度下降达到或超过 15% 时,就发布一条 CLINICAL.ANOMALY_DETECTED(临床异常检测)事件。合规智能体早已驻留在该主题上,因此事件一触发它立刻接收,交叉比对药物相互作用数据库,并在处理完成的瞬间发布自己的 CLINICAL.COMPLIANCE_REPORT_READY(合规报告已就绪)事件——既不是按轮询间隔在跑,也不依赖上游显式交接。消息与调度智能体在下游同样按此方式工作,每一个都由它所订阅的主题唤醒,而不是被前一个执行者的显式调用唤醒。
这正是调用链与事件总线之间真正的差异:在调用链中,总时延是累加的,智能体一的时间加上智能体二的,再加上智能体三的,因为每个环节都把整条调用栈占着,在等下一个返回;而在基于主题的总线上,彼此不依赖输出的两个智能体会真正同时运行,因为没有任何一方在阻塞等待另一方的返回。只要你的智能体各自的工作节奏本就不同——一个每隔几秒轮询一次,一个发起一次网络调用要花半秒,还有一个只在最末端触发一次——就该采用这种形态。把这些环节统统串进同一个调用栈里,再快的智能体也会被最慢的那一环拖住。
今天就可以做的检查: 看看你系统中是否有两个智能体需要响应同一个信号。如果现有架构让其中一个必须等另一个完成后才能行动,那就是一个披着多智能体外衣的单线程系统。
模式 3:备用模型同样必须达到你的质量门槛
另一支团队的临床推理智能体运行在 Gemini 3.1 Pro 上。在真实负载下,Pro 开始返回 503 错误。大多数参赛作品的做法是给同一个模型加一个重试循环,然后就此打住。但这支团队不同:他们构建了一个带退避策略的备用方案,回退到 Gemini 3.6 Flash,并且无论来自哪个模型的响应,都必须经过同一套校验函数才会被采纳——具体来说,是一个引用检查,用于确认答案确实引用了某个真实的临床指南,而不仅仅是听起来像医学语言的可信表述。
这里真正值得借鉴的细节不在于「存在一个备用方案」,而在于校验逻辑放在哪里。它并没有在主路径上复制一份,又在备用路径上复制一份——那样很容易更新其中一份却忘了更新另一份。代码里只有一个 validate_clinical_response() 函数,Pro 路径和 Flash 路径都被强制要求调用它,响应才能离开这个智能体。一旦一个响应进入这个函数,无论它是由哪个模型生成的,谁都没有捷径可走,也没有任何一个模型能够仅仅因为恰好在请求到来时可用,就把一份未通过校验的答案放行出去。
这才是真正能够防止「备用方案悄悄拉低你的质量门槛」的做法:不是记得把同一套标准应用两次,而是让它在结构上不可能只应用一次。
今天就可以这样做: 找到你的代码中备用方案触发之后执行的那条路径。如果它跳过了主路径上某个校验步骤,那你其实是在同时交付两套不同的产品,却只测试了其中一套。
