

2026 年 8 月 13 日 分享

HeyGen 是一个以虚拟人(avatar)模型为特色的 AI 视频生成平台。Avatar IV 是其背后用于生成"会说话的头像"视频的扩散模型栈,参数量超过 180 亿,可通过网页端和 API 使用。 我们与 Google Cloud 专业的 AI 基础设施性能优化团队合作,将 Avatar IV 迁移到一台搭载八颗 Trillium(v6e)芯片的主机上,使其相对首个可运行版本提速 1.86 倍。
视频流不会等待。Avatar IV 以分块(chunk)方式逐段渲染"会说话的头像"视频,一旦某个分块迟到,视频就会卡顿。我们所做的每一项优化,都是围绕这条死线展开的。借助 Google Cloud 团队的支持,我们将整条流水线迁移到一台搭载八颗 Trillium(v6e)芯片的主机上,并使其相对首个可运行版本提速近一倍,而所有改动都通过了相同的画质质量门禁。整个工作被三道"墙"框定了方向:网格中暴露的 all-to-all 集合通信、稀疏注意力网格中的部分块(partial block),以及 softmax 内层循环中的串行依赖。本文将依次讲解这三道墙,以及支撑它们的编译器契约与质量门禁。
工作负载与迁移过程
Avatar IV 的输入是一张静态照片与一段音频,输出则是一个会说话、有动作的人物形象。在产品内部,每个视频分块由三个模型依次接力:一个扩散 Transformer 根据音频条件生成运动,另一个 Transformer 对其进行超分放大,再由 VAE 解码器将潜变量转换为像素。最终输出为 720p 或 1080p、25fps 的视频,并按分块完成的顺序流式播放——后续分块仍在渲染时,播放就已经开始。
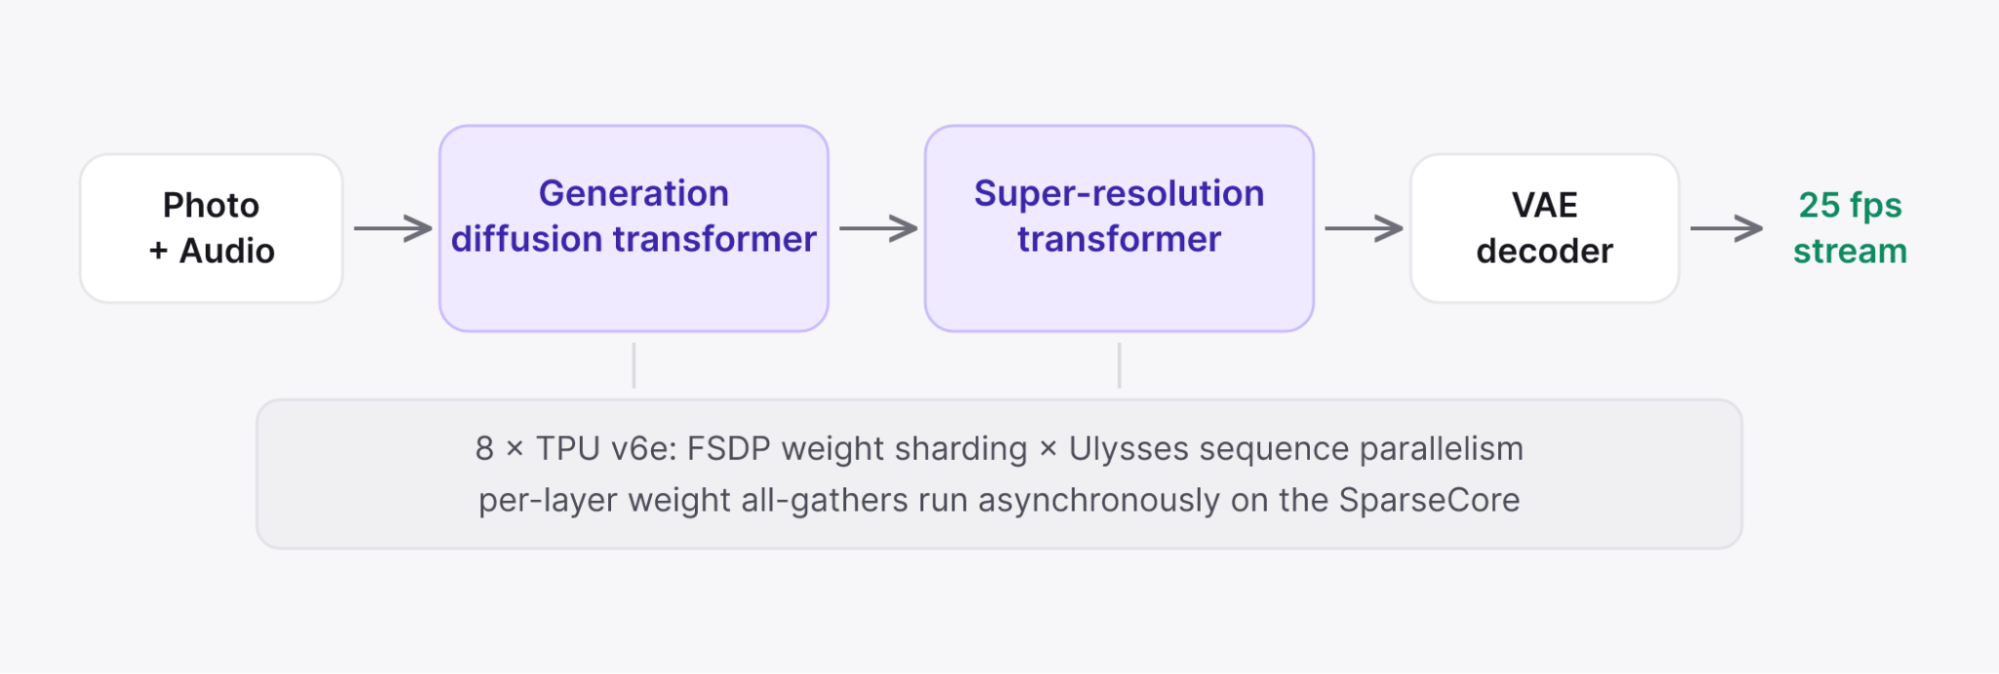
Avatar IV 在一台 Trillium 主机上的流水线。两个扩散 Transformer 与一个 VAE 解码器在每个分块上轮流工作。权重采用 FSDP(Fully Sharded Data Parallel,全分片数据并行)切分,序列则采用 Ulysses 序列并行切分,二者共同分布在同一组八芯片网格上。
Avatar IV 的最初版本是为 GPU 编写的,周围的生态系统也是如此。本次迁移借助 torchax——一个运行在 JAX 之上的 PyTorch 前端——完成:生产环境中的模型代码无需修改,即可被分发到 JAX 数组上,并由 XLA 编译器进行编译。同一份模型代码现在可以同时面向两套硬件栈运行,而 TPU 相关的工程改造则集中在硬件差异所在之处。流水线中每一种注意力变体,都会根据其张量形状分派到专门的 Pallas(TPU 上的内核编程语言)内核上。我们也评估过完全用原生 JAX 重写能带来多少收益。结论是几乎为零:无论前端如何,XLA 都会对整条流水线进行端到端编译,前端的成本只在追踪(trace)阶段一次性付出。
并行策略是被算术约束逼出来的。两个 Transformer 的 bf16(16 位脑浮点)权重合计超过 36 GB,而单颗 Trillium 芯片仅有 32 GB HBM(高带宽内存),因此权重必须在八颗芯片之间做 FSDP 切分。Trillium 的 SparseCore(稀疏计算核心,一种与主核并行运行的协处理器)异步地完成每一层的权重收集。在生产环境的性能采样中,这些收集操作完全隐藏在计算背后:在协处理器上执行权重收集,从物理上把矩阵单元从权重搬运中解放出来,因此由内存容量逼出来的切分,在关键路径上几乎没有代价。Ulysses 序列并行与权重切分叠加在同一张网格上,对视频序列本身进行切分。
六个里程碑
切分策略在第一个可运行版本中就已定型。此后所有的工作都集中在内核与编译器层面,每一项改动落地时,我们都会记录每个分块的耗时。下图按六个里程碑呈现这份记录:
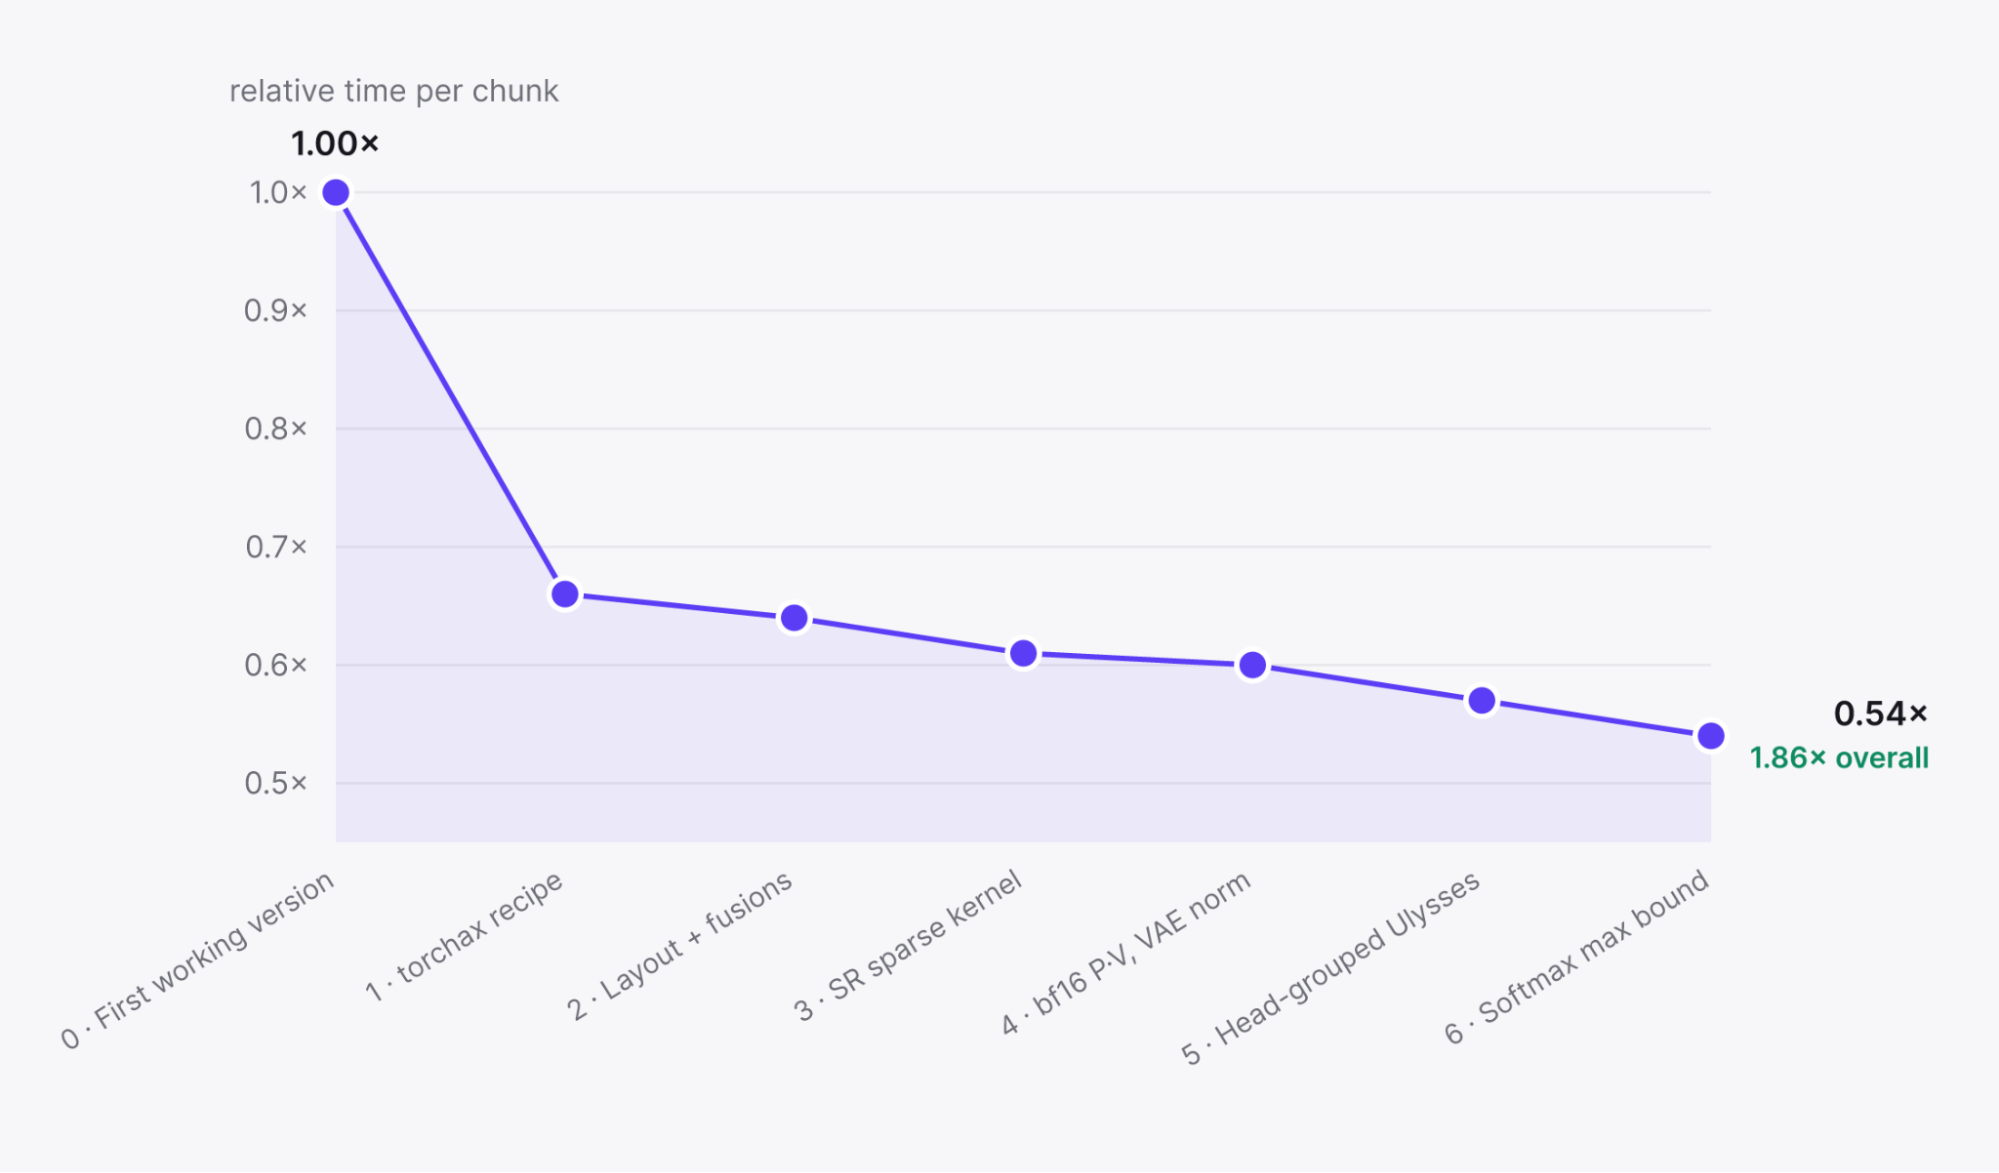
图 1. 每个生成视频分块的相对耗时,以首个可在 TPU 上运行的版本为基准(= 1.00×)。每个里程碑都代表一批同时上线的改动。
从左到右看,每个分块的耗时下降至初始值的一半多一点——整体提速 1.86 倍——而模型本身和质量门禁始终不变。第一个里程碑带来了最大幅度的下降,体现的是"已知最佳实践"的完整执行:用自定义注意力内核替换通用内核、敲定序列并行的张量布局、针对本负载而非默认值调整 XLA 编译开关,以及让内核分块尺寸与张量形状相匹配。此后的三道墙,以及紧随其后的编译器契约,是这套已有方法论所无法触及的领域。
最终,流水线的流式生成性能可与我们基于 8×H100 的生产环境相媲美,而每分钟生成视频的成本效率则提升了最多 25%。
隐藏集合通信开销
Ulysses 序列并行在每一次自注意力计算中引入了一对 all-to-all 集合通信:一次用于将序列分片交换为注意力头(head)分片,一次再换回。在我们的性能采样中,这两次集合通信完全暴露在外,传输带宽已经达到了网格对分带宽(bisection bandwidth)的 85%–90%。线缆本身已无任何优化空间,因此问题只能指向程序结构本身:一段"先 all-to-all、再注意力、再 all-to-all"的单块串行链条,没有给 XLA 留下任何可以与之重叠的工作,因此编译器只能老老实实地将其保持同步。
在与 Google Cloud 团队共同商定的方案是标准的对症下药:对集合通信进行流水线化(pipelining)。将注意力头切分为若干独立组,每组各自运行 all-to-all → 注意力 → all-to-all 的模式;由于每组的数据传输现在都有兄弟组的注意力计算可以重叠,XLA 便转而采用异步的 start/done 配对来调度它们。真正困难的地方在于把这一改动稳妥地带过整条生产流水线与质量门禁。最棘手的环节是超分阶段的稀疏注意力:其掩码是针对特定的 token 顺序定义的,分头分组必须保持该顺序不变,使每个组看到的掩码与不分组时完全一致。从性能采样来看,集合通信在计算流上的"足迹"缩小了约 5 倍,而注意力本身的耗时并未变化。线缆传输时间并没有缩短——它只是被移出了关键路径,而这正是死线唯一关心的。分组数量存在一个甜点:分得过多,每次启动的开销就会吞掉重叠带来的收益。在实际调优中,有不止一次改动在单独测试时测量出更快,却在完整流水线深度下失效,因为这时数据传输彼此交错,还与线缆上的其他所有事务交织在一起。任何优化,都只有在端到端跑赢时才算数。
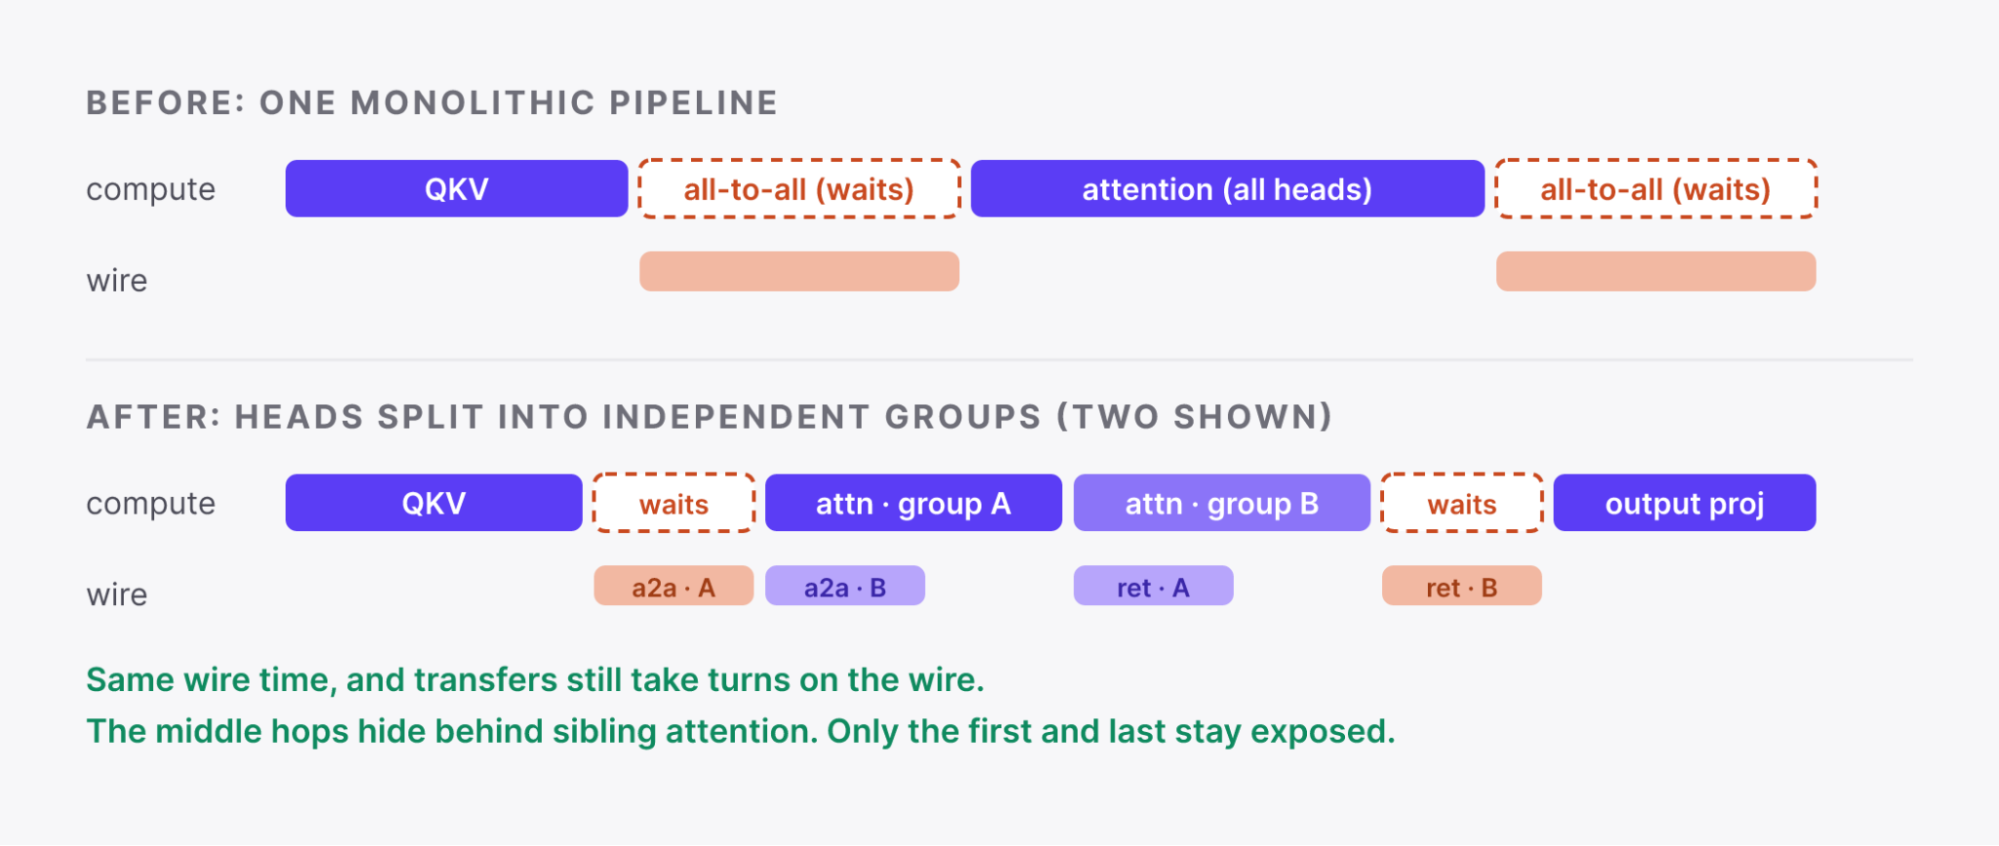
图 2. 交给 XLA 可与之重叠的工作。图为示意,时长未按真实比例。一段单块的 all-to-all 让编译器无事可藏,因此只能保持同步(上图)。将注意力头切分为若干独立组后,数据传输就形成了一条流水线:线缆仍然一次只传输一份数据,但每个中间步骤都可以隐藏在另一组注意力计算之后,只留下首尾两端的传输暴露在外(下图)。分组越多,暴露的两端越少,这正是集合通信在计算流上的"足迹"缩小约 5 倍(而非缩为零)的原因。