如何在 ADK 中评估 Live(实时)与语音 Agent
AUG. 24, 2026 作者:Stephen Allen,AI 应用与平台解决方案架构师
把一个实时 Agent 投入生产,远不止做好一次演示那么简单。它必须在一段口语对话中一轮接一轮地执行正确的动作,而时机把握和异常恢复与对话内容本身同样重要。昨天听起来还很完美的行为,可能在下一次 prompt 微调或模型迭代时悄悄发生变化:工具不再被调用,上下文在多轮之间丢失,插话被忽略。要有信心地上线,就需要可重复的证据,证明 Agent 在真实用户实际会进行的对话中表现稳定。
正因如此,我们要把原生 live evaluation(实时评估)能力引入 ADK。现在,你可以用一个会“说出”自己轮次的模拟用户来驱动一个实时的、基于语音的 Agent,对语音回复打分,并且这一切都可以在你已有的、用于文本 Agent 的同一个评估循环里完成。本文将带你把一个实时 Agent 从“演示里能跑”带到“经过度量、值得信赖”,全程不离 ADK。
评估你的第一个实时 Agent
为了实际演示这一过程,我们会构建一个完整的实时评估循环:创建 Agent、编写评估用例、运行评估、查看记录的运行结果。
第一步:被测 Agent
本示例使用基于图的工作流:三个职责单一的实时 Agent 顺序串联,每个阶段都运行在 gemini-live-2.5-flash-native-audio 之上。
from google.adk.agents.llm_agent import Agent
from google.adk.tools.tool_context import ToolContext
from google.adk.workflow import START, Workflow
from pydantic import BaseModel, Field

LIVE_MODEL = "gemini-live-2.5-flash-native-audio"

def validate_date_of_birth(dob: str, tool_context: ToolContext) -> dict:
  """根据记录(此处为模拟)验证已确认的出生日期。"""
  match = dob == "1985-07-12"
  tool_context.state["dob_verified"] = match
  return {"match": match}

greeter_agent = Agent(
    model=LIVE_MODEL,
    name="greeter_agent",
    mode="task",
    instruction="你是 Sam,一位友好的护理团队助理。在分享任何其他信息之前,先向来电者问好,"
    "并确认你正在与 John Doe 通话。每轮只问一个问题,然后在确认姓名后完成任务。",
)

dob_verifier_agent = Agent(
    model=LIVE_MODEL,
    name="dob_verifier_agent",
    mode="task",
    tools=[validate_date_of_birth],
    instruction="询问来电者的出生日期,复述一遍以确认,然后以 YYYY-MM-DD 格式调用 "
    "validate_date_of_birth。最终以 'verified' 或 'unverified' 结束你的任务。",
)

goals_agent = Agent(
    model=LIVE_MODEL,
    name="goals_agent",
    mode="task",
    instruction="身份已验证。请主动告知即将到来的预约:6 月 16 日星期二下午 3 点,由 Example 医生接诊,"
    '回答任何问题后热情收尾,并以 "Goodbye." 结束。',
)

root_agent = Workflow(
    name="live_workflow",
    edges=[
        (START, greeter_agent),
        (greeter_agent, dob_verifier_agent),
        (dob_verifier_agent, goals_agent),
    ],
)
Python 已复制
每一个阶段都是一个普通的实时 Agent,工作流只是在它们之间做编排,并把上一阶段的输出传递到下一阶段。这个流程走过了三个步骤,中间还包含一次工具调用,因此会生成一条信息丰富、值得打分的多轮轨迹。当控制权在 Agent 之间切换时,用户完全察觉不到交接——音频流在整个交互过程中保持打开,ADK 会将累积的会话状态和对话历史向前传递,让每个 Agent 都能在上文语境中接手,而不是从零开始。
第二步:编写评估集(eval set)
评估集是一个包含测试用例的 JSON 文件。测试用例与它们的运行方式解耦,因此你可以混用两种不同的风格:对话场景(conversation scenario)和固定对话(fixed conversation)。
第一种是对话场景:你描述一个目标和一个人设,模拟用户即兴发挥出自己的轮次。
{
  "eval_id": "example_scenario_case",
  "conversation_scenario": {
    "starting_prompt": "你好?",
    "conversation_plan": "你是 John Doe。被问好时确认自己的姓名。被要求提供出生日期时,告知 1985 年 7 月 12 日,并在被复述时加以确认。听完预约详情后,询问就诊时需要带什么,然后表示没有其他问题,让通话自然结束。",
    "user_persona": "NOVICE"
  },
  "session_input": {
    "app_name": "live_workflow",
    "user_id": "test_user_id",
    "state": {}
  }
}
JSON 已复制
user_persona 决定了模拟用户的沟通方式。ADK 内置了几种人设,NOVICE 表示模拟用户只给出高层级目标,并等待 Agent 主动询问细节,从而测试 Agent 推进对话的能力。人设是由 prompt 驱动的,而不是硬编码的,因此你可以用自定义人设来扩展这一集合。当 conversation_plan 中的目标达成时,模拟器会自动结束场景,所以你只需脚本化目标,让它自行判断何时挂断电话。为了防止对话无限跑下去,max_allowed_invocations 限制了总轮数,为每个动态用例提供一个可预期的上限。
你也可以编写一个固定对话,逐字脚本化用户的轮次。静态用例与模拟用户一样,都是合法可用的实时运行输入。
{
  "eval_id": "example_fixed_case",
  "conversation": [
    {
      "user_content": {
        "role": "user",
        "parts": [{ "text": "嗨,是的,我是 John Doe。" }]
      }
    },
    {
      "user_content": {
        "role": "user",
        "parts": [{ "text": "我的出生日期是 1985 年 7 月 12 日。" }]
      }
    }
  ]
}
JSON 已复制
第三步:开启 live 与 audio 模式
在你的 test_config.json 中,添加一个 live_model_config,并让 ADK 指向 llm_audio 形式的用户模拟器。上述用例中的每一轮用户发言,都会通过你选定的 Gemini TTS 音色被合成成语音,并流式发送给实时 Agent。
{
  "criteria": {
    "rubric_based_multi_turn_trajectory_quality_v1": {
      "threshold": 0.7,
      "judge_model_options": { "judge_model": "gemini-3.7-flash" },
      "rubrics": [
        {
          "rubric_id": "verifies_identity_first",
          "rubric_content": {
            "text_property": "在整个通话过程中,Agent 在披露任何预约详情之前,先确认来电者的姓名并核验其出生日期。"
          }
        }
        // ... 其他端到端 rubric
      ]
    }
  },
  "live_model_config": {
    "timeout_seconds": 300
  },
  "user_simulator_config": {
    "type": "llm_audio",
    "model": "gemini-3.7-flash",
    "max_allowed_invocations": 10,
    "audio_model": "gemini-3.1-flash-tts-preview",
    "audio_model_configuration": {
      "response_modalities": ["AUDIO"],
      "speech_config": {
        "voice_config": {
          "prebuilt_voice_config": { "voice_name": "Kore" }
        },
        "language_code": "en-US"
      }
    }
  }
}
JSON 已复制
以下几点值得特别说明:
live_model_config用于启用 live 模式。省略此项时,同样的测试用例会改为在标准文本模式下运行。model与audio_model的区别:model负责驱动模拟用户的轮次决策逻辑,而audio_model则把这些轮次合成成语音。你可以调整voice_name和language_code,从而测试 Agent 在不同音色与口音下的表现。criteria用于配置评估指标与通过/未通过的阈值。基于 rubric 的 LLM 裁判(例如 trajectory quality,即轨迹质量)会对整段对话进行端到端评估,非常适合多 Agent 图。你也可以附加按轮次打分的指标,对单条回复或单次工具执行进行打分。
一句口语化的回复可以有上百种正确的措辞。基于自然语言的 rubric 能像人类评审那样判断意图,只需编写一次,就能自动套用到套件中的每一场对话。
第四步:运行评估
准备好 Agent、评估集和配置文件后,通过 CLI 运行评估:
uv run adk eval \
  contributing/samples/live/live_workflow \
  contributing/samples/live/live_workflow/live_workflow.evalset.json \
  --config_file_path contributing/samples/live/live_workflow/test_config.json
Shell 已复制
注意:请确保已安装评估相关依赖(uv pip install -e ".[eval]"),并为 Live API 和 Gemini TTS 配置好 API 凭证。
同一条流水线也可以通过 AgentEvaluator 以编程方式调用,便于把实时语音评估接入你的 CI/CD 流水线,在上线前捕捉回归。
第五步:在 ADK Web 中查看结果
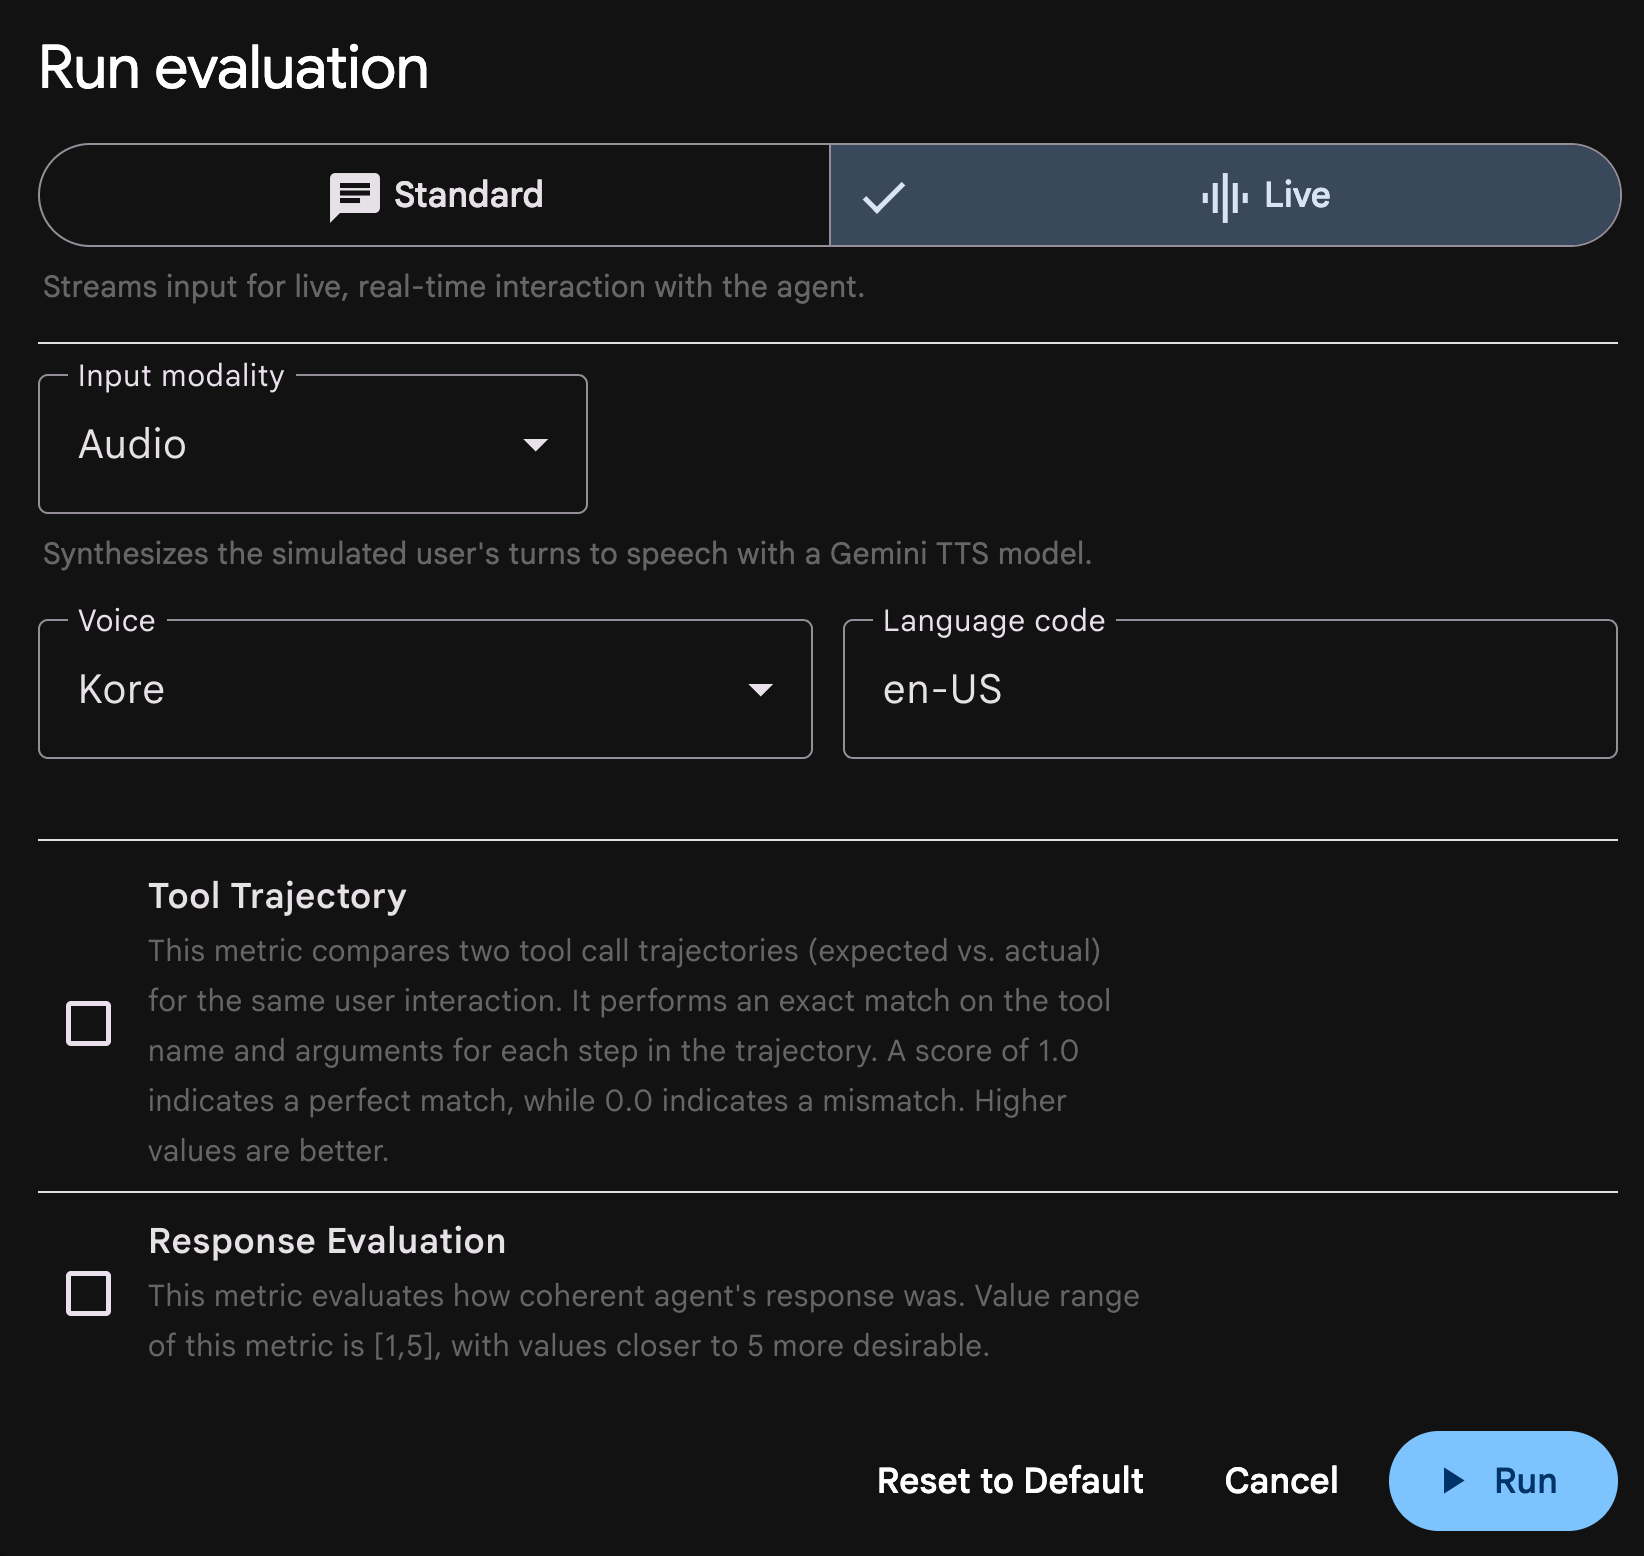
为了便于交互式调试,ADK Web 现在原生支持实时评估。运行配置对话框中新增了一个 Standard | Live 模式切换开关。选择 Live 后,会出现输入模态选项(音频或文本),以及模拟用户所用的音色和语言设置。
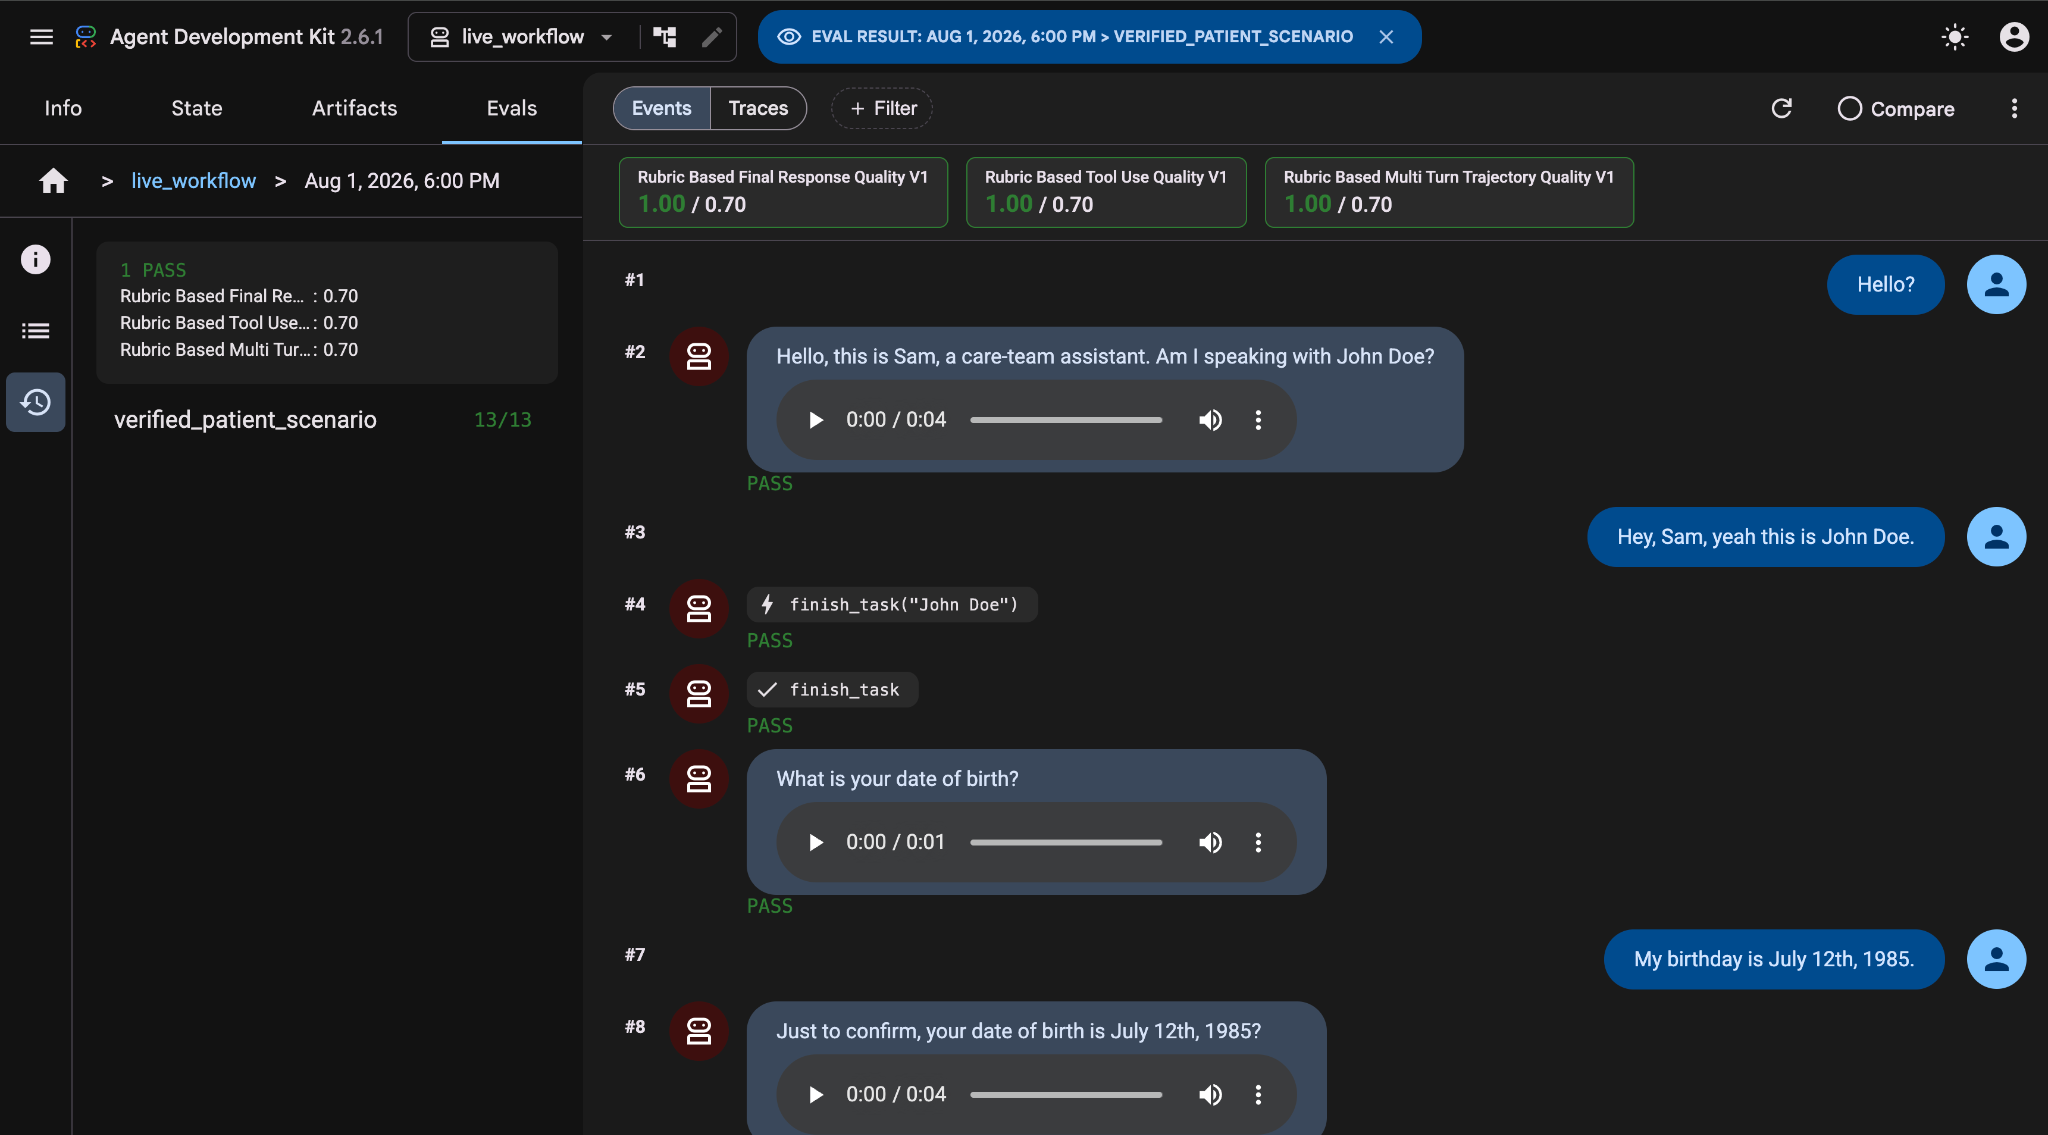
运行结束后,ADK 会把实时音频流重建为一份清晰的转写文本。每一条轮次都展示在独立的消息气泡中,配有转写文本和一段可内联播放的音频片段,让你既能听到 Agent 的“声音”,也能读到它说了什么。