
2026 年 10 月 2 日
GPT‑6 模型家族选型指南
在管理好时间与成本的前提下,充分发挥 GPT‑6 模型最佳效果的实用建议
GPT‑6 是我们迄今最先进的模型套件,可针对不同类型的工作提供多种模型供你选择。
无论你是在把想法变成可工作的原型、构建并测试一项功能,还是在代码仓库、数据库和外部 API 之间编排多步骤工作流,本指南都会讲解如何选择 GPT‑6 模型、如何给出有效指令、如何管理长时间运行的任务,以及如何为生产环境做好准备。
摘要
在生产环境中高效运行。 使用 缓存(在 新窗口打开) 和 上下文压缩(在 新窗口打开) 来管理上下文和成本。衡量任务成功率与延迟,并为监控与数据控制做好规划。
让模型匹配你的工作负载。 通过选择合适的模型、推理强度(在 新窗口打开) 和速度,在能力、成本与延迟之间取得平衡。
调整提示词与技能。 让提示词、技能和仓库说明在以下问题上保持一致:模型应交付什么、它可以独立完成什么、以及怎样算作完成。
让长时间运行的任务保持在轨。 利用 steering(在 新窗口打开)、异步工具(在 新窗口打开) 和 任务委派(在 新窗口打开) 来处理更新和独立工作。明确设定模型何时应主动询问输入的边界。
1. 在生产环境中高效运行
为生产环境做好准备
在部署之前,有几项检查和最佳实践需要落实到位。
时刻关注效率。在保留必要证据的前提下,裁剪任务不需要的上下文(在 新窗口打开)。在应用支持的情况下,并行运行相互独立的任务(在 新窗口打开),避免因某一步较慢而阻塞无关工作。
通过 提示缓存(在 新窗口打开) 复用重复工作中的共享上下文。缓存输入 token 的成本最多可比未缓存输入令牌低 95%(在 新窗口打开),具体取决于所用模型。请将稳定的指令和参考资料放在易变的任务细节之前,并保持工具定义的一致性。缓存仪表板(在 新窗口打开) 与 诊断指南(在 新窗口打开) 可帮助你定位复用被打断的位置。在估算完整工作流的成本时,请把缓存写入以及任何长上下文费率一并计入。
对于较长的会话,上下文压缩(在 新窗口打开) 能够在保留继续工作所需状态的前提下减小上下文体积。
决定如何 监控模型行为(在 新窗口打开),并审视你应用的 数据控制策略(在 新窗口打开)。
部署前进行测试:运行具有代表性的任务,衡量任务成功率、延迟以及每个成功任务的成本。可参考我们的 API 部署检查清单(在 新窗口打开)。
让模型匹配工作负载
可以将模型选择和推理强度视作一种「智能水平 / 价格」的权衡。
模型:
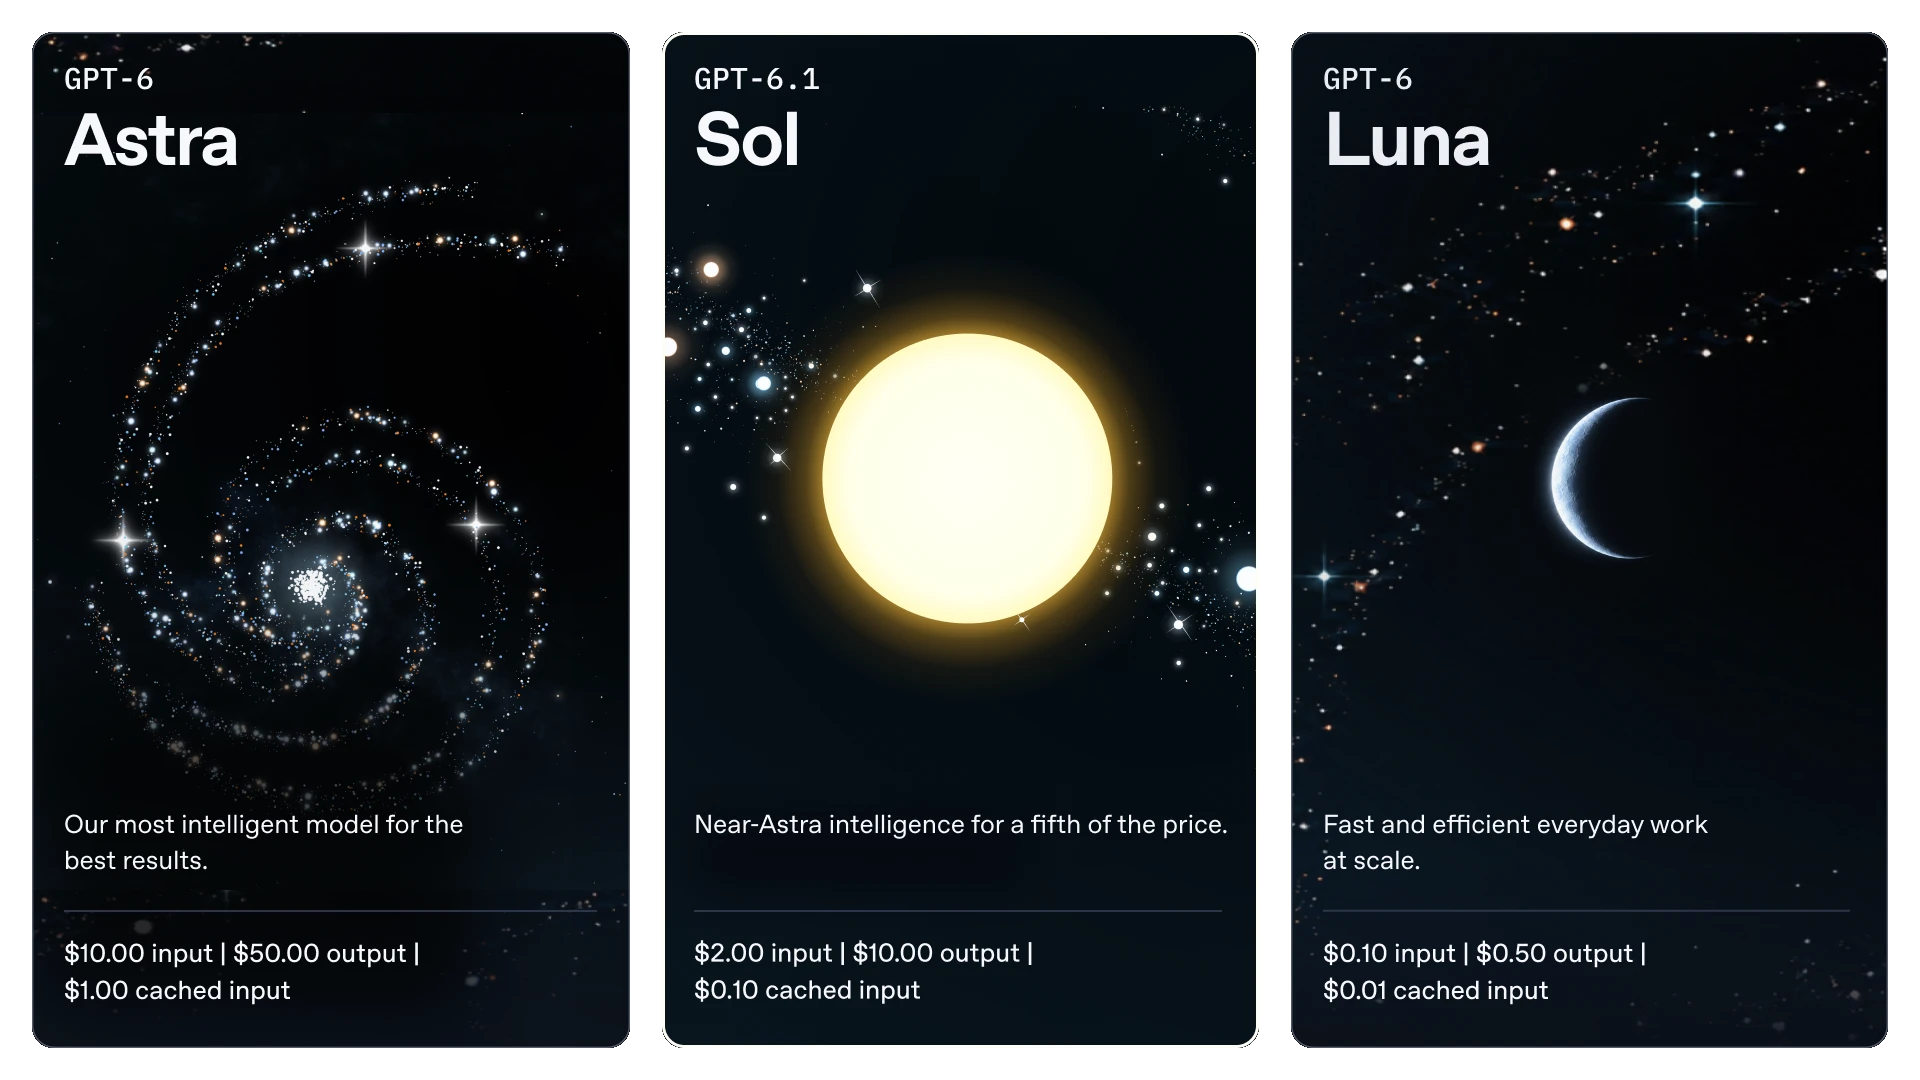
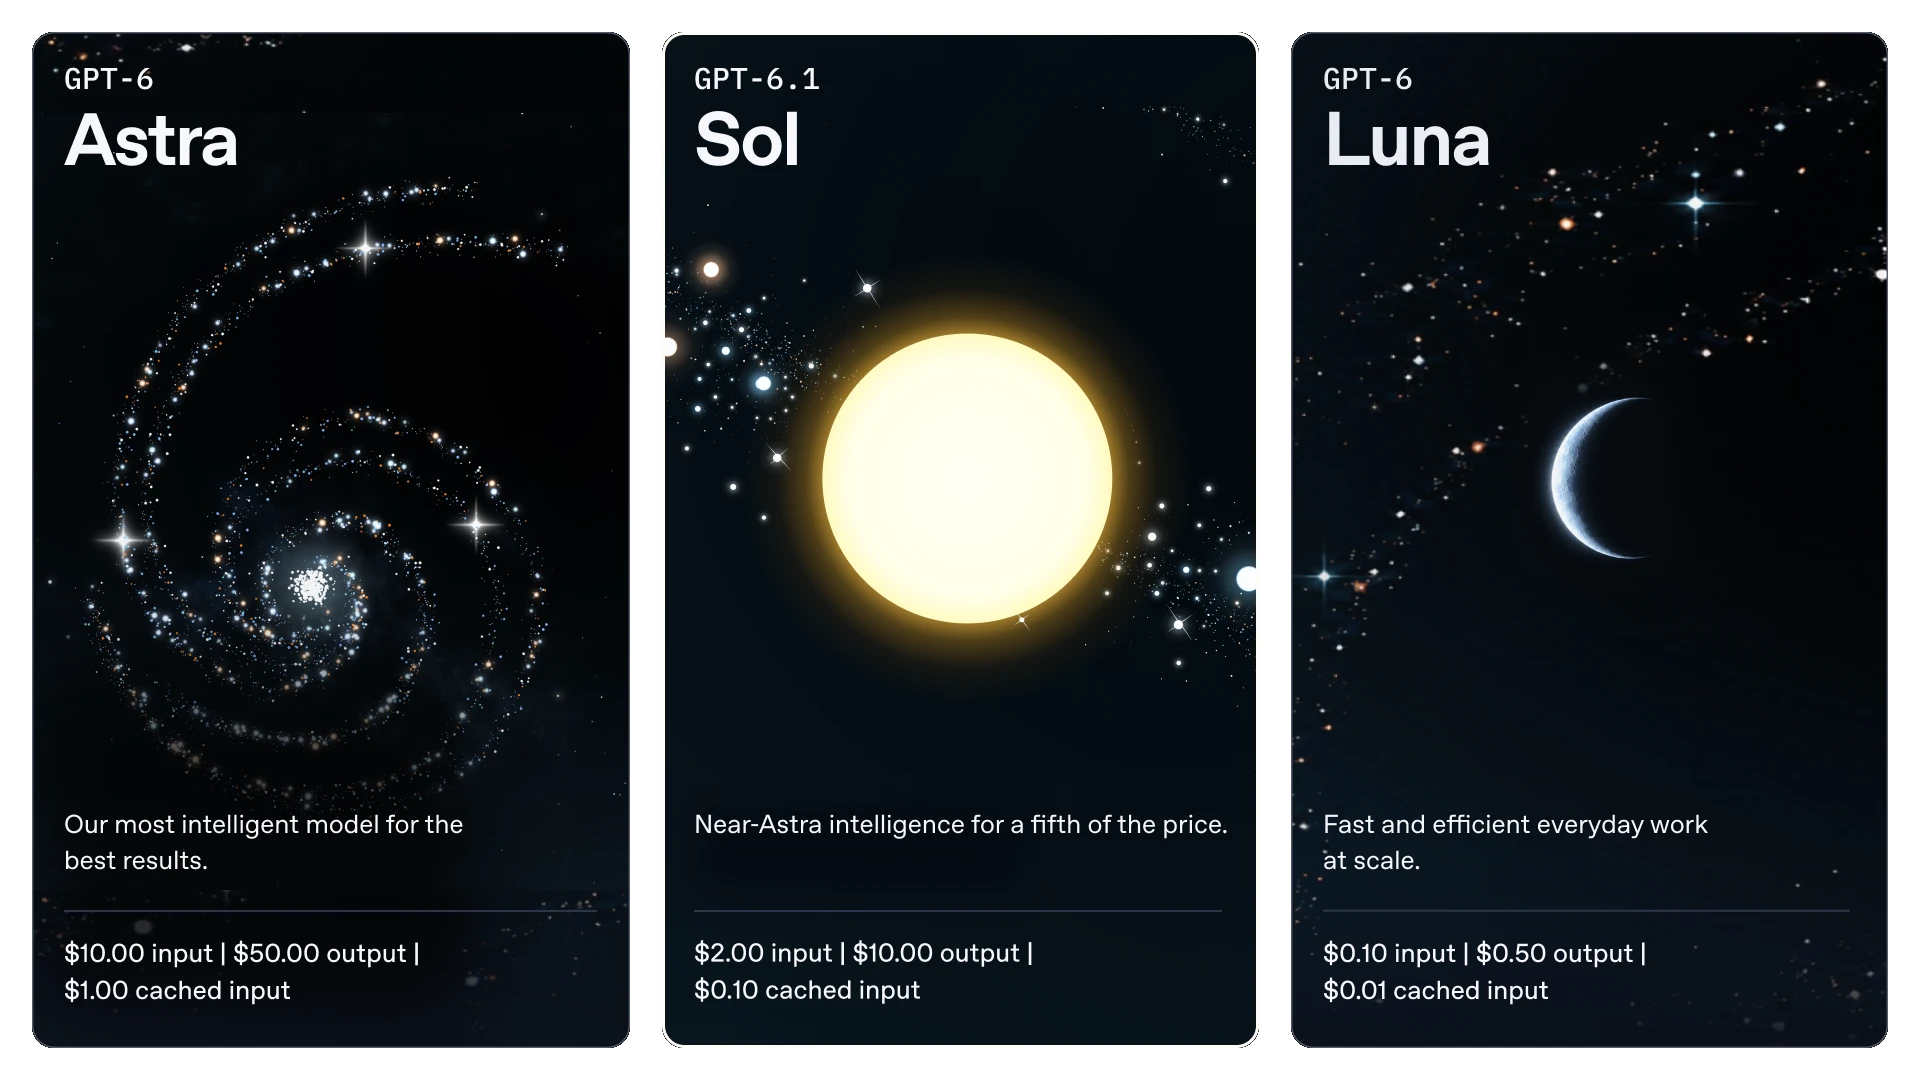
GPT‑6 Astra(在 新窗口打开):用于需要最高智能水平的最难推理任务。
GPT‑6.1 Sol(在 新窗口打开):用于复杂编码、研究和计算机使用任务。
GPT‑6 Luna(在 新窗口打开):用于规模化执行的目标聚焦型日常重复任务,例如抽取发票字段、分类请求或生成结构化摘要。
在评估最适合任务的模型时,可对比各模型的定价(在 新窗口打开)。
推理强度: 在 API 中,可选择模型在任务上投入多少推理努力。
- 低:例行任务,例如抽取事实或进行小幅修改。
- 中:需要判断力的工作,例如规划一项功能或对比方案。
- 高:困难的调试、更深入的分析或细致的复核。
- 超高 / 最大:在支持的情况下进行测试,当「高」不够用时启用;只有当改进幅度值得付出额外时间和成本时才继续使用。
在 API 中,你可以在对话中途更改推理强度(在 新窗口打开) 而不会破坏缓存。
在 Codex 中,从该模型的默认推理强度开始,针对更简单的任务可降低强度,需要深入分析时可提高强度。
速度:
在 API 中,当响应时间很重要时(例如在聊天应用或编码工具中),可使用 快速模式(在 新窗口打开)。相比标准处理,它以更高的单 token 成本换取更快、更稳定的响应时间。
在 Codex 和 API 中,当更快的响应值得付出额外溢价时(例如快速编码迭代场景),可使用 极速模式(在 新窗口打开)。它独立于推理强度来提升 token 生成速度。GPT‑6 Astra 可用该模式(在 新窗口打开)。
2. 调整提示词与技能
给模型布置清晰的任务
"模型在理解细微差别和歧义方面已经变得好得多,因此过去有帮助的过度具体指引,在当下可能反而会妨碍效果。"(在 新窗口打开)
——Eric Provencher,OpenAI 开发者体验团队
从一项清晰的任务开始:明确你想要的结果、目标受众、相关上下文与约束,以及怎样算作完成。然后审视以下四个方面,这些要点总结自 重新思考 GPT‑6 Astra 的技能与提示词(在 新窗口打开),可深入了解如何更新你的指令:
打造更好的技能(skills): 让描述简短且明确说明每个技能应在何时运行,仅在需要时加载支撑细节,并使用适合团队所用模型的指引取代僵化的固定流程。
更新你的 AGENTS.md: 说明哪些文档和测试在何种情况下相关,并明确授权安全的例行工作流,例如使用一次性数据且无生产访问权限的本地测试。
设定决策边界: 明确哪些操作可以独立进行、哪些需要审批,用清晰的边界取代一刀切的「始终先问」规则。
对持续推进保持明确要求: 定义「完成」包含哪些内容——实施变更、运行变更、检查结果并修复失败——并明确指出哪些决策需要你进行复核。
更多指引,请参阅 推理最佳实践(在 新窗口打开)。
定义你需要的输出
无论你是在 Codex 中工作,还是通过 API 进行构建,都应明确指定模型可以做哪些决策、何时应询问你的输入,以及什么样的回复是有用的。
给模型足够的指引,让工作持续推进,而不会在重要决策上随意猜测。告诉它哪些选择可以自行决定、何时应征求你的输入(在 新窗口打开),例如,模型可以自行决定如何组织摘要,但在改变项目范围之前应与你确认。描述一个有用的回复是什么样的(在 新窗口打开),例如使用通俗语言、技术细节贴合你的受众,并提供一个简短的交接说明,涵盖变更内容、检查过的项目以及仍需关注的事项。
3. 优化长时间运行的任务
让复杂工作持续推进
借助 GPT‑6 系列模型,你现在可以承接持续数小时乃至数天的任务。使用以下功能来更好地管理长时间运行任务中的智能体。