
如何在智能体框架(Harness)中构建模型路由器
Sydney Runkle、Eugene Yurtsev,2026 年 10 月 1 日,约 12 分钟
核心要点
- 许多任务并不需要前沿级智能。 在我们的实验中,模型路由让每个编码任务的中位成本相比基线降低了 64%,而质量没有明显变化。
- 一个有效的模型路由器应当放在智能体框架里,而不是通用的网关里。 选择合适的模型需要智能体框架已经具备的领域与任务上下文,而通用网关通常缺乏这些信息。
- 有效的路由器设计根植于可观测性与评测。 它要求你理解智能体的任务空间、研究模型表现,并设定清晰的成败标准。
前沿级大语言模型仍然十分昂贵。随着智能体变得无处不在、并以海量规模运行,这种成本是难以承受的。幸运的是,大多数智能体并不是在每个任务上都需要前沿级别的智能。模型厂商也持同样的看法:Anthropic 的《如何选择模型》指南就指出:“对于许多应用而言,从更快、更具性价比的模型(例如 Claude Haiku 4.5)起步,往往是最优选择。”
一旦越过某个临界点,就会出现收益递减:能力更强的模型带来的质量提升很小,成本与延迟却持续攀升。一个优秀的智能体应当具备 模型–框架–任务匹配(model-harness-task fit):针对给定任务,使用合适的模型并配合恰当的上下文。模型路由器 的职责就是为每个任务挑选出那个合适的模型。我们认为路由决策应当 落在智能体框架内,而不是通用网关里——因为选择合适的模型需要智能体框架已经具备的领域与任务上下文,而通用网关通常缺乏这些信息。
最近我们在 LangChain 内部切实感受到了这种压力:我们的月度编码智能体支出开始迅速攀升。在听到客户反馈同样的担忧后,我们决定为 Open SWE——我们的开源编码智能体——构建一个有效的模型路由器。相较于之前“始终使用顶级前沿模型”的基线,它把每个会话(thread)的中位成本降低了 64%,而质量没有任何可衡量的下降。本文将介绍我们是如何构建这个路由器的、过程中学到了什么,以及你该如何着手为你的智能体引入模型路由。
第一步:理解任务
我们的测试床是 Open SWE,我们的工程师通过 Slack 与一个 Web 界面使用它,就代码库提问并发起代码改动。在构建路由器之前,我们需要先弄清开发者究竟用 Open SWE 做什么类型的任务。我们从 LangSmith 的链路追踪中拉取了 会话级(thread-level) 数据:包括收到的请求种类,以及每个会话的成本与轮次(作为复杂度的近似衡量)。我们借助 LangSmith Custom Apps 直接在 Open SWE 追踪之上搭建了一个小界面完成探索。
我们抽取了一周的交互式会话,使用一个 LLM 分类器为每条会话打上任务类型标签。LangSmith Insights 同样可以替你完成这种跨追踪的归类。其中代码改动占主导:新功能(22%)与缺陷修复(17%)是最大的两类,紧随其后的是测试或空操作运行(16%)。这些类别是基于每个会话的标题与元数据形成的启发式划分。
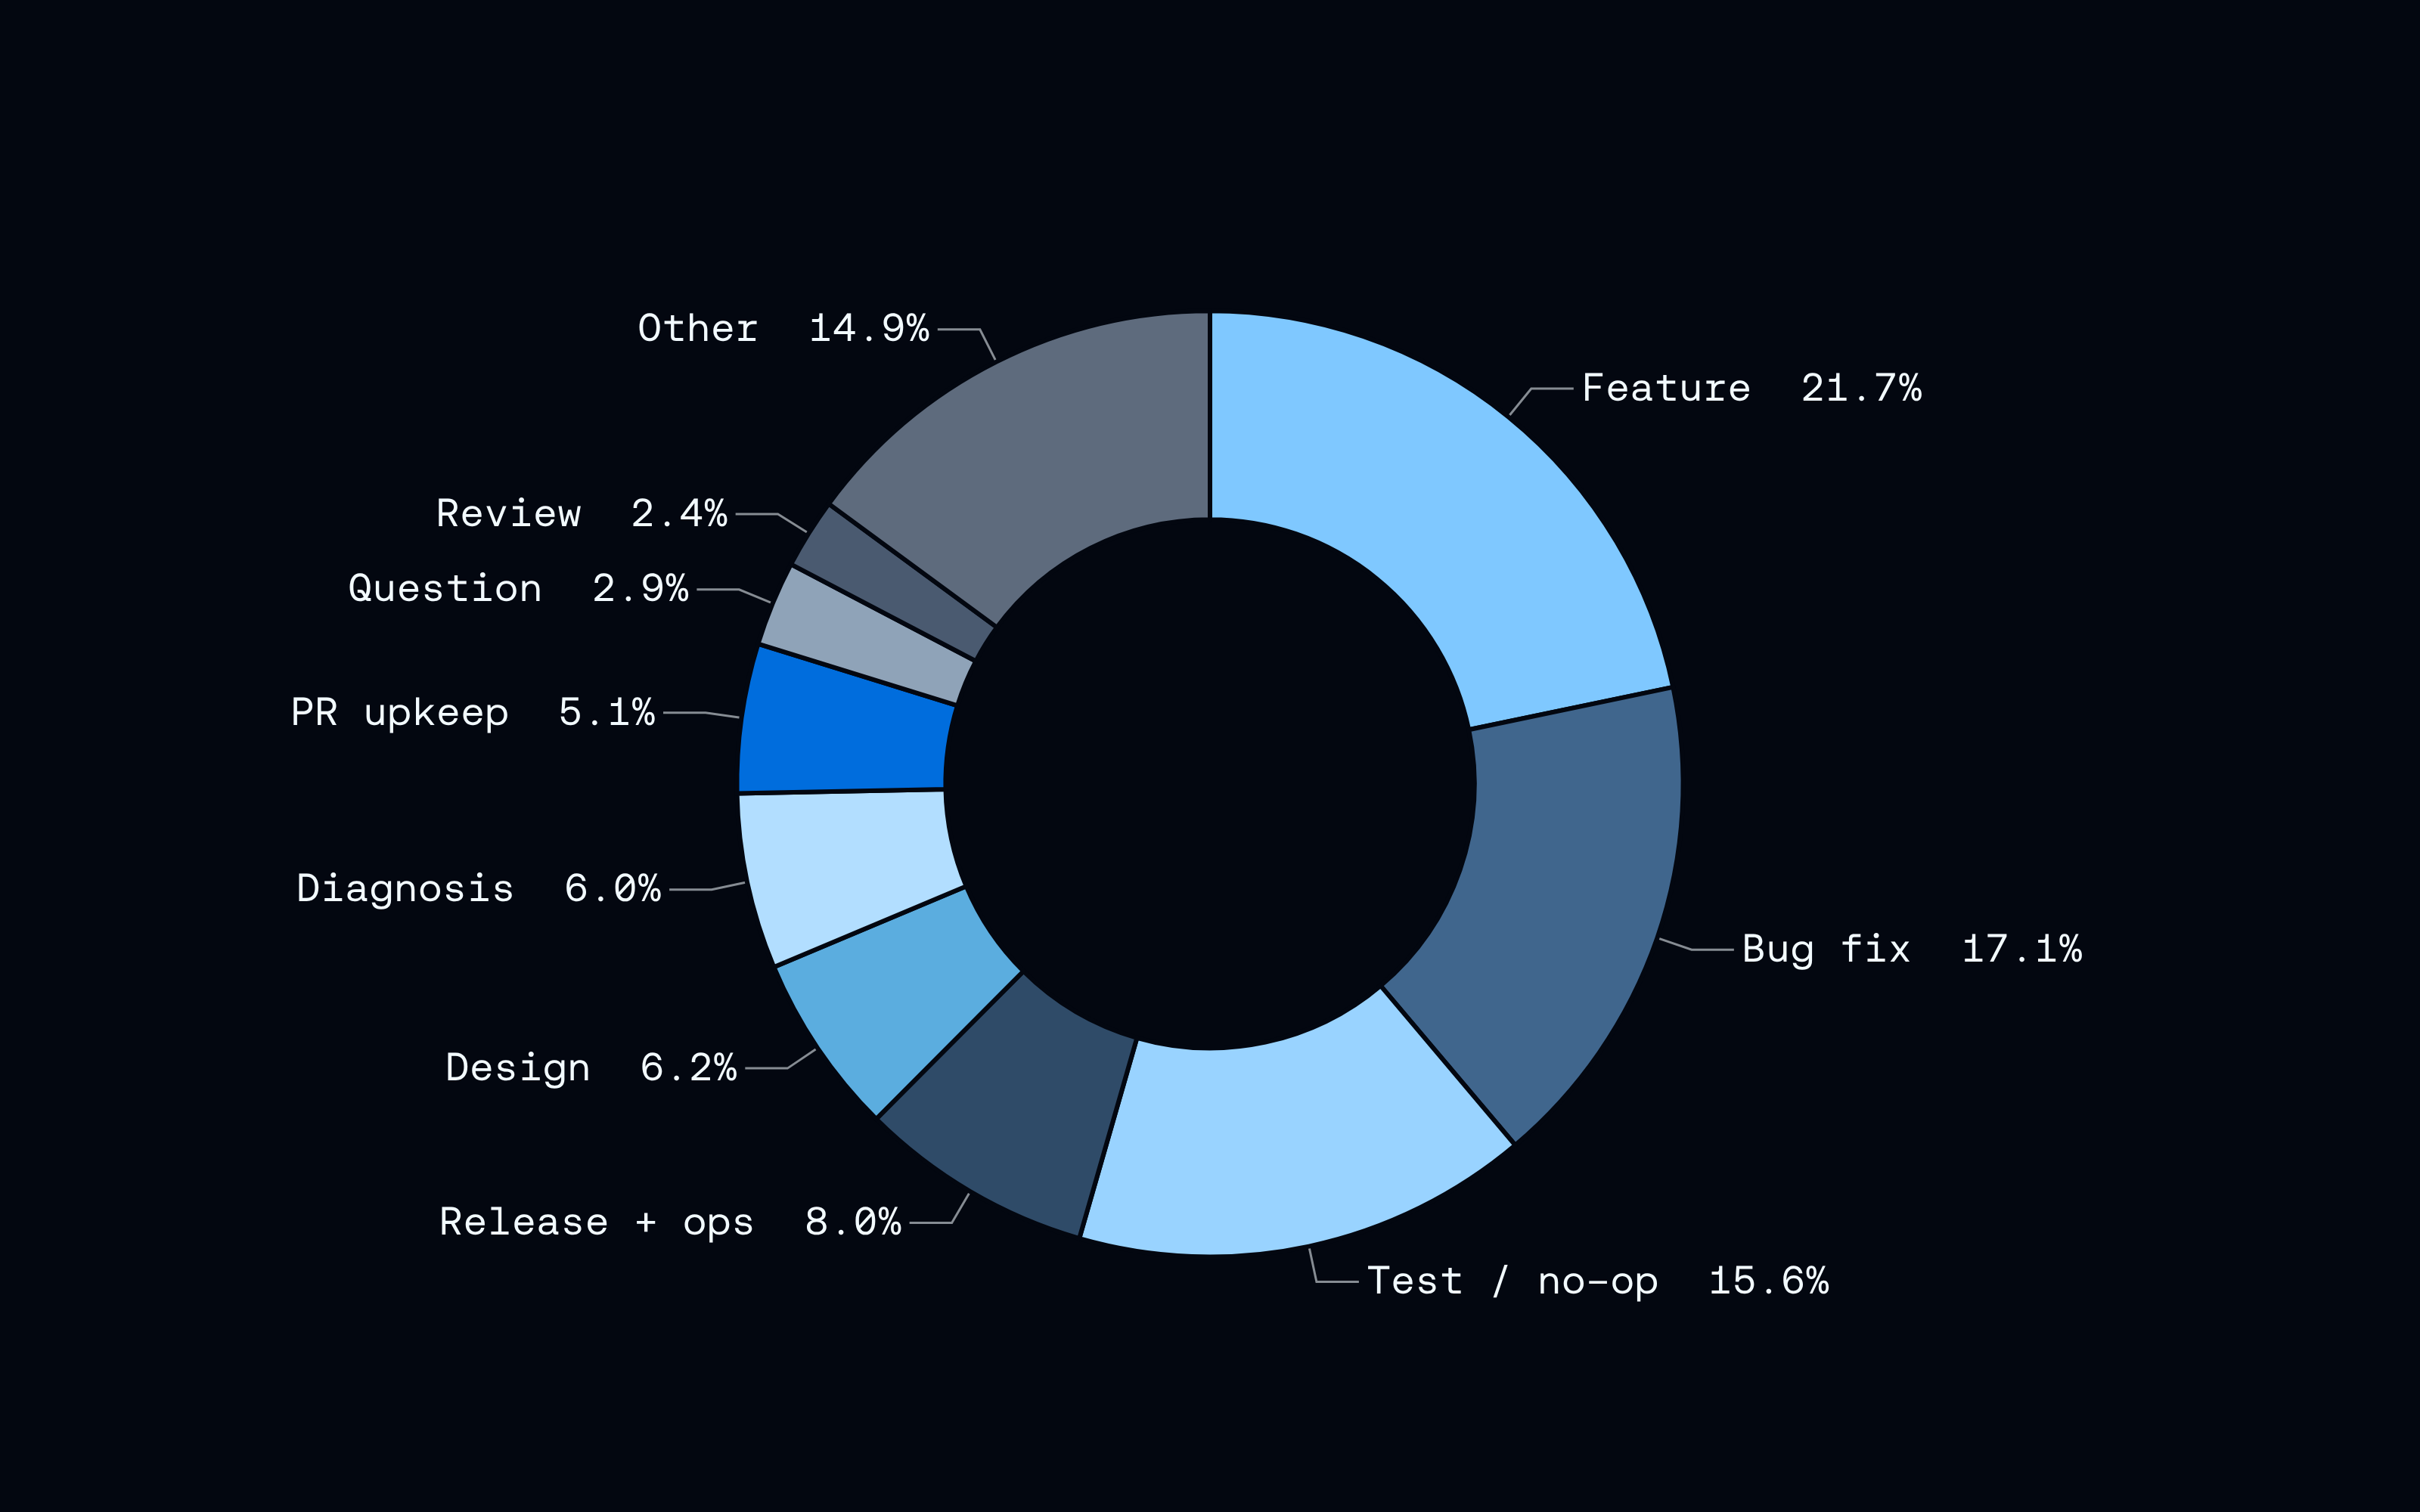
我们还研究了智能体追踪特征在不同任务类型下的差异。我们发现,与功能类调研工作相关的会话往往更长,成本更高、中位轮次也更多;而与测试和发布流程相关的会话则相对较短、成本也更低。
为了判断“复杂度”,我们同时使用了总成本与调用次数这两个信号:成本能较为直接地反映复杂度,因为更大的任务会消耗更多 token;而调用次数更为微妙,因为高调用次数可能意味着任务更难,也可能是模型为完成任务需要多轮跟进。
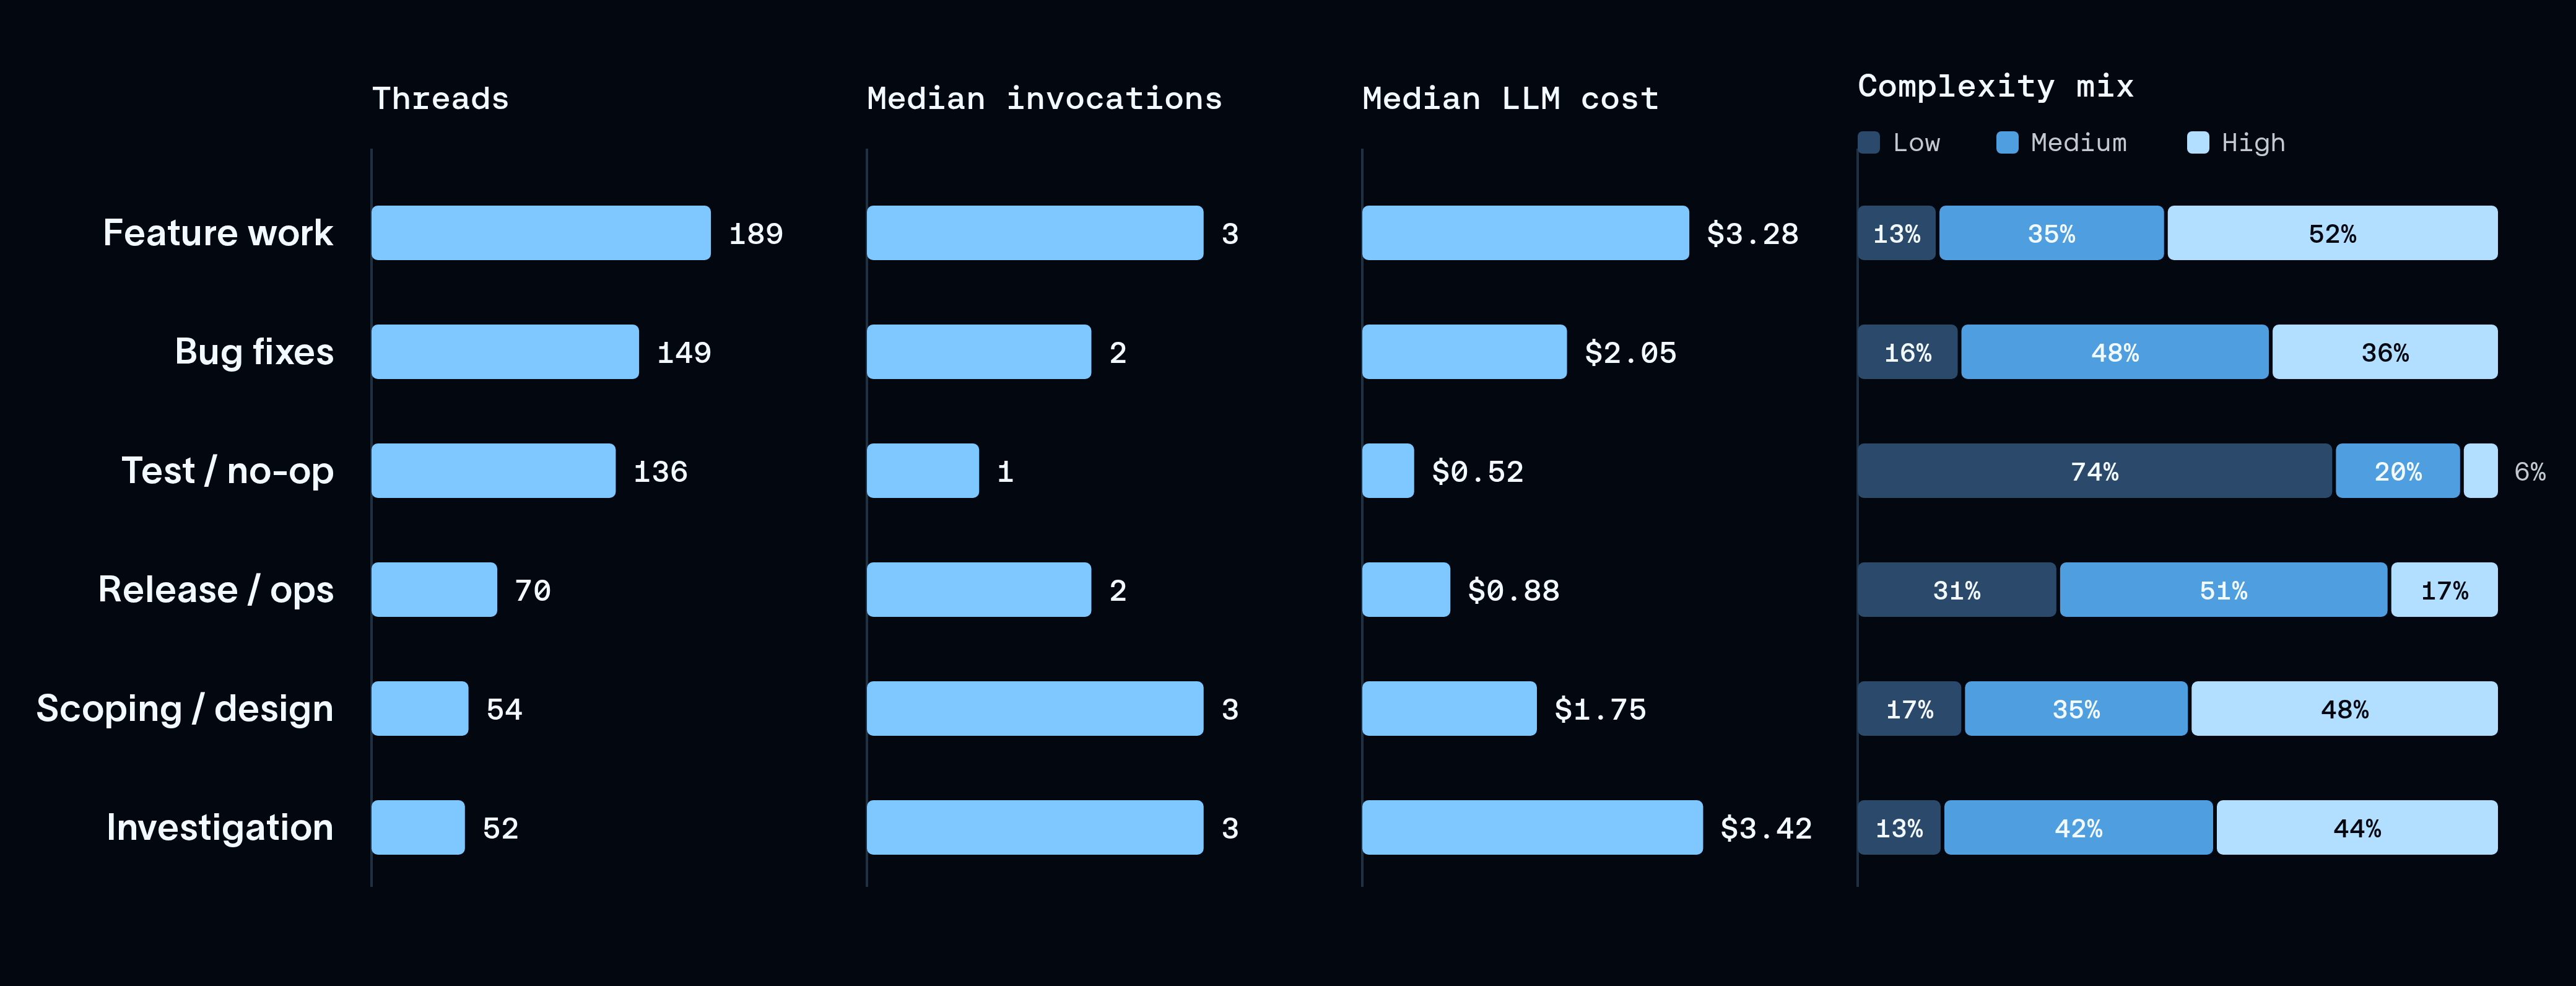
在采集数据时,所有 Open SWE 会话都还路由到一款顶级前沿模型。考虑到任务复杂度的跨度,上述数据让我们猜想:Open SWE 处理的许多任务或许并不需要前沿级智能。
这种任务复杂度的差异给我们带来了一个值得验证的假设:路由器可以从初始请求中推断出任务的类型与难度,并将其分派给更便宜或更快的模型,而不会让结果质量下降。
第二步:理解模型
Artificial Analysis Intelligence Index 在一组通用任务上为各模型打分,并报告每任务成本,因此你可以在同一条“智能 vs 成本”曲线上一并观察所有模型。帕累托前沿(Pareto frontier)就是既最便宜又最聪明的那一组模型。
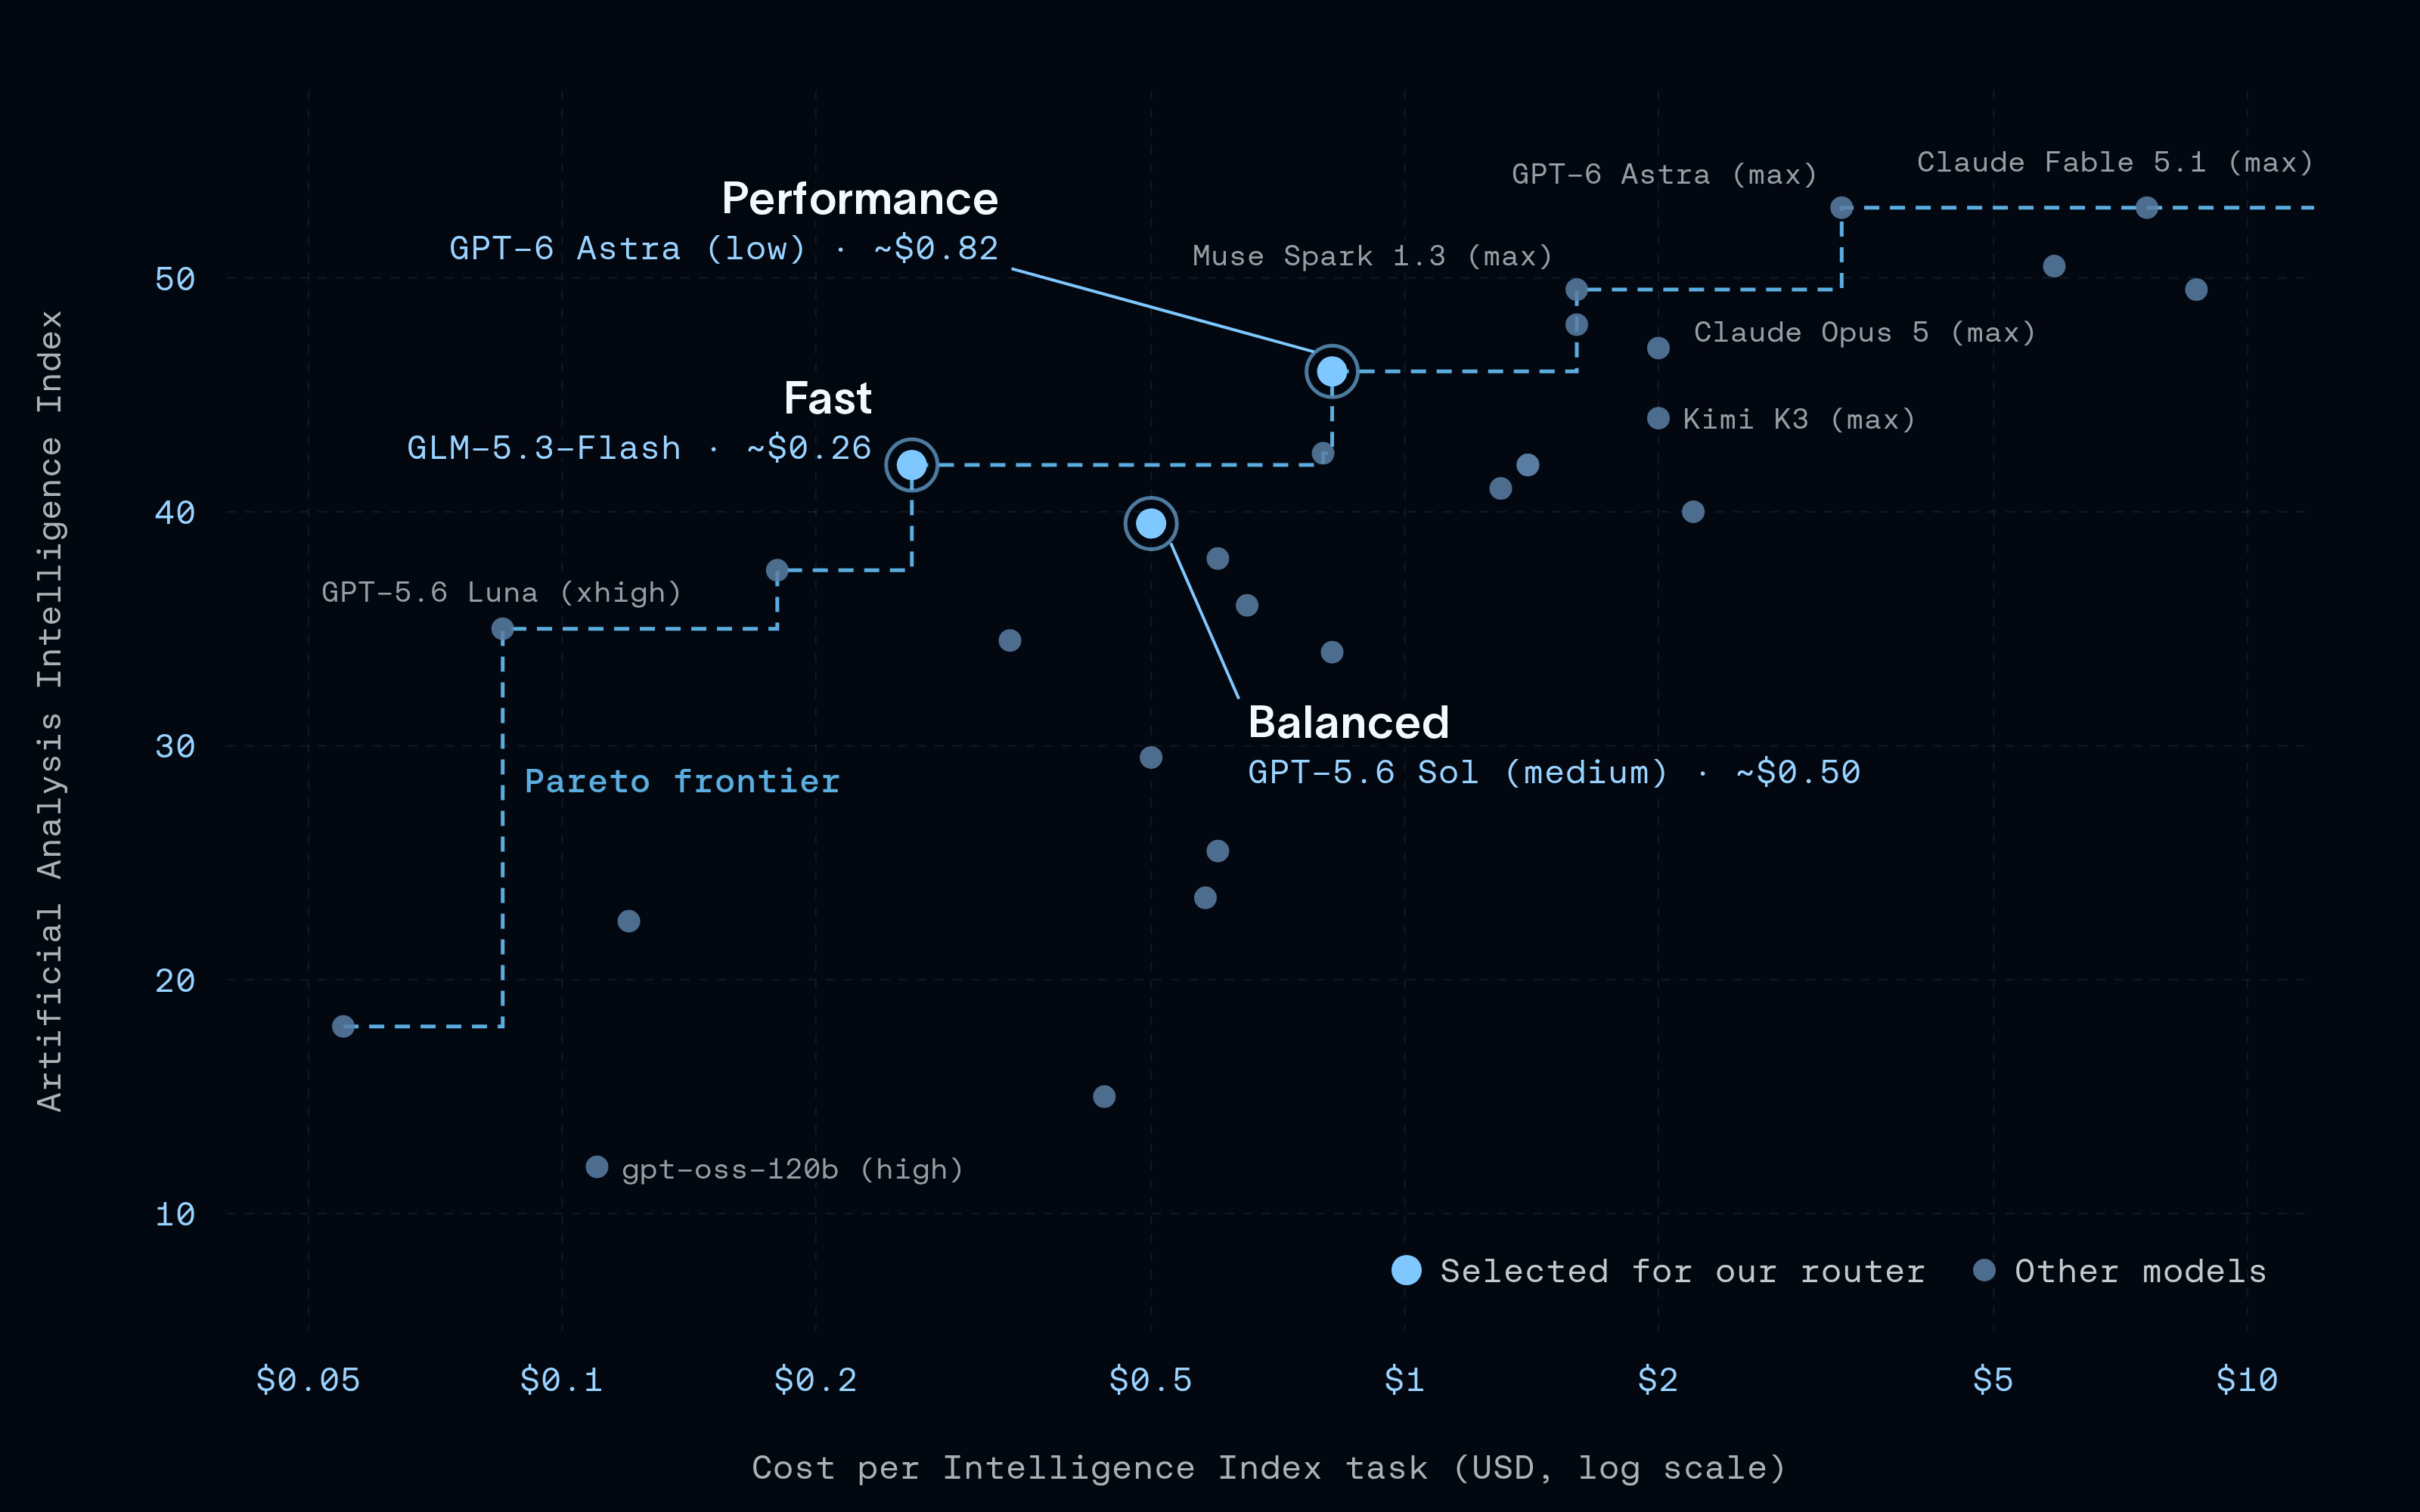
我们在曲线上选取了三个模型,让它们在成本、速度与智能之间各有侧重:
- 快速档(Fast): GLM-5.3-Flash(xhigh)
- 均衡档(Balanced): GPT-5.6 Sol(medium)
- 性能档(Performance): GPT-6 Astra(low)
我们从不同厂商选择模型,其中快速档是一款开源模型。GLM-5.3-Flash 在帕累托前沿上紧邻闭源模型,这也是 开源模型已跨过临界点 的又一个佐证。LangChain 本身在模型上是中立的,提供一套通用的 模型接口,跨 各厂商 行为一致,因此当更好的模型出现时,只需在路由器中改动一行代码即可替换。
第三步:在智能体框架中构建路由器
在梳理清楚任务分布并选定三个档位之后,下一步是为每条进入的请求匹配合适的模型:将其送到能够成功完成任务的最低成本档位。在 LangChain 中,这一决策自然落在 中间件 中,它可以在不改动智能体其他部分的情况下替换智能体调用的模型(参见 动态模型选择)。
Open SWE 中的路由器 在会话的第一条人类消息上运行,由三部分组成:
- 一份基础提示词(base prompt): 告诉分类器它的任务:挑选出能够完成该任务的最便宜的模型。
- 每个档位的判定标准: 一段简短、用自然语言描述的说明,规定各档位适合承接的工作类型。
- 一个分类模型: 阅读请求,并根据基础提示词与判定标准选定一个档位。
通用基准只是一个起点。每个档位的判定标准应当从两类资料出发来撰写:你自己的任务分析,以及各厂商对其模型擅长之处的官方说明。我们结合了第一步得出的任务分布,以及 GPT-5.6 Sol、GPT-6 Astra 与 GLM-5.3-Flash 的厂商指南,最终写出了基础提示词与各档位标准。
这些判定标准是面向 Open SWE 的任务集合编写的,因此路由器与 Open SWE 所处理的任务深度耦合。这就是它必须放在智能体框架里的原因, 因为智能体框架已经具备了任务相关的上下文(其提示词、工具与领域知识),而通用网关则缺乏这些。
我们的第一个版本使用了一个具备 结构化输出 能力的 LLM,由它根据用户请求做出分类。后来我们换用了新发布的决策模型 Jev,使分类速度提升到接近原来的 50 倍。具体做法见我们另一篇文章《使用 Jev 构建智能体框架》。
路由器在每个会话开始时一次性选定一个模型,并在整个会话生命周期内使用该模型。一个很自然的疑问是:如果某个会话中途切换主题或改变复杂度怎么办?这一朴素版路由器设计并未涵盖该问题,我们会在下文的“下一步”部分讨论会话中途的路由。