
模型在榜单上越来越强,为什么真正把工作交给AI,还是需要人反复解释、检查和兜底?
半年前,我们与阿里国际站总裁张阔聊了Accio Work,以及Agent如何参与采购和日常经营。半年后,我们再次请到他,聊聊这半年来商家使用Accio Work的真实案例,试图回答这个问题:模型能力的提升,究竟有多少变成了商家工作里的进步?
张阔分享,很多模型的通用评测成绩已经接近满分,但团队在真实经营中,并没有感受到同样幅度的提升。为此,他们从实际业务中整理了107个任务,包括比较供应商报价、识别钓鱼邮件、预订船期和处理交易纠纷。据他介绍,在这套特定评测中,最前沿模型在无人干预条件下的任务通过率约为61%。
这些任务没有数学竞赛那么耀眼,却直接关系到商家的成本、交期和利润。一个好用的Agent,既要能把工作做完,也要让人用得起;既要理解工具和流程,也要理解这盘生意究竟想追求什么。
这期节目,我们聊聊榜单成绩与实际交付之间的落差、通用模型与垂直产品的竞争,以及当AI接手越来越多的执行工作,人还需要保留哪些判断。
【主播】
Yiwen,硅谷101主持人
【嘉宾】
张阔,阿里国际站总裁
【你将听到】
从写代码到做生意,Agent还差什么?
- 01:18 AI同事市场:编程之外,专业工作走到了哪一步?
- 02:38 商业任务为什么比编程更难?
- 03:48 从采购搜索到日常经营,Accio Work的任务边界如何扩展
- 06:12 商家案例:植物监测产品,从创意走到设计、供应链和销售
- 07:47 找工厂、比报价、拿样品:采购流程里,人和AI如何协作
通用模型越来越强,垂直产品还有什么优势?
- 10:13 中美Agent生态的差异:垂直SaaS与平台工具
- 11:30 AI会替代SaaS吗?
- 14:11 独立站与平台电商:不同市场如何影响产品设计
- 15:16 Agent公式:模型 × 工程框架 × 上下文
- 17:46 模型与工程联合优化,不能只等模型升级
榜单接近满分,真实工作为什么还会失败?
- 20:29 107个真实任务:无人干预条件下,最前沿模型通过率约61%
- 24:32 报价、钓鱼邮件、订船和纠纷:怎样才算真正完成任务?
- 26:33 新版本也可能退步,评测必须持续做
- 28:55 多平台经营:有流水,不代表有利润
- 32:39 产品品味、市场判断与预算分配:老板仍要做的选择
最贵的模型,不一定是最好的选择
- 33:44 多模型路由:如何为不同任务匹配能力与成本?
- 38:05 多个Agent建议冲突,商家该听谁的?
- 40:35 上云、定时任务、事件响应与长期经营,是不同的能力
- 43:05 CoCreate现场:商家对Agent有哪些期待?
- 44:43 小企业如何借助AI,把生意做得更大
【往期相关】
E231|从B2B到A2A:Agent新基建,如何让"一人企业"做全球生意?
【硅谷101年会来了,线下见】
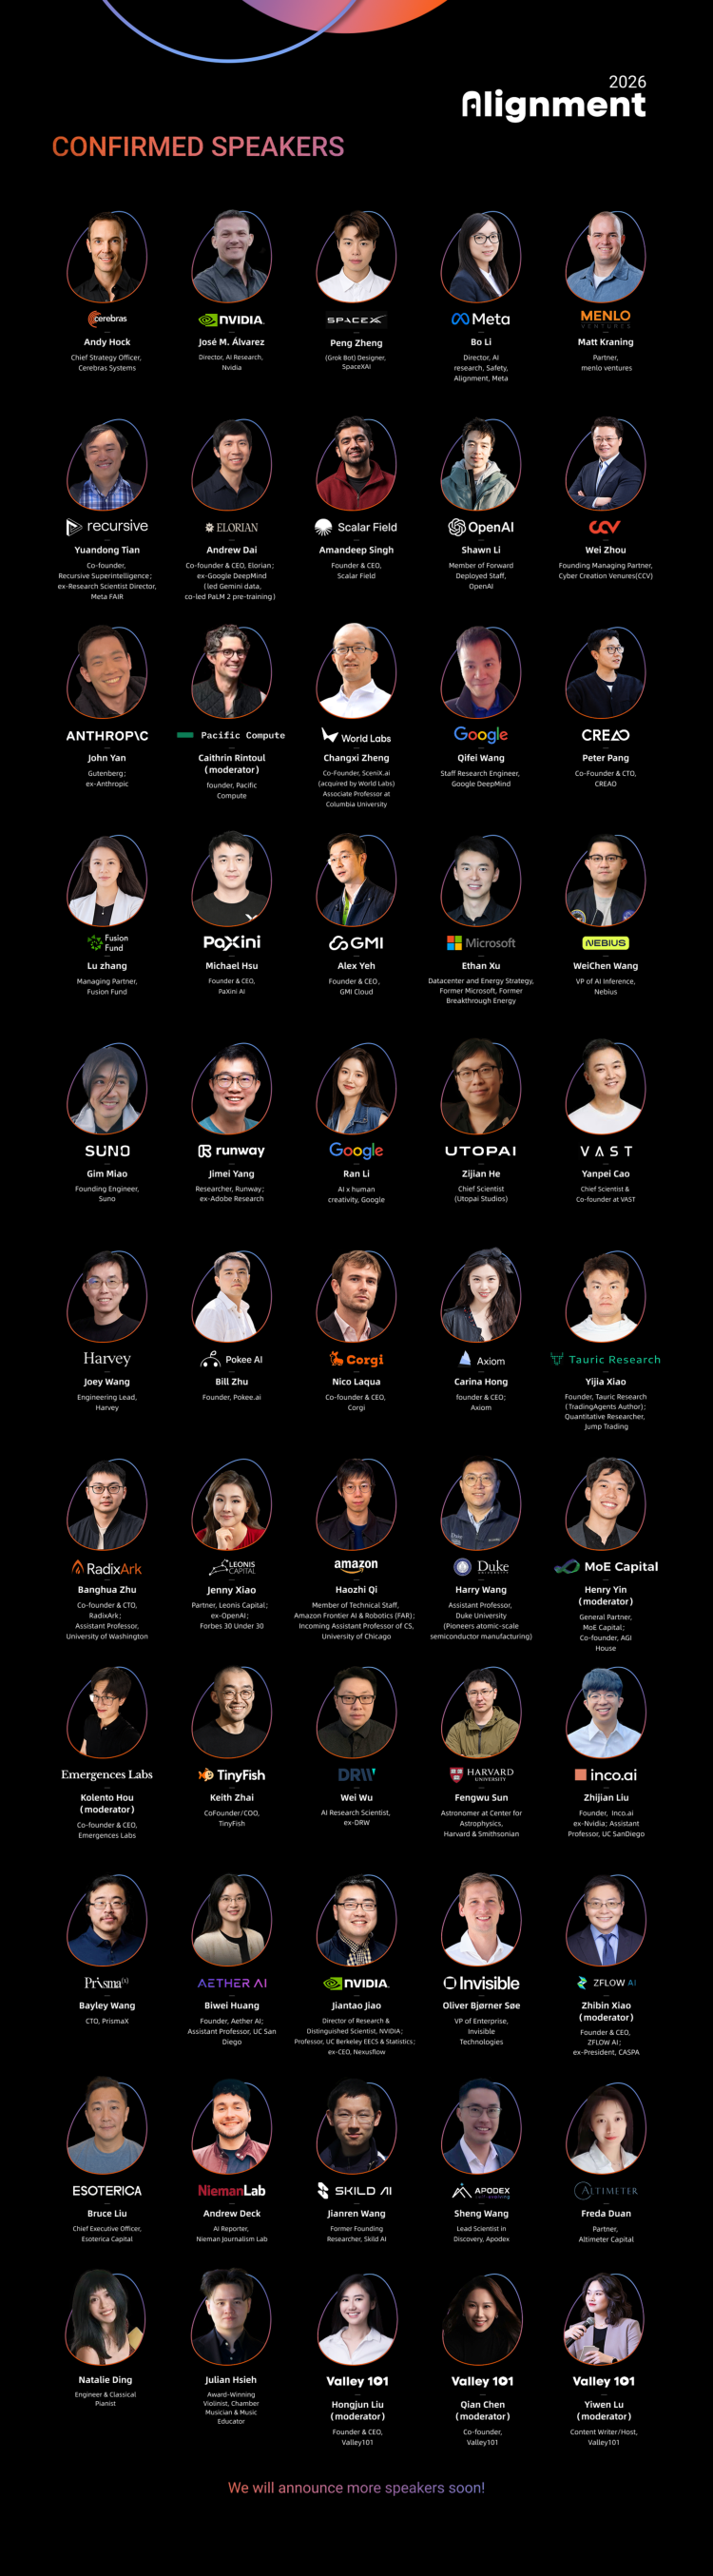
10月10日—11日,我们将在【硅谷】举办Alignment 2026年度大会,从大模型、Agent、机器人到AI Infra,从实验室里的突破,到真实世界的商业化,我们直击AI变化最剧烈的前沿。来自OpenAI、Anthropic、NVIDIA、Meta、Google DeepMind、SemiAnalysis、Cerebras等公司的研究者、创业者与投资人将齐聚现场,分享正在发生的机遇和挑战。
点击报名入口,使用折扣码【FANS15】注册,还可以获得15%折扣。


【硅谷101听友群】
在这里,和同好一起深聊科技、商业与未来,期待你的声音,也期待更多有趣的讨论。
扫码加入,即刻相遇!

【监制】
泓君
【后期】
Amei
【运营】
朱婕
【BGM】
Trace - Lennon Hutton
Signal Containment - Out To The World
Reclaim - Megan Wofford
【在这里找到我们】
公众号:硅谷101
收听渠道:Apple Podcast|Spotify|小宇宙|喜马拉雅|蜻蜓FM|荔枝FM|网易云音乐|QQ音乐
其他平台:YouTube|Bilibili 搜索「硅谷101播客」
联系我们:[email protected]

