被问麻了!Function Calling、MCP、Skill 到底啥关系?一张图讲透三层架构,附 Java 生产落地全流程 +30 个坑
最近不管是面试别人还是被人面,这个问题出现的频率高得离谱:“聊聊 Function Calling、MCP、Skill 三者的关系?”
十个人里八个答不利索:要么把三个概念搅成一团,要么只会背定义,一追问工程落地就露馅。
这篇文章一次性讲透:三者的分层关系、每层原理、完整 Java 落地代码,外加 30 多个真实生产踩坑。适合正在做 AI Agent 落地的 Java 工程师,也适合准备 AI 方向面试的朋友。建议先收藏,内容有点长。
一、先给结论:不是三选一,是三层楼
很多人一上来就想分个高下,其实方向就错了。这三个东西根本不是竞品,是一条流水线上的三个工位,自下而上层层封装:
| 概念 | 本质 | 解决什么问题 | 生活化类比 |
|---|---|---|---|
| Function Calling | 模型侧的原生能力 | 模型怎么表达调用意图:“我要调谁、传什么参数” | 🗣️ 食客的嘴:只会点菜,不会做菜 |
| MCP | 接入侧的开放协议 | 工具怎么被标准化发现、连接、跨进程调用 | 🔌 USB-C 接口 / 聚合支付:插上就能用 |
| Skill | 业务侧的封装单元 | 任务怎么按 SOP 干成:工具 + Prompt + 流程 + 知识 | 📘 岗位操作手册 / 预制菜谱 |
一句话记忆:FC 是嘴(管表达),MCP 是插座(管连接),Skill 是手册(管流程)。
在展开之前,先纠三个高频误区,这也是面试最容易失分的地方:
误区 1:“MCP 是 Function Calling 的升级版,有了 MCP 就不需要 FC 了。”
错。FC 是模型侧的表达层,MCP Client 收到模型意图后,底层依然是 FC 产生的 tool_call。二者是上下层,不是替代关系。没有 FC,MCP 的工具调不动;没有 MCP,工具接入就是点对点的泥潭。
误区 2:“Skill 和 MCP 是竞争关系。”
也不是。两者基本正交:Skill 可以只靠 FC + 脚本工作,不必依赖 MCP;MCP 也不需要 Skill 才能跑。当然,MCP 工作组正在推进 Skills over MCP 标准,2026 年这两层正在融合——提前知道这个趋势,面试会很加分。
误区 3:“MCP 是多智能体通信协议。”
不是。MCP 是应用 ↔ 工具的垂直连接;Agent ↔ Agent 的横向协作是 A2A 协议。两个概念分开说,专业度立刻上来了。
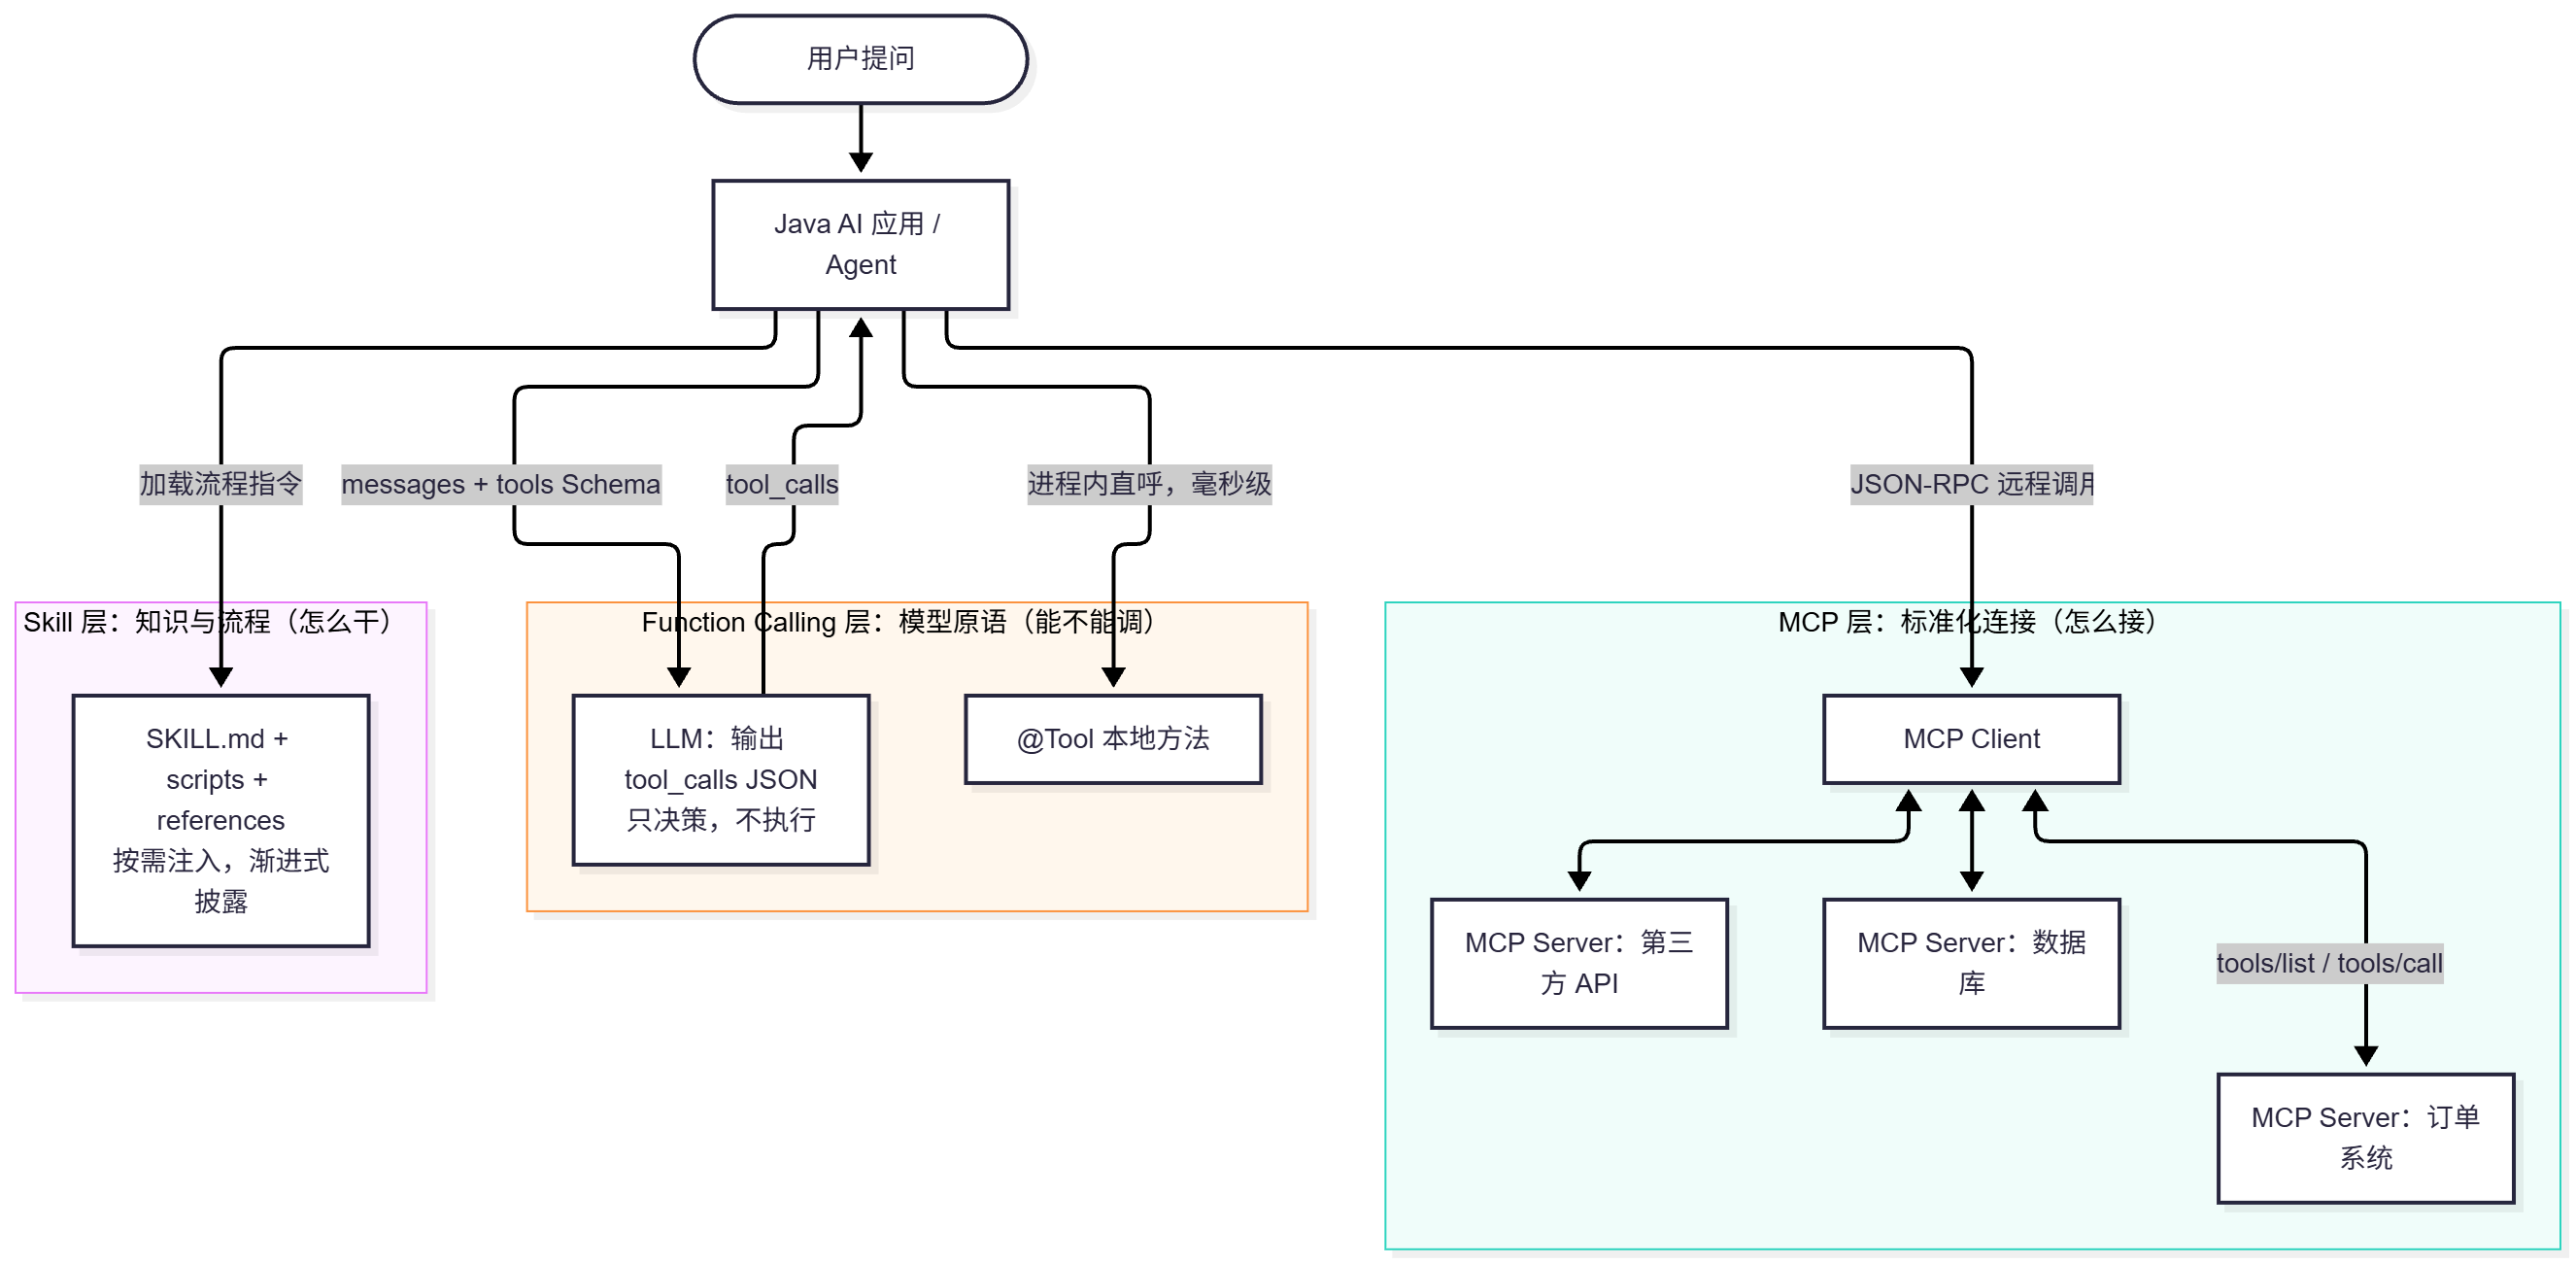
三者叠起来的整体架构长这样:
%%IMG1%%
图里其实藏着三条通路,实际开发中我们一般叫它们:
💡 划重点:Function Calling 让模型“知道能做什么”,MCP 让模型“能标准化地连接到什么”,Skill 让模型“知道该怎么做才靠谱”。
概念有了,接下来逐层拆。每一层我都会讲清楚“从哪来、是什么、缺什么”,这样你才能理解为什么架构要长成这样。
二、逐层拆解:三兄弟各自的定位
2.1 Function Calling:模型的“嘴”
出身:OpenAI 于 2023 年 6 月在 gpt-3.5-turbo 上首次引入。
本质:模型的一种原生能力——不是协议,不是框架。你按预定义的 JSON Schema 描述函数,模型判断需要时,吐出一个结构化的调用意图。
先看个最小的例子,有个直观感受:
public class WeatherTools {
    @Tool(description = "查询指定城市的实时天气,返回温度与天气现象")
    public WeatherInfo getWeather(
        @ToolParam(description = "城市名,如:北京") String city) {
        return weatherService.query(city);
    }
}这里有个关键认知,也是 FC 最容易被说反的地方:模型从不直接执行代码。它像一个只会点菜、不会做菜的食客——知道菜单上有啥、自己想吃啥,但端菜上桌跟它没关系。真正的执行永远在你的 JVM 里,整个闭环是这样的:
%%IMG2%%
“模型决策 + 应用执行 + 结果回传”,这三方契约才是 FC 的本质。
实际开发中,还有几个 FC 的关键细节值得记住:
- 工具调用的结果需要以
role="tool"的消息回传给模型,模型再据此生成自然语言回复。
也正因为执行权在你手上,鉴权、审批、限流、审计全部可以落在自己的 JVM 代码里——这是后面所有安全设计的根基。
但 FC 也有明显的局限,这些局限正是上面两层出现的原因:
- 工具描述全量塞进上下文,工具一多就爆 token;
- 跨应用复用难,A 应用的工具 B 应用要用,得重新对接;
- 工具的发现、版本管理、权限控制都得业务方自己造轮子。
2.2 MCP:AI 界的“USB-C 接口”
出身:Anthropic 于 2024 年 11 月开源,现已捐赠给 Linux 基金会旗下 AAIF 中立治理。
本质:一套标准化的客户端-服务器协议,基于 JSON-RPC 2.0。
它解决的痛点特别直白。没有 MCP 之前,每个应用自己手写对接代码,A 模型接天气写一套,B 模型再接还得写一套:
有 MCP 之前:N 个 AI 应用 × M 个工具 = N×M 种定制集成 😵
有了 MCP 后:N 个应用 + M 个 Server = N+M 种适配 😎
工具提供方封装成 MCP Server 独立部署,AI 应用作为 MCP Client 连接,通过标准接口发现和调用工具。拓扑结构是“一个 Client 对接一个 Server”:
%%IMG3%%
MCP Server 侧有三大原语,这是它比 FC 多出来的东西,也是面试加分点:
| 原语 | 控制方 | 用途 | 例子 |
|---|---|---|---|
| Tools 🛠️ | 模型自主决定 | 可执行函数 | query_order、refund |
| Resources 📄 | 应用控制 | 结构化上下文数据 | 文件内容、DB Schema、Git 历史 |
| Prompts 📝 | 用户控制 | 可复用提示词模板 | 斜杠命令、菜单项 |
💡 正因为多了 Resources 和 Prompts,MCP 才不只是“工具调用协议”,而是一个上下文中台。
协议层面,MCP 主要干了三件事:
- 能力协商:通过
initialize / initialized握手声明客户端与服务端支持哪些能力; - 工具发现:通过
tools/list拉取可用工具及参数 Schema; - 调用执行:通过
tools/call发起调用,参数和返回都用 JSON-RPC 2.0 描述。
传输方式目前主流是两种:
- 本地进程间:
stdio,适合单机部署、零网络开销; - 跨机器调用:
Streamable HTTP,基于标准 HTTP/2 流式传输。
⚡ 重点来了:2026-07-28 发布的第 5 版规范,官方定性为“自协议发布以来规模最大、最系统性的一次修订”,核心是从有状态连接全面转向无状态核心。这是本年度面试最值得说的点:
| 变更 | 内容 | 对 Java 后端意味着什么 |
|---|---|---|
| 🚫 移除握手 | initialize / initialized 握手删除 |
启动期不再有“协商一次”的全局状态 |
| 🚫 移除会话 | Mcp-Session-Id 请求头删除 |
不再需要 sticky session / 共享 Session 存储 |
| 📦 请求自描述 | 版本、clientInfo、capabilities 放进 _meta |
每个请求可落到任意实例,普通轮询 LB 即可 |
🔎 新增 server/discover |
客户端可主动探能力 | 能力发现不再依赖握手 |
| 🏷️ 强制路由头 | Streamable HTTP 必须带 Mcp-Method、Mcp-Name |
网关/WAF/限流器不用解 JSON body 就能路由鉴权 |
| ⏱️ 列表可缓存 | tools/list 等返回 ttlMs、cacheScope |
客户端可缓存工具列表,省 token、降延迟 |
| 🔄 MRTR 多轮往返 | 取代服务端主动请求(elicitation / sampling) | 中途要用户确认 → 返回 input_required,客户端带 inputResponses 重试 |
| ✅ Tasks 转正 | io.modelcontextprotocol/tasks 扩展,tasks/get 轮询 |
长任务终于有原生协议支持 |
| 🔐 鉴权加固 | 强化 OAuth 2.0 / OIDC(RFC 9207 签发者校验) | 可直连 Entra / Okta 等企业 IAM |
| ⚠️ 弃用清单 | Roots / Sampling / Logging / HTTP+SSE,至少 12 个月兼容期 | 升级窗口要排期 |
💡 一句话理解这次修订:MCP 从“工具调用协议”升级成了“AI 原生应用交付协议”——工具 + UI + 任务 + 授权 = 完整能力包。无状态化是所有通用协议走向生产级基础设施的必经之路,改造后你的 MCP Server 就是一个普通 HTTP 微服务,随便扩缩容、滚动发布,故障切换从“会话迁移”变成“DNS 切换”。
工程上,MCP 的价值还体现在:工具独立进程部署、独立升级、独立鉴权,业务系统零侵入接入。
MCP 这部分信息量有点大,先消化一下。下一节讲 Skill——它是三者里最容易被低估、也最容易出彩的一个。
2.3 Skill:把经验打包成“技能书”
出身:Anthropic 2025 年 10 月推出,2025 年 12 月 18 日开放为跨平台标准(agentskills.io)。
本质:一种知识/流程的打包格式——就是文件,不是框架。一个 Skill 就是一个文件夹:
aftersale-refund/
├── SKILL.md          # 核心:YAML 元数据 + Markdown 操作指令
├── scripts/          # 可执行脚本(Python / bash),代码不进上下文
│   └── create_ticket.py
├── references/       # 参考资料:政策文档、Schema、模板
│   ├── refund-policy.md
│   └── reply-template.md
└── assets/           # 模板、素材
很多人只说“Skill 就是 prompt 模板”,这个理解太浅了。Skill 的灵魂是渐进式披露(Progressive Disclosure):
| 层级 | 内容 | 加载时机 | 成本 |
|---|---|---|---|
| L1 | name + description |
启动时常驻 | 约 30~100 token/个 |
| L2 | SKILL.md 正文 SOP | 任务命中才加载 | < 5k token |
| L3 | scripts/、references/ |
按需执行,源码不进上下文,只有输出进 | 几乎无限 |
💡 这个设计牛在哪:企业可以装 100 个 Skill 而上下文不爆。官方原话说得很直白——“with a filesystem and code execution tools, the amount of context that can be bundled into a skill is effectively unbounded”。
对比一下 MCP:所有 Server 的工具描述在会话启动时就要全部塞进上下文,装多了 token 消耗非常可观(后面踩坑篇会讲,连 3 个 MCP Server 启动就能吃掉 2~7 万 token)。
Skill 和 Function Calling 的本质区别,一张表说清:
| 维度 | Function Calling | Skill |
|---|---|---|
| 粒度 | 原子能力(单个函数) | 任务模块(一套流程) |
| 构成 | JSON Schema 函数定义 | Prompt + 代码 + 流程定义 + 异常处理 |
| 解决的问题 | “能不能调” | “该不该这么调” |
| 可复用性 | 单个工具级别 | 业务场景级别 |
| 示例 | queryOrder() |
“订单退款”完整流程 |
用代码视角看更直观:
Function Calling : queryOrder(orderNo) → 一次原子调用
Skill : handleAfterSales(诉求) → 理解 → 查单 → 判责 → 生成方案 → 发通知
└─ 内部可能触发 5 次 Function Call + 2 次子 Skill
在真实业务里,一个 Skill 往往包含这些东西:
refund_skill
├─ query_order          查询订单
├─ check_refund_rule    校验退款规则
├─ create_refund        创建退款单
├─ notify_user          通知用户
└─ 高危确认策略 需要用户或管理员确认也就是说:Skill = Prompt 模板 + 一个或多个 Tool + 参数校验规则 + 权限策略 + 结果摘要策略 + 人工确认流程。
它可组合、可版本化、可灰度、可复用,是 Agent 资产化的核心——这也是为什么我说它最容易出彩:工具是死的,Skill 才是沉淀团队经验的地方。
三、横向对比:一张总表看懂三者
把前面的信息汇总,这张表建议直接存下来:
| 维度 | 🗣️ Function Calling | 🔌 MCP | 📘 Skill |
|---|---|---|---|
| 本质 | 模型原生能力 | 开放协议(JSON-RPC 2.0) | 知识打包格式(文件夹) |
| 解决的问题 | 模型怎么表达调用意图 | 工具怎么标准化接入 | 任务怎么做才对 |
| 提出者 / 时间 | OpenAI · 2023.06 | Anthropic · 2024.11 | Anthropic · 2025.10 |
| 粒度 | 单个函数(原子) | 一组工具/资源/提示 | 一个业务流程 / SOP |
| 谁定义 | 模型训练 + 开发者 Schema | Server 提供方 | 业务/领域专家 |
| 通信方式 | 请求里带 tools 定义,无状态 | stdio / Streamable HTTP | 文件系统,无需运行时 |
| 工具发现 | 硬编码或手工传入 | 服务端动态注册 tools/list |
在配置中心/目录声明式管理 |
| 跨应用复用 | ❌ 强绑定当前应用与模型 | ✅ 一次部署、任意客户端可连 | ✅ 一次安装、任意 Agent 可用 |
| 换模型成本 | 高(Schema 重适配) | 低(协议中立) | 无 |
| token 成本 | Schema 全量进上下文 | 同上,但可列表缓存 | 渐进披露,起步 ~30 token |
| 安全机制 | 需业务代码自行校验 | 内置权限、授权规范 | 基于底层能力 + 业务级护栏 |
| 失败模式 | 参数幻觉 / 误调用 | 连接断开 / 超时 | 规划漂移 / 死循环 |
| Java 生态 | Spring AI @Tool / LangChain4j |
Spring AI MCP Starter / MCP Java SDK | 无框架依赖,纯文件 + 脚本 |
📖 有人总结得很到位:Skills 是任务的高级模板(SOP + Tools),Tools 是能力的低层接口(API)。
四、选型决策:什么场景用什么
面试高频追问:“那你们项目里怎么选?”我的答案是先看决策树:
%%IMG4%%
再配一张场景速查表:
| 你的场景 | 推荐 | 理由 |
|---|---|---|
| 单体 Spring Boot 应用,工具 < 10 个 | 🧩 Function Calling | 零网络开销,@Tool 五分钟接入 |
| 工具要被 Claude / Cursor / 多个内部 Agent 复用 | 🌐 MCP | 协议标准、独立部署、生态互通 |
| 任务流程固定且反复出现(写周报、发版、审 PR) | 📦 Skill | 沉淀 SOP,团队共享,不占常驻上下文 |
| 大型平台级 Agent(工具 50+) | 🌐 MCP + 📦 Skill 组合 | MCP 管连接,Skill 管流程与按需加载 |
什么时候必须上 MCP? 出现下面任意一个信号就别犹豫了:
- 工具要被多个不同的 Agent / IDE / 模型客户端复用;
- 工具需要独立团队独立迭代、独立部署;
- 工具数量超过 20 个,集中管理胜过散落各处。
反过来,如果只是个人项目或内部几个简单 API,直接 @Tool 绑定就够,千万别硬上三层,那是给自己找运维。
💡 大厂真实答案:FC 是地基,MCP 是水电煤,Skill 是 SOP——生产上三者常常叠着用。但选型永远记住八个字:小而内用,够用就好。
一句话记忆选型:知识 → Skill;连接 → MCP;单应用单模型 → Function Calling;跨 Agent 委派 → A2A。
五、Java 落地全流程(可直接抄)
好,概念讲完,上硬菜。这部分以 Spring AI 为主线,LangChain4j 为辅,环境、代码、配置一次给全。
5.0 环境基线(别在这些地方翻车)
JDK 17+              ← Spring Boot 3.x 硬要求,JDK 8 直接劝退
Spring Boot 3.2+
Spring AI 1.x GA / 2.x(或 MCP Java SDK 1.0.0+)
<!-- pom.xml:Spring AI BOM 统一管理版本 -->
<dependencyManagement>
<dependencies>
<dependency>
<groupId>org.springframework.ai</groupId>
<artifactId>spring-ai-bom</artifactId>
<version>2.0.0</version>
<type>pom</type>
<scope>import</scope>
</dependency>
</dependencies>
</dependencyManagement>⚠️ 注解包名和 Starter 名称随版本演进很快,落地时以你锁定版本的官方文档为准,别抄错包。上线前最好跑一下 mvn dependency:tree -Dincludes=io.modelcontextprotocol.sdk 核实 MCP SDK 的真实版本。