Vivek Trivedy 与 Mason Daugherty,2026 年 4 月 2 日,7 分钟阅读。
核心要点
简要结论: GLM-5 和 MiniMax M2.7 等开源模型在核心 Agent 任务——文件操作、工具调用与指令遵循——上已经达到与闭源前沿模型相当的水平,同时在成本和延迟上低得多。本文将分享我们的评估结果,并介绍如何在 Deep Agents 中开始使用这些模型。
过去几周,我们一直在使用 Deep Agents 这一智能体框架对一组开放权重大语言模型进行评估,初步结果显示:它们既能作为闭源前沿模型的替代方案,也能与之协同使用。GLM-5(z.ai)和 MiniMax M2.7 在文件操作、工具调用与指令遵循等核心 Agent 任务上,得分都与闭源前沿模型相近。
如果你一直在通过 SWE-Rebench 和 Terminal Bench 2.0 等大量公开基准跟踪开源模型的进展,那么这个结果并不令人意外:工具调用已经稳定可靠,指令遵循也保持一致。对于将 Agent 部署在生产环境中的开发者而言,开源模型现在提供了一种更高的一致性和可预测性,使真实场景的工作流真正具备了落地可行性。
为什么选择开源模型
在探索开源模型时,开发者和客户通常会关注几个关键因素:成本、延迟和任务表现。
理想情况下,我们当然希望对每一个任务都使用最聪明的前沿模型,并以最高推理档位运行。但在实践中,两个约束让这种设想难以落地:成本和延迟。闭源前沿模型在高吞吐量工作负载下可能要贵上 8 到 10 倍,且响应时间往往慢到无法满足交互式产品对响应速度的预期。
| 模型 | 类型 | 输入(美元/百万 tokens) | 输出(美元/百万 tokens) |
|---|---|---|---|
| Claude Opus 4.6(Anthropic) | 闭源 | 5.00 | 25.00 |
| Claude Sonnet 4.6(Anthropic) | 闭源 | 3.00 | 15.00 |
| GPT-5.4(OpenAI) | 闭源 | 2.50 | 15.00 |
| GLM-5(Baseten) | 开源 | 0.95 | 3.15 |
| MiniMax M2.7(OpenRouter) | 开源 | 0.30 | 1.20 |
为了让定价更有参照感:一个每天输出 1000 万 tokens 的应用,使用 Opus 4.6 大约每天花费 250 美元,而使用 MiniMax M2.7 仅需约 12 美元,全年相差约 8.7 万美元。
开源模型通常比闭源前沿模型更小,并且可以在专用的推理基础设施上加速运行——Groq、Fireworks 和 Baseten 等服务商在延迟和吞吐量方面的优化远非大多数团队凭一己之力所能达到。OpenRouter 的数据显示,部署在 Baseten 上的 GLM-5 平均延迟为 0.65 秒、每秒 70 tokens,相比之下 Claude Opus 4.6 为 2.56 秒、每秒 34 tokens。对于延迟敏感的产品而言,这一差距很难通过工程手段弥补。
我们的评估方法
我们在 《如何为 Deep Agents 构建评估》一文中详细介绍了评估方法论。我们使用托管推理服务商来运行评估,但 Deep Agents 同样可以通过 Ollama、vLLM 等方式在完全本地且私有的模型上运行。
针对开源模型,我们运行了七个类别的评估:文件操作、工具调用、检索、对话、记忆、摘要,以及"单元测试"。这些类别考察的是基础能力:模型能否稳定地调用工具、遵循结构化指令以及操作文件?这些能力决定了一个模型是否能够在 Agent 框架中真正可用。
每个评估用例定义了成功断言(决定正确性的硬性检查)和效率断言(衡量模型如何完成任务的软性检查)。我们报告四项指标:
- 正确率(Correctness)——模型通过测试的比例,即
passed / total。0.68 表示 68% 的测试用例被正确解决。这是首要的质量信号。 - 解题速度(Solve Rate)——准确率与速度的综合度量。对每个测试,我们计算
expected_steps / wall_clock_seconds;失败的测试计为零。最终得分为所有测试的平均值,越高越好——既能正确解题又能快速完成的模型得分最高。 - 步数比(Step Ratio)——模型实际执行的 Agent 步数与预期步数之比,在所有测试上汇总:
total_actual_steps / total_expected_steps。1.0 表示模型恰好使用了预期数量的步数;大于 1.0 表示所用步数偏多(效率较低);小于 1.0 表示所用步数少于最初预期。 - 工具调用比(Tool Call Ratio)——与步数比类似,但统计的是单次工具调用而非步骤。1.0 为符合预算;高于 1.0 为超出预算;低于 1.0 为低于预算。
步数比和工具调用比属于效率类指标,它们并不影响测试是否通过,但能揭示模型以多经济的方式得到答案。一个在 2 步内解决任务(而预期为 5 步)的模型,既是正确的,又是高效的。
评估结果
这些仍是早期结果,我们正在持续维护和扩展评估集。你可以实时查看最新运行结果,地点包括 我们的 GitHub 仓库 以及 这个共享的 LangSmith 项目。
开源模型
查看 CI 运行(点击模型名称可查看单项评估)
| 模型 | 正确率 | 通过数 | 解题速度 | 步数比 | 工具调用比 |
|---|---|---|---|---|---|
| baseten:zai-org/GLM-5 | 0.64 | 94 / 138 | 1.17 | 1.02 | 1.06 |
| ollama:minimax-m2.7 | 0.57 | 85 / 138 | 0.27 | 1.02 | 1.04 |
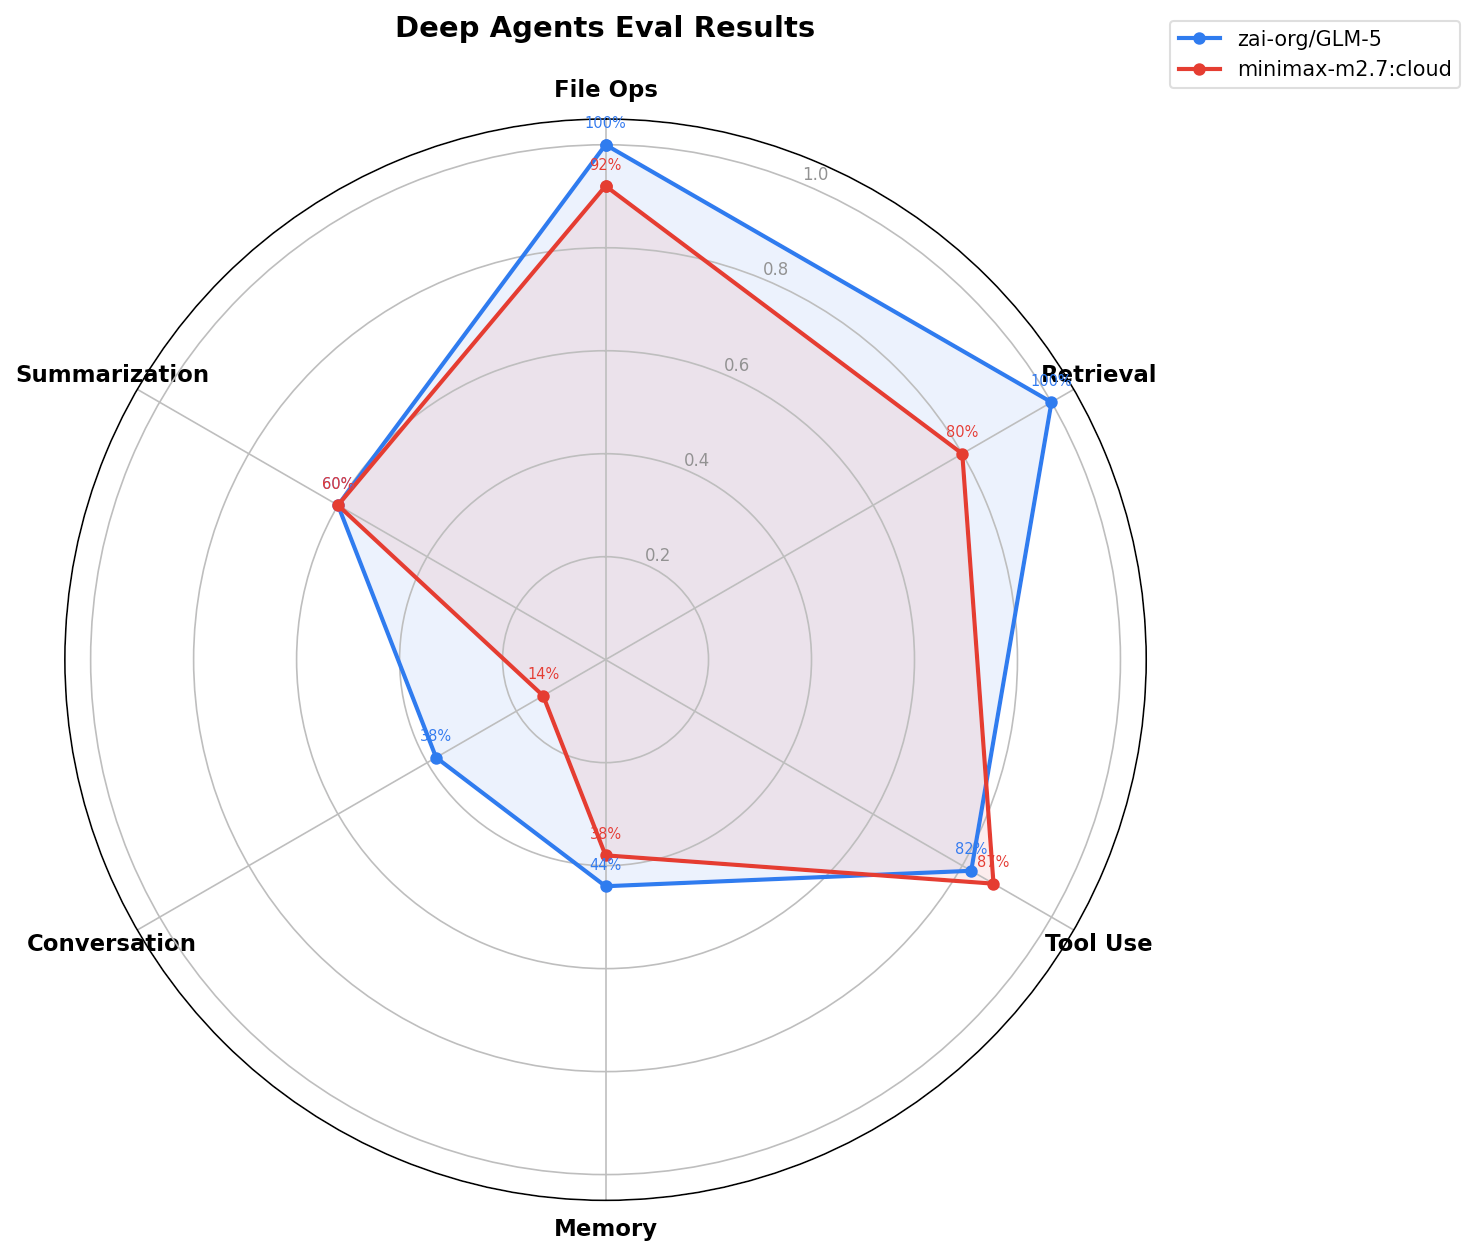
按类别细分正确率:
| 模型 | 对话 | 文件操作 | 记忆 | 检索 | 摘要 | 工具调用 | 单元测试 |
|---|---|---|---|---|---|---|---|
| baseten:zai-org/GLM-5 | 0.38 | 1 | 0.44 | 1 | 0.6 | 0.82 | 1 |
| ollama:minimax-m2.7:cloud | 0.14 | 0.92 | 0.38 | 0.8 | 0.6 | 0.87 | 0.92 |
前沿模型
查看 CI 运行(点击模型名称可查看单项评估)
| 模型 | 正确率 | 通过数 | 解题速度 | 步数比 | 工具调用比 |
|---|---|---|---|---|---|
| anthropic:claude-opus-4-6 | 0.68 | 100 / 138 | 0.38 | 0.99 | 1.02 |
| google_genai:gemini-3.1-pro-preview | 0.65 | 96 / 138 | 0.26 | 0.99 | 1.01 |
| openai:gpt-5.4 | 0.61 | 91 / 138 | 0.61 | 1.05 | 1.15 |
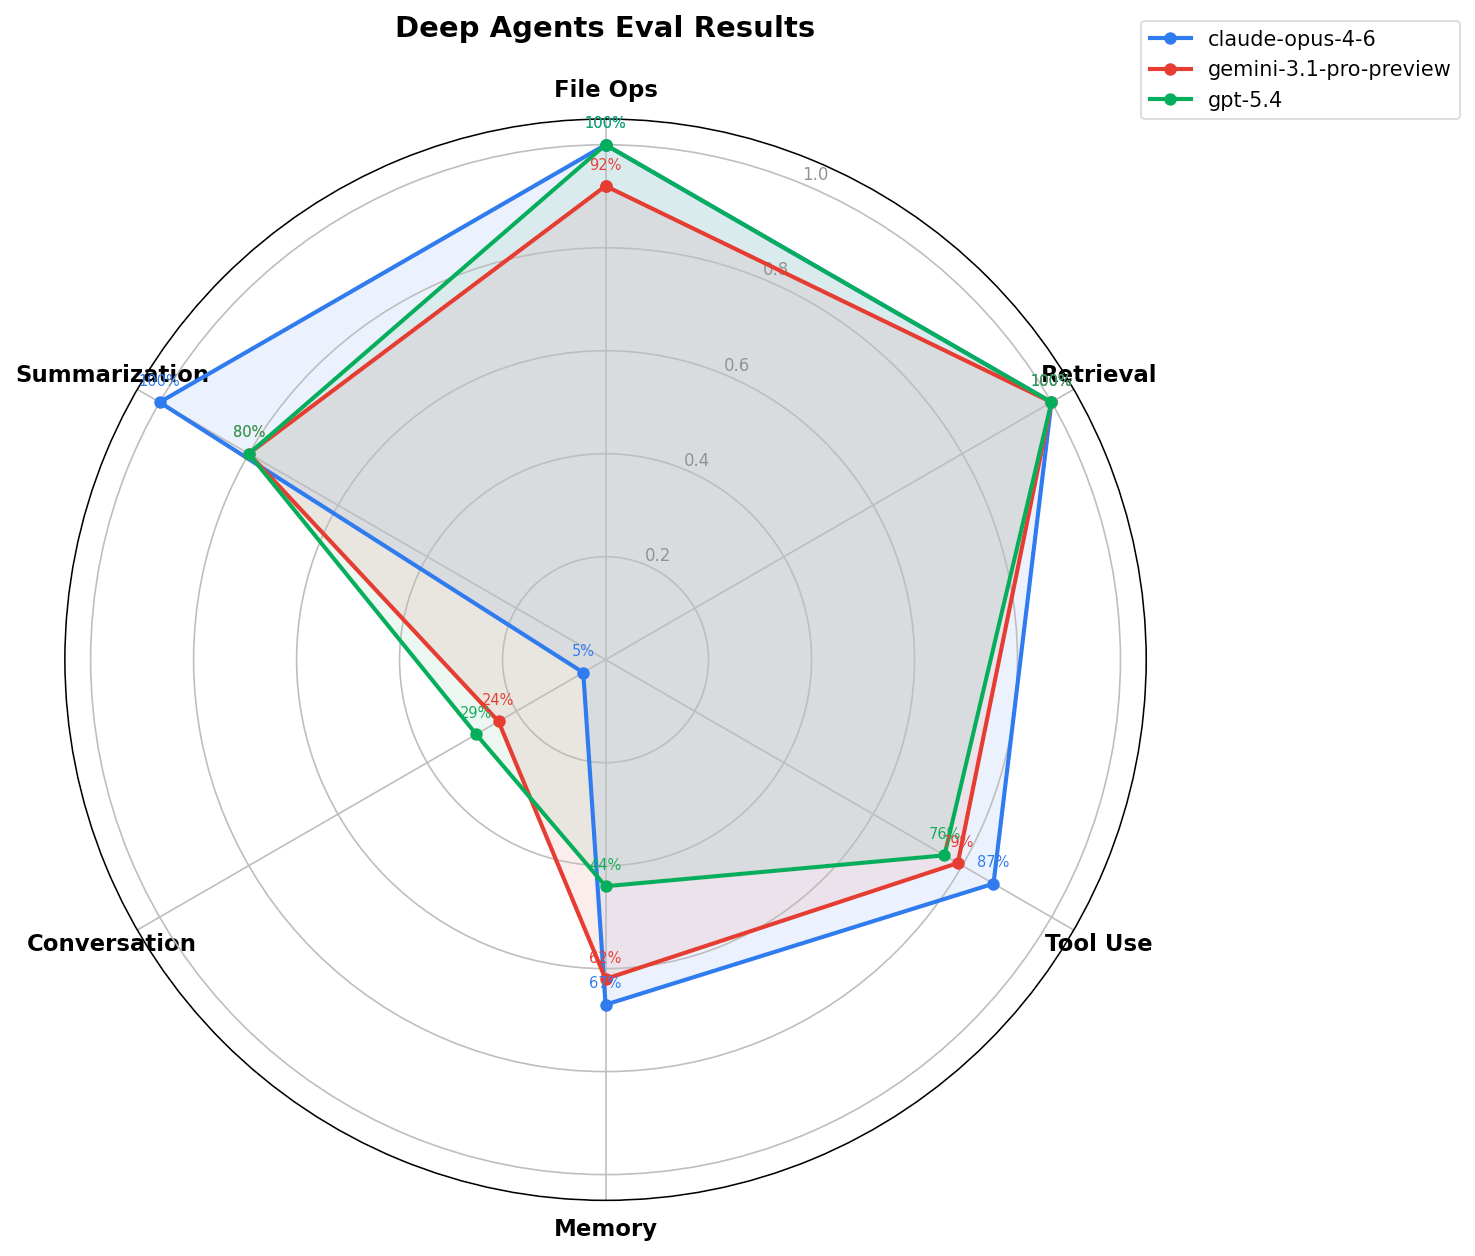
按类别细分正确率:
| 模型 | 对话 | 文件操作 | 记忆 | 检索 | 摘要 | 工具调用 | 单元测试 |
|---|---|---|---|---|---|---|---|
| anthropic:claude-opus-4-6 | 0.05 | 1 | 0.67 | 1 | 1 | 0.87 | 1 |
| google_genai:gemini-3.1-pro-preview | 0.24 | 0.92 | 0.62 | 1 | 0.8 | 0.79 | 0.92 |
| openai:gpt-5.4 | 0.29 | 1 | 0.44 | 1 | 0.8 | 0.76 | 1 |
针对每个模型,我们选择使用服务商默认的思考档位:对于 Gemini 3+,默认档位为 high;对于 OpenAI,默认档位为 medium;对于 Claude,则不使用扩展思考。
自行运行:在本地复现 Deep Agent 评估
我们的 CI 在 52 个模型上运行同一套评估套件,这些模型被分成若干组,其中包含一个 open(开源)组(baseten:zai-org/GLM-5、ollama:minimax-m2.7:cloud、ollama:nemotron-3-super),该组会在每次评估工作流中运行。你也可以指定任意模型组:
# 针对所有开源模型运行评估
pytest tests/evals --model-group open

# 针对单个模型运行评估
pytest tests/evals --model baseten:zai-org/GLM-5
这样一来,便可以非常方便地在同一组任务、同一套评分标准下,将开源模型彼此之间以及与闭源前沿模型进行对比。
在 Deep Agents SDK 中使用开源模型
切换到开源模型只需要改动一行代码:
GLM-5:
# pip install langchain-baseten
from deepagents import create_deep_agent

agent = create_deep_agent(model="baseten:zai-org/GLM-5")
MiniMax M2.7:
# pip install langchain-openrouter
from deepagents import create_deep_agent

agent = create_deep_agent(model="openrouter:minimax/minimax-m2.7")
仅此而已,剩下的交给框架完成——它会自动检测模型的上下文窗口大小、禁用不支持的模态,并将正确的模型身份注入系统提示,使 Agent 清楚自己正在使用的是哪种模型。
同一个开源模型通常可以通过多家服务商获得,你可以按需挑选最匹配自身约束的那一家。例如,GLM-5 既可作为 baseten:zai-org/GLM-5(Baseten)、fireworks:fireworks/glm-5(Fireworks),也可作为 ollama:glm-5(Ollama,用于自托管)。同一个模型、同一个框架,只是底层基础设施不同。
LangChain 为最主流的开源模型服务商提供了支持。本次发布中,我们实际测试过的服务商包括:Baseten、Fireworks、Groq、OpenRouter 以及 Ollama(云端版本)。