用 Harness Engineering 改进深度代理
Vivek Trivedy2026年2月17日8分钟阅读返回博客创建代理创建代理分享
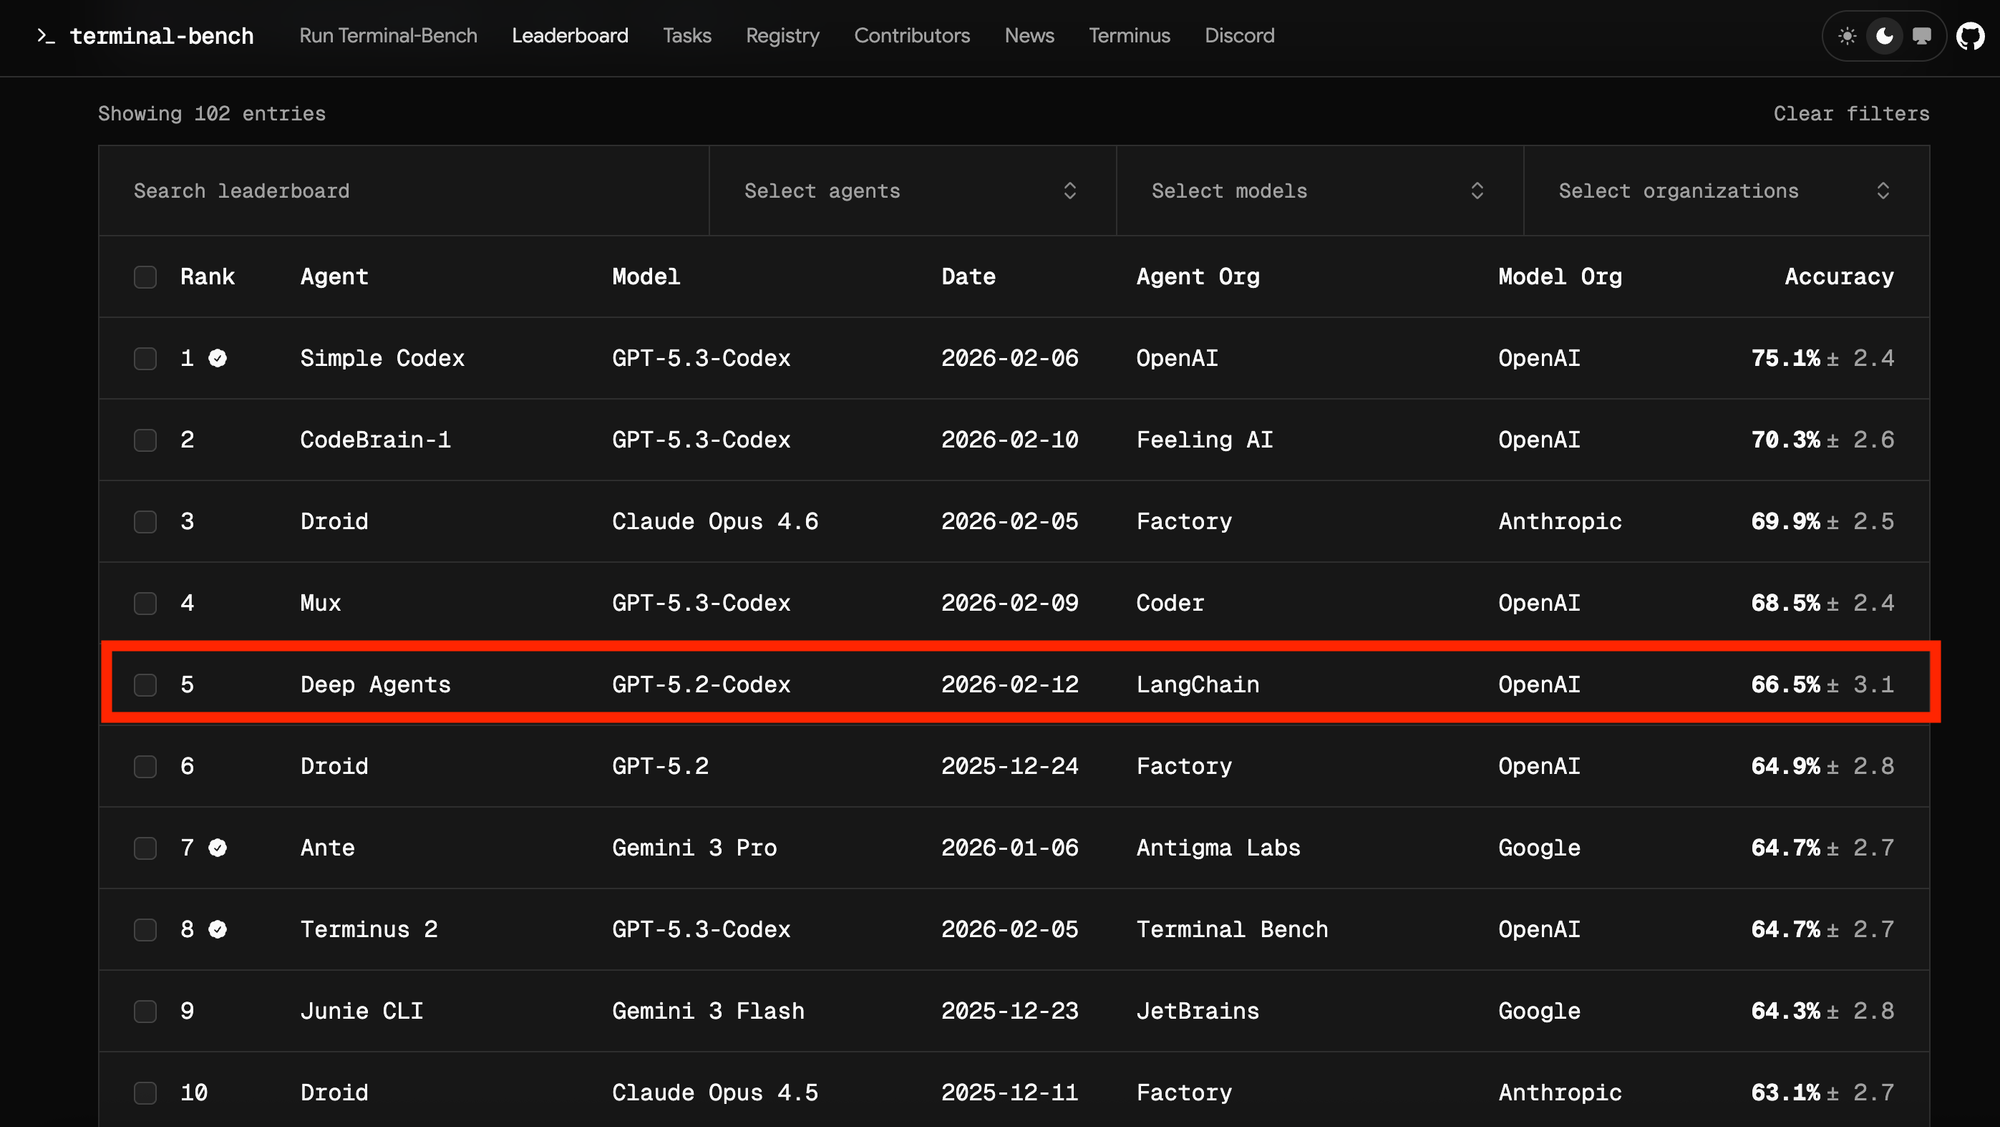
TL;DR(简要总结):我们的编码代理在 Terminal Bench 2.0 上的排名从第 30 名左右跃升至第 5 名,而我们只调整了 Harness(执行框架)。下文将介绍我们做 Harness Engineering 的方法(先提示一下:自我验证与链路追踪帮了大忙)。
Harness Engineering 的目标
Harness 的目标是让模型本身参差不齐的智能表现,能够稳定地完成我们关心的任务。Harness Engineering 是围绕模型的系统工程:你在模型之外搭建工具链,以优化任务表现、Token 效率、延迟等目标。设计决策包括系统提示、工具选择与执行流程。
但我们究竟应该如何调整 Harness 来改进代理?
在 LangChain,我们使用 Traces(链路追踪) 来规模化地理解代理的失效方式。当今的模型在很大程度上仍是黑盒——其内部机理难以解读。但我们可以在文本空间里看到它们的输入与输出,并以此驱动我们的迭代改进闭环。
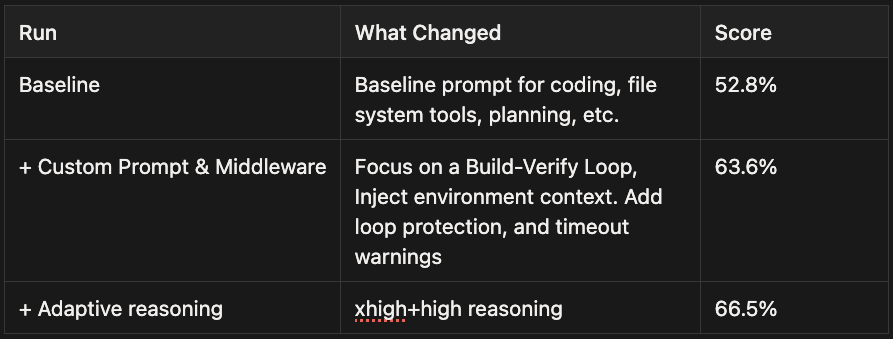
我们使用了一套简单的“菜谱”,将 deepagents-cli(我们的编码代理)在 Terminal Bench 2.0 上的得分从 52.8 提升到 66.5,足足提高了 13.7 分。整个过程中我们仅微调了 Harness,并固定模型为 gpt-5.2-codex。

实验设置与 Harness 上的旋钮
我们使用 Terminal Bench 2.0,这是如今评估编码代理的事实标准基准。它包含 89 个跨机器学习、调试、生物学等领域的任务。我们使用 Harbor 来编排运行:它会启动沙箱(Daytona),与代理循环交互,并执行验证与打分。
代理的每一个动作都会存储到 LangSmith,其中还包含延迟、Token 计数与成本等指标。
我们能拧动的旋钮
代理 Harness 上有大量可调旋钮:系统提示、工具、Hooks/Middleware、技能(Skills)、子代理委派、记忆系统,等等。我们有意压缩优化空间,只聚焦其中三项:系统提示、工具,以及 Middleware(中间件)(我们用来指代围绕模型与工具调用的钩子的术语)。
我们从一个默认提示加上标准工具+中间件的版本起步,在 GPT-5.2-Codex 上得分 52.8%。这是一个不错的成绩,刚刚落在当前排行榜前 30 之外,但还有提升空间。
Trace Analyzer 技能
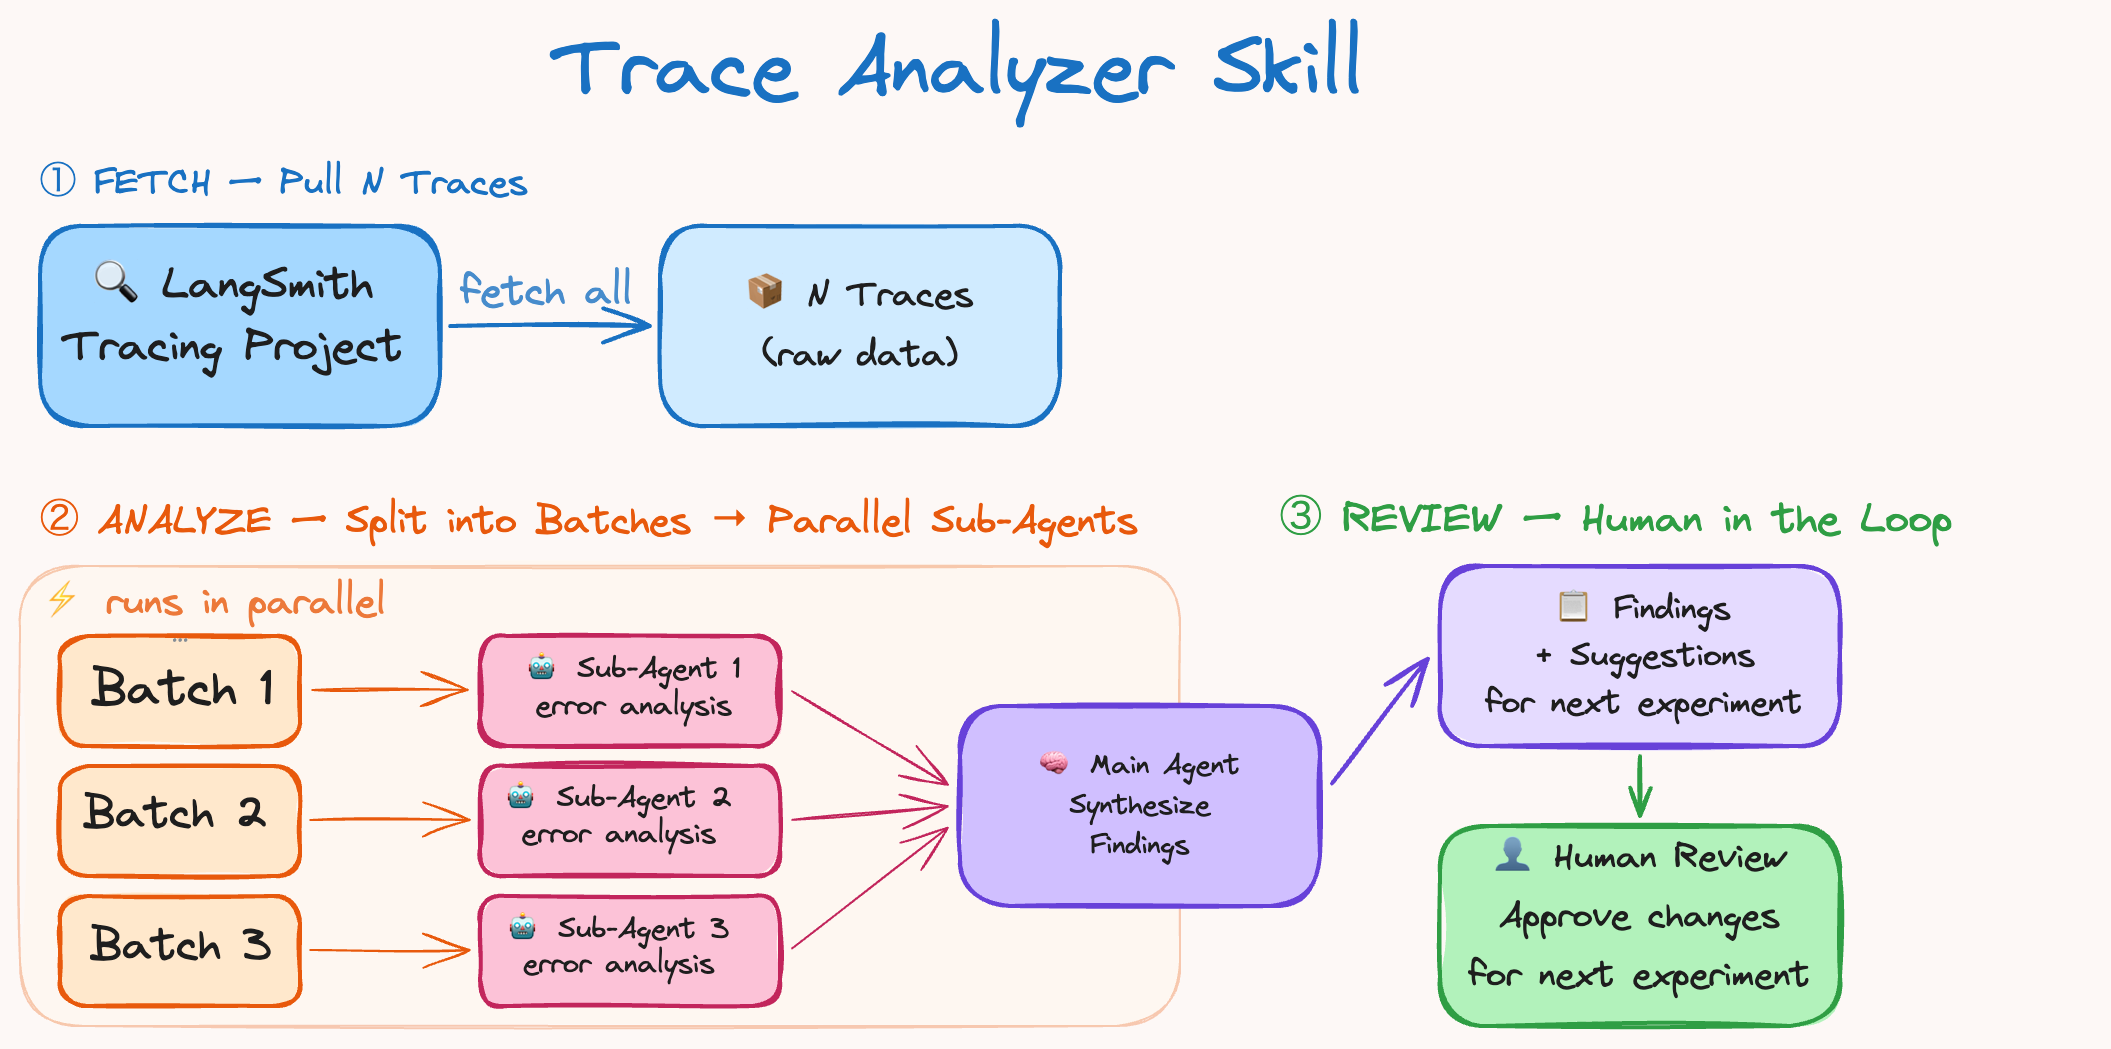
我们希望链路分析可以重复执行,于是把它做成了一项代理技能(Agent Skill)。它充当我们的“菜谱”,用来跨多次运行分析错误并改进 Harness。流程如下:
- 从 LangSmith 拉取实验链路
- 并行启动错误分析代理 → 主代理综合归纳出结论与改进建议
- 汇总反馈,针对性地修改 Harness
这套机制与 Boosting(提升法) 的思路类似——专注于上一次运行的失误。第 3 步中,由人来验证与讨论提议的改动通常很有帮助(虽然并非强制)。需要警惕的是:过度拟合某个任务的改动会损害泛化能力,并可能在其他任务上引发回退。
自动化链路分析节省了大量时间,让我们可以快速验证实验。我们很快会公开这项技能,目前正把它泛化用于更广泛的提示优化场景。
真正提升代理表现的要素
自动化链路分析让我们得以定位代理究竟在哪里出错。问题包括:推理错误、未遵循任务要求、缺少测试与验证流程、超时,等等。下面的章节将更详细地展开这些改进。
构建与自我验证
当今的模型都是出色的“自我改进机器”。
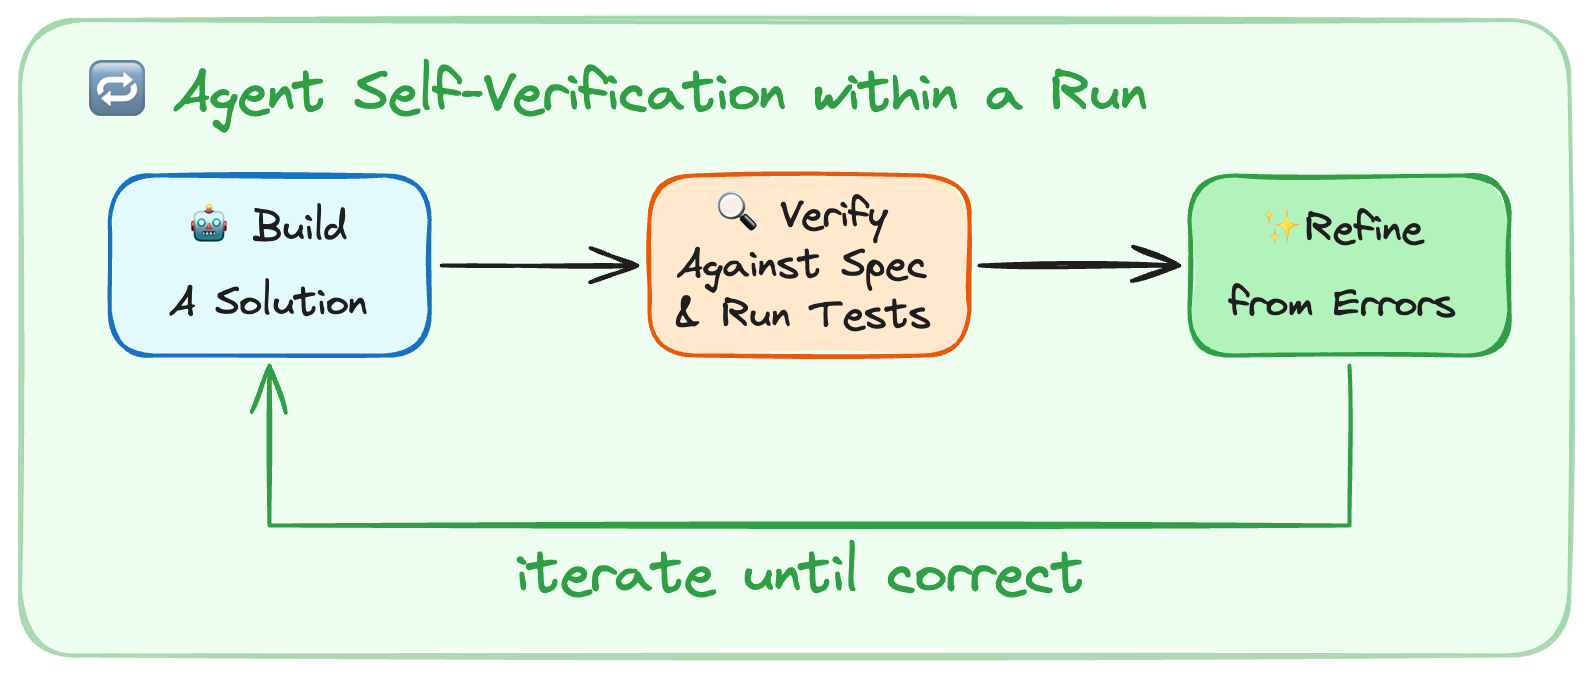
自我验证让代理能够在一次运行内通过反馈进行自我改进。然而,它们天然地并不会主动进入这种构建—验证循环。
最常见的失败模式是:代理写完方案后,回看一遍自己的代码,确认“看起来还行”,然后就停下了。测试是自主编码代理的关键一环:它既能帮助检验整体正确性,又能给代理提供迭代爬升的信号。
我们在系统提示中补充了关于问题求解方法论的指引:
- 规划与探索(Planning & Discovery): 阅读任务要求,扫描代码库,围绕任务规格以及如何验证方案,构建初步计划。
- 构建(Build): 在实现时心中有验证。如果还没有测试就补上,并对正常路径与边界情况都加以覆盖。
- 验证(Verify): 运行测试,通读完整输出,将结果与任务要求进行比对(而不是和“自己写过的代码”比对)。
- 修复(Fix): 分析报错,回看原始规格说明,并修复问题。
我们格外强调测试,因为它是每一轮迭代得以推进的引擎。我们发现:在提示之外,向代理确定性地注入上下文,能显著帮助代理验证成果。具体做法是使用一个 PreCompletionChecklistMiddleware(完成前清单中间件),它在代理即将退出时介入,提醒它针对任务规格跑一遍验证。这与 Ralph Wiggum Loop 的思路类似——用钩子在退出时强制代理继续执行,我们把这一机制用在“验证”环节。
让代理了解其所处的环境
Harness Engineering 的一部分,是为上下文工程搭建一套良好的交付机制。Terminal Bench 的任务会附带目录结构、内置工具以及严格的超时限制。
- 目录上下文与工具:
LocalContextMiddleware(本地上下文中间件)在代理启动时运行,绘制出cwd(当前工作目录)及其上级、下级目录结构。我们通过运行bash命令来定位Python等工具的安装位置。环境探查与搜索容易出错,注入上下文能缩小出错空间,并帮助代理顺利进入其工作环境。 - 教代理写出可测试的代码: 代理并不知道自己的代码需要“可测试”。我们加入提示,告诉它们提交的工作将通过程序化测试来衡量——这与平时提交代码时遵循的规范类似。例如,任务规格中提到的文件路径必须严格遵守,以确保方案能在自动评分环节正常工作。强调边界情况的提示,有助于防止代理只检查“正常路径”用例。强迫模型遵守测试规范,是一种避免随时间推移“代码泥球化”的强效策略。
- 时间预算: 我们向代理注入时间预算警告,以推动它尽早收尾并转向验证。众所周知,代理在时间估计上表现糟糕,因此这种启发式在当前环境中特别管用。现实中的开发任务通常没有强时间限制,但若不告诉代理任何约束信息,代理根本不会在时限内工作。
代理对其环境、约束以及评估标准了解得越多,就越能自主地驱动自身工作。
Harness 工程师的职责是:准备并交付上下文,使代理能够自主完成任务。
鼓励代理退后一步、重新审视计划
代理在确定计划后往往变得短视,陷入“死循环”——对同一种本就失效的方法做微小改动(某些链路里能循环十多次)。
我们使用一个 LoopDetectionMiddleware(循环检测中间件),它通过工具调用钩子追踪每个文件的编辑次数。当同一文件的编辑次数达到 N 次后,它会向代理注入上下文,比如“……考虑重新评估你的方案”。这有助于代理从死循环中恢复——当然,如果它坚持认为自己是对的,也可能继续走老路。
一个重要说明:这只是针对当下模型短板的一种工程启发式设计。随着模型能力提升,这类护栏大概率会变得没有必要——不过在今天,它确实能帮助代理正确、自主地执行。