
Jess Weng 2026 年 10 月 14 日 10 分钟
关键要点
- “上下文腐烂”(context rot)出现在长时间运行的智能体上——当它们积累的上下文超出模型承载能力时,准确率就会下降。
- Deep Agents 是 LangChain 的开源智能体框架,它使用五种技术将上下文移出活动窗口(但不删除),从而防止上下文腐烂。
- 在 Deep Agents 里,智能体的记忆以普通文件的形式存储在你掌控的存储介质中,因此你可以在保留它全部所学的同时切换模型或服务提供商。
如果你曾临时抱佛脚地通宵复习考试,你一定熟悉那种感觉:学得越多,前几章的内容反而越容易从脑海里溜走。
智能体也面临同样的问题。随着它们处理的任务越来越久,积累的信息(指令、工具结果、文件等等)也越来越多;最终这些上下文会远远超出模型上下文窗口的舒适承载量。模型携带的历史、噪声和工具输出越多,它的准确率和推理能力往往就越差。
在智能体工程领域,我们把这种现象叫做“上下文腐烂”(context rot)。本文将介绍管理智能体上下文窗口的若干技术,以及 Deep Agents 框架如何通过“中间件”(middleware)的概念把这些技术注入到智能体的运行流程中。
理解上下文工程技术
简化来看,智能体本质上就是一个模型,外面套了一层框架。
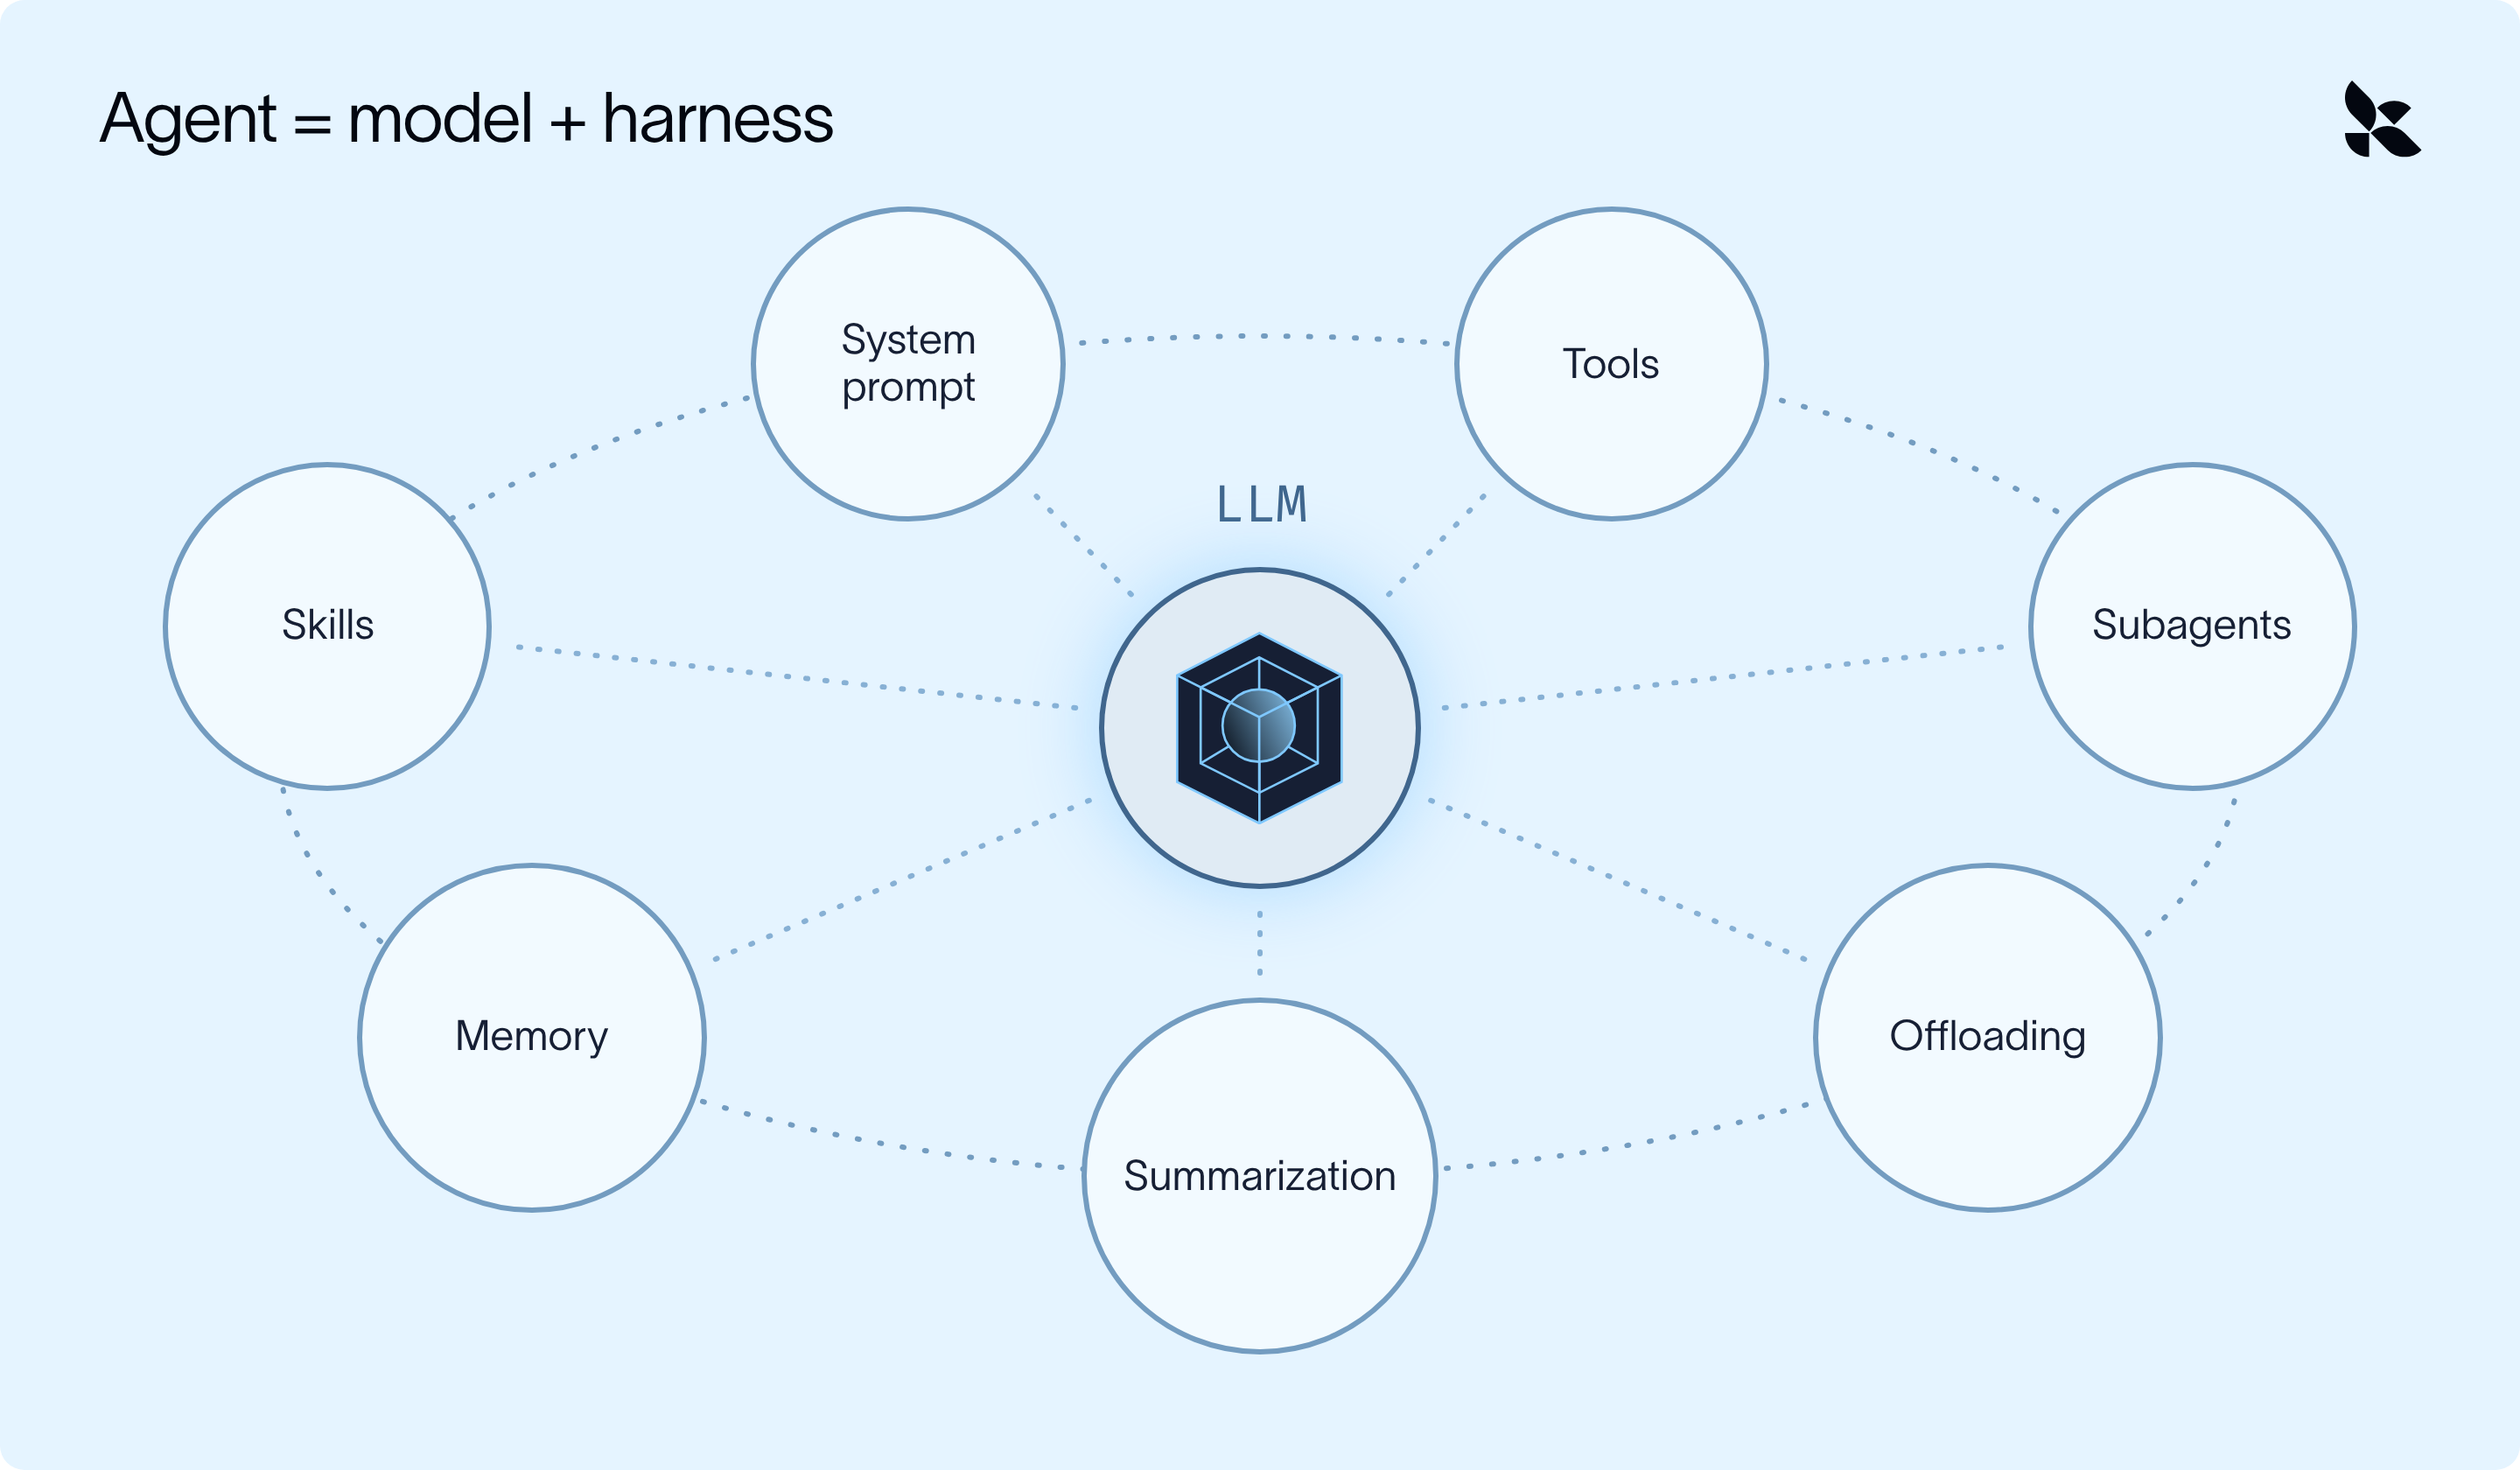
智能体可用来应对上下文腐烂的上下文工程技术,主要分两大类:
- 阻止不必要的信息进入上下文窗口
- 管理和过滤上下文窗口中已有的内容
框架会在恰当的时机按需地应用这些方法,以便在给定任务下让模型在正确的时刻拿到正确的上下文。
不过,把这样一个框架做好说起来容易做起来难,需要大量的工作(如果你是那种临时抱佛脚通宵复习的人,那工作量可能就更显巨大了)。
Deep Agents 是 LangChain 的开源框架。它在你选定的模型外层包裹一层技术,用于将上下文移出活动窗口(转存到文件、摘要,或单独的智能体中),使主智能体只携带它需要的内容(并在之后需要时仍可取回原始数据)。
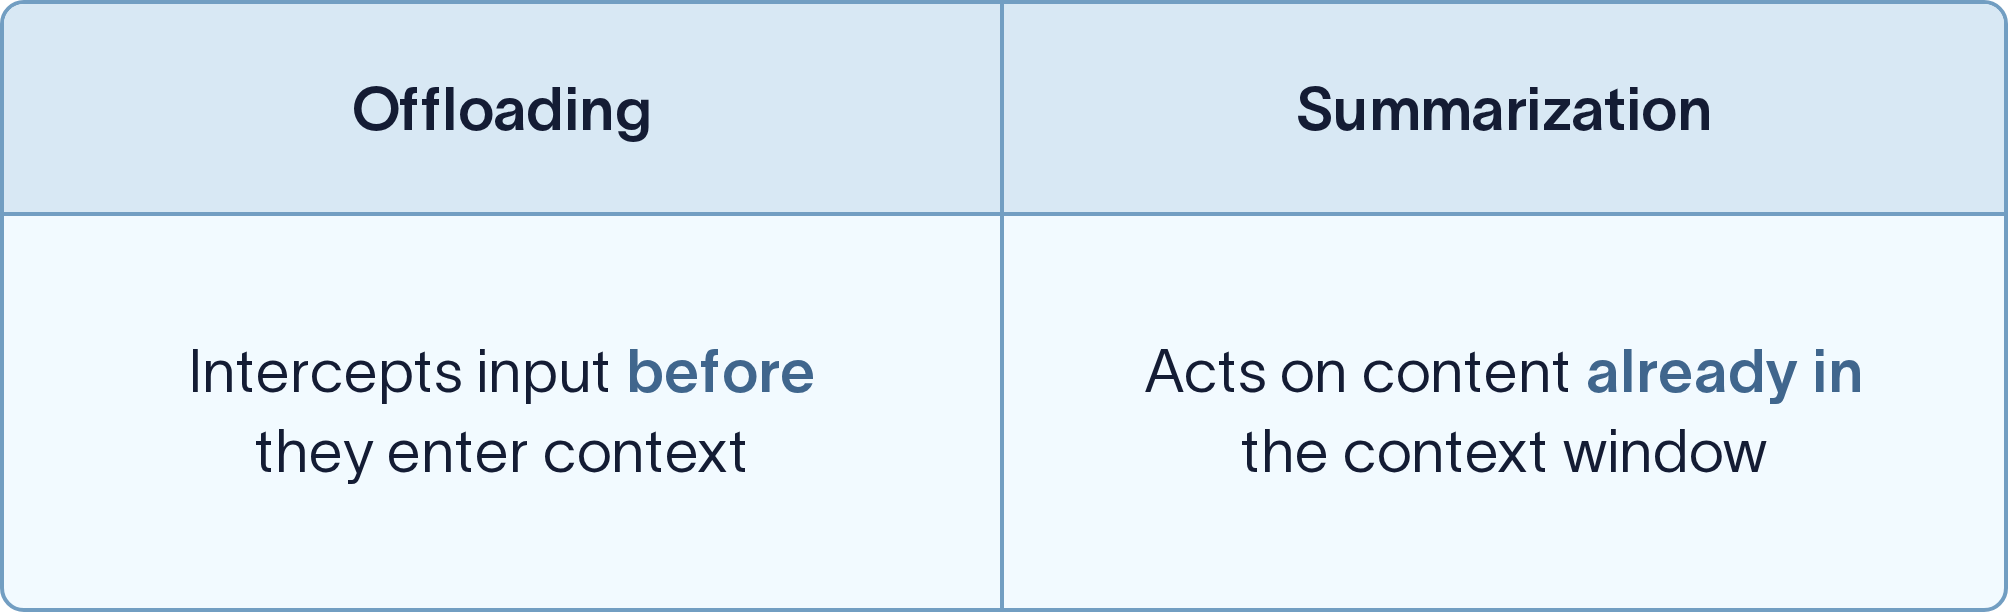
- 转储(Offloading): 将大型工具结果和用户消息保存到文件系统,模型看到的只是一个预览。
- 摘要(Summarization): 当对话接近上下文上限时,把较早的消息压缩成摘要。
- 技能(Skills): 任务相关的诀窍(know-how)只有在模型判定相关时才会被加载。
- 子智能体(Subagents): 噪声较大的工作放在一个独立的上下文窗口中运行,只有最终结果返回。
- 长期记忆(Long-term memory): 智能体所学的内容会保存到一个文件中,并带到下一次对话中。
把上下文工程应用到常见用例中
我们来看看上述技术如何应用到一个真实场景里:一个竞品分析智能体。每个周一,这个智能体会调研五家竞品,并按照团队的模板撰写一份报告。一次的运行大致是这样的:
- 拉取 A 公司的市场数据导出(数万行)
- 搜索新闻,阅读几篇文章,并做笔记
- 对 B 到 E 公司重复同样的过程
- 起草报告,根据你的反馈进行修改,并格式化输出
到第 4 步时,智能体已经在每次模型调用中累积了 5 份原始导出、几十条搜索结果以及两份过时的草稿。其中大部分对于最终报告的格式化是无关紧要的。
检索方法(RAG 或文件系统搜索)能帮助智能体只拉取它所需的内容,但这仍然只解决了一半问题。即便是很精准的智能体,也会累积起不必要的消息、工具结果和中间过程,所以运行框架本身还必须管理已经在上下文窗口之中和周围的内容。
如何实现这些技术:中间件
智能体运行在一个循环中:模型决定要做什么,调用一个工具,读取结果,然后重复,直到任务完成。中间件是插入到这个循环特定节点上的代码,例如在智能体启动之前、每次模型调用前后、或者每次工具调用前后。
- 在每个节点上,它可以读取上下文,并在下一步运行前对其进行修改。
- 本文所讲的每一种上下文工程技术,都是挂载在这些节点之一上的一段中间件。
- 这些功能大部分是内置的,因此你无需编写任何中间件即可使用这些技术(除非你想针对某些特定环节进行自定义)。
卸载(Offloading):把内容挡在上下文窗口之外
我们的智能体并不总是需要查看每一次工具调用或人类消息所返回的全部数据,尤其是当数据量很大的时候。
例如,每一次 pull_market_report 工具调用都会返回一份完整的数据导出(成千上万行);然而智能体只需要其中的几个数字,因此可以限制模型只看到这些相关的行。
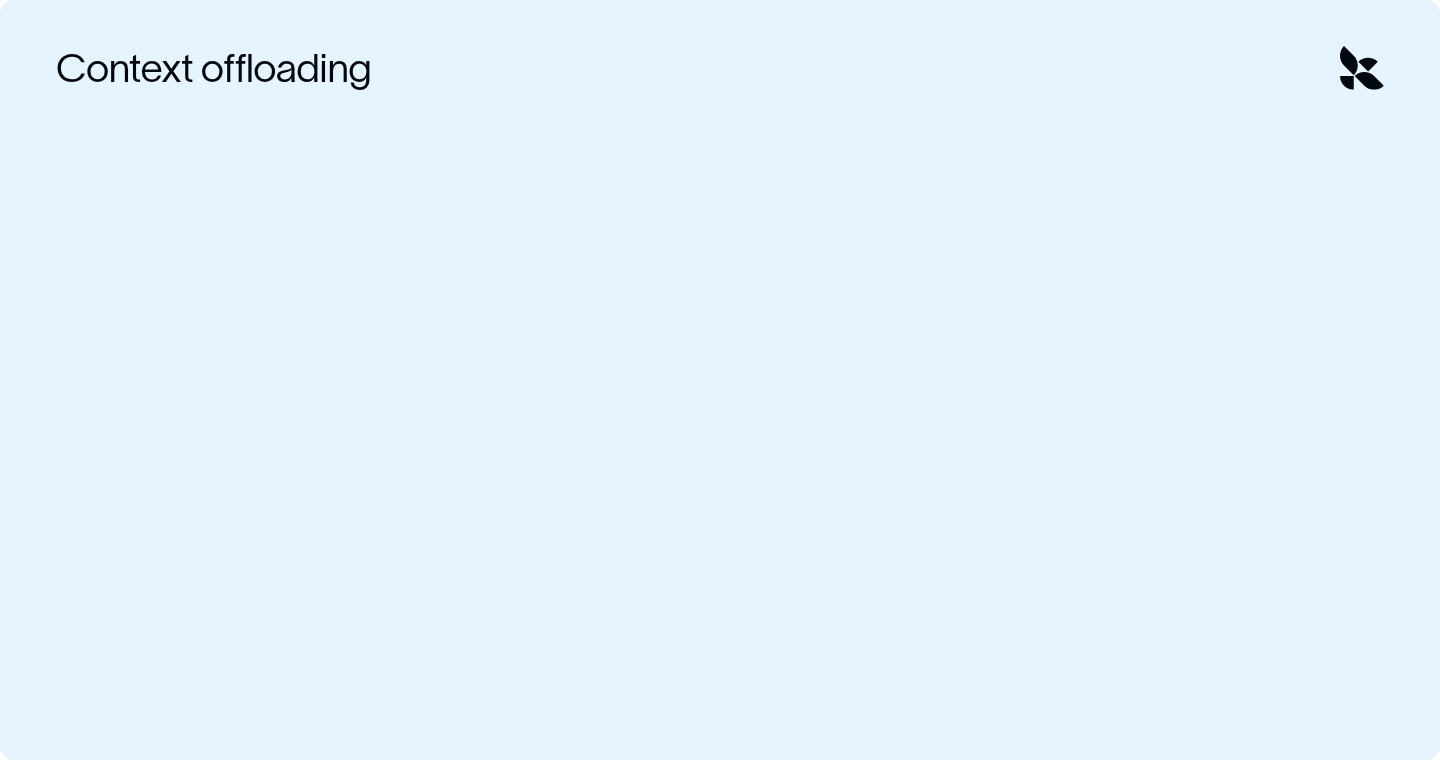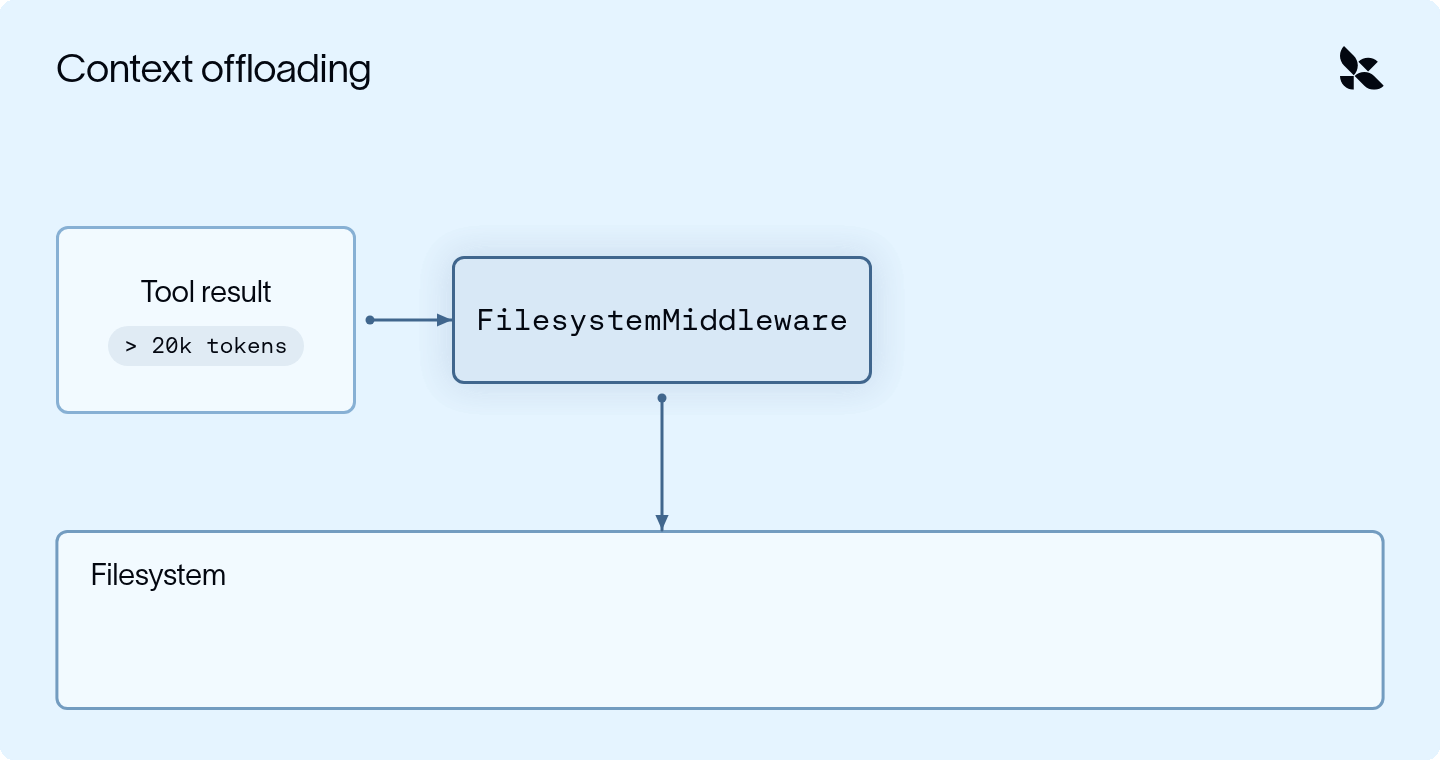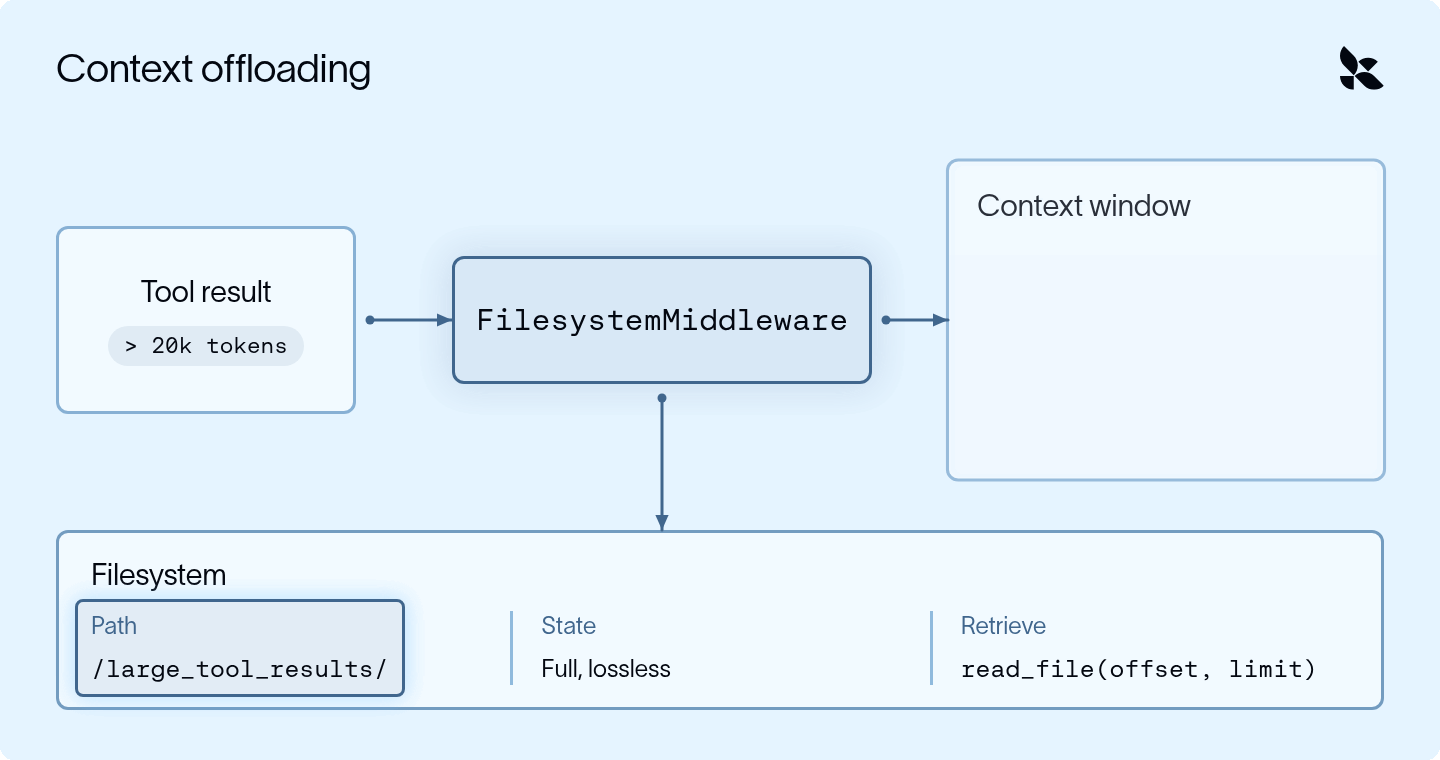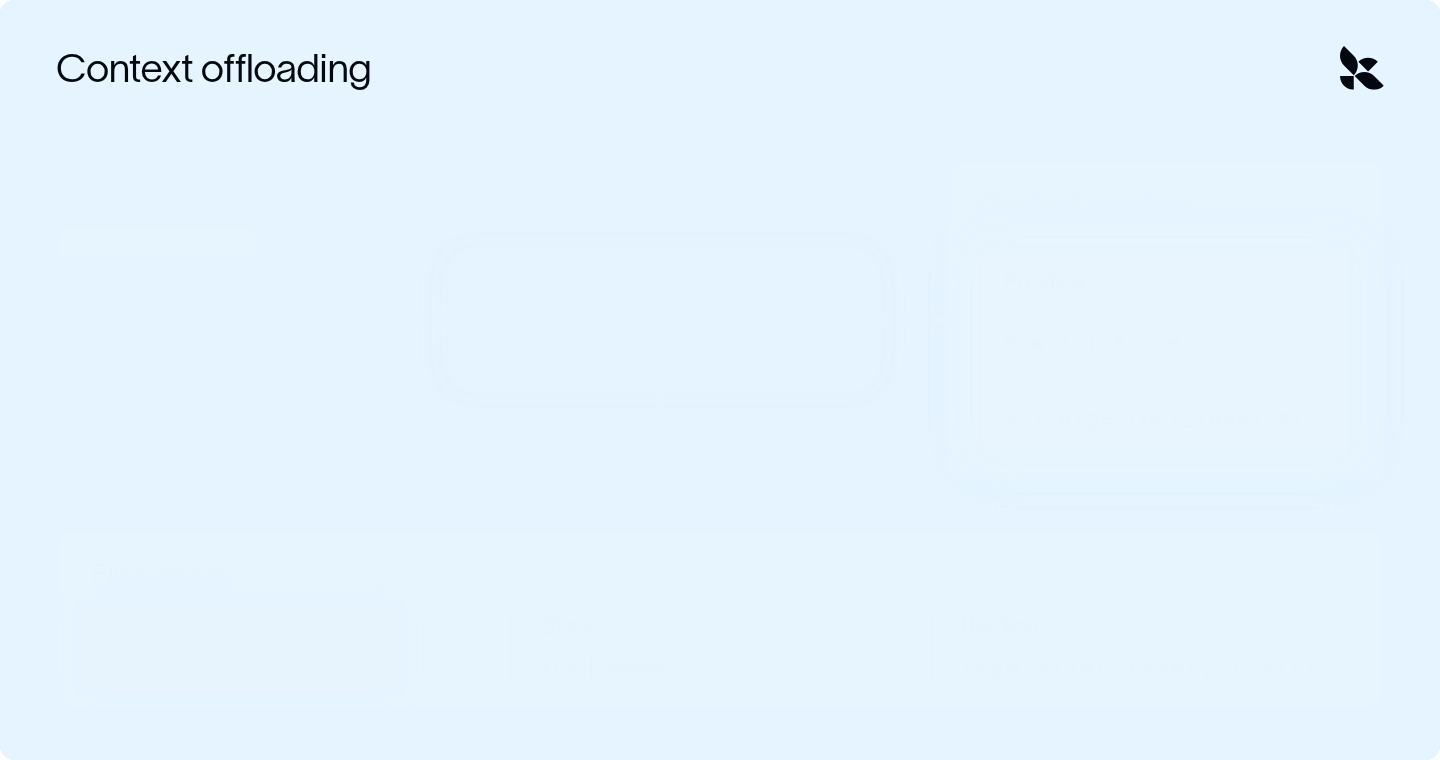
FilesystemMiddleware 会在每次工具被调用时执行:
- 当工具结果超过大约 20,000 个 token 时,完整的结果会在进入对话之前被写入 /large_tool_results/{tool_call_id}。
- 模型只能看到一段简短的预览(开头和结尾的几行)以及文件路径。
- 当智能体之后需要 B 公司的季度营收时,它会通过 read_file 去分页读取这个文件。
对于过大的用户/人工消息(比如粘贴进去的通话记录),会在更高的阈值(50,000 个 token)下进行同样的处理,并保存到 /conversation_history/。
摘要:压缩已有内容
即便我们尽力把冗长的工具调用卸载到外部,上下文在长时间运行中仍会逐渐堆积(例如对五家公司的检索、笔记和草稿)。摘要(Summarization)可以把整个上下文窗口压缩为到目前为止发生情况的摘要,让智能体(agent)能够继续完成研究任务。
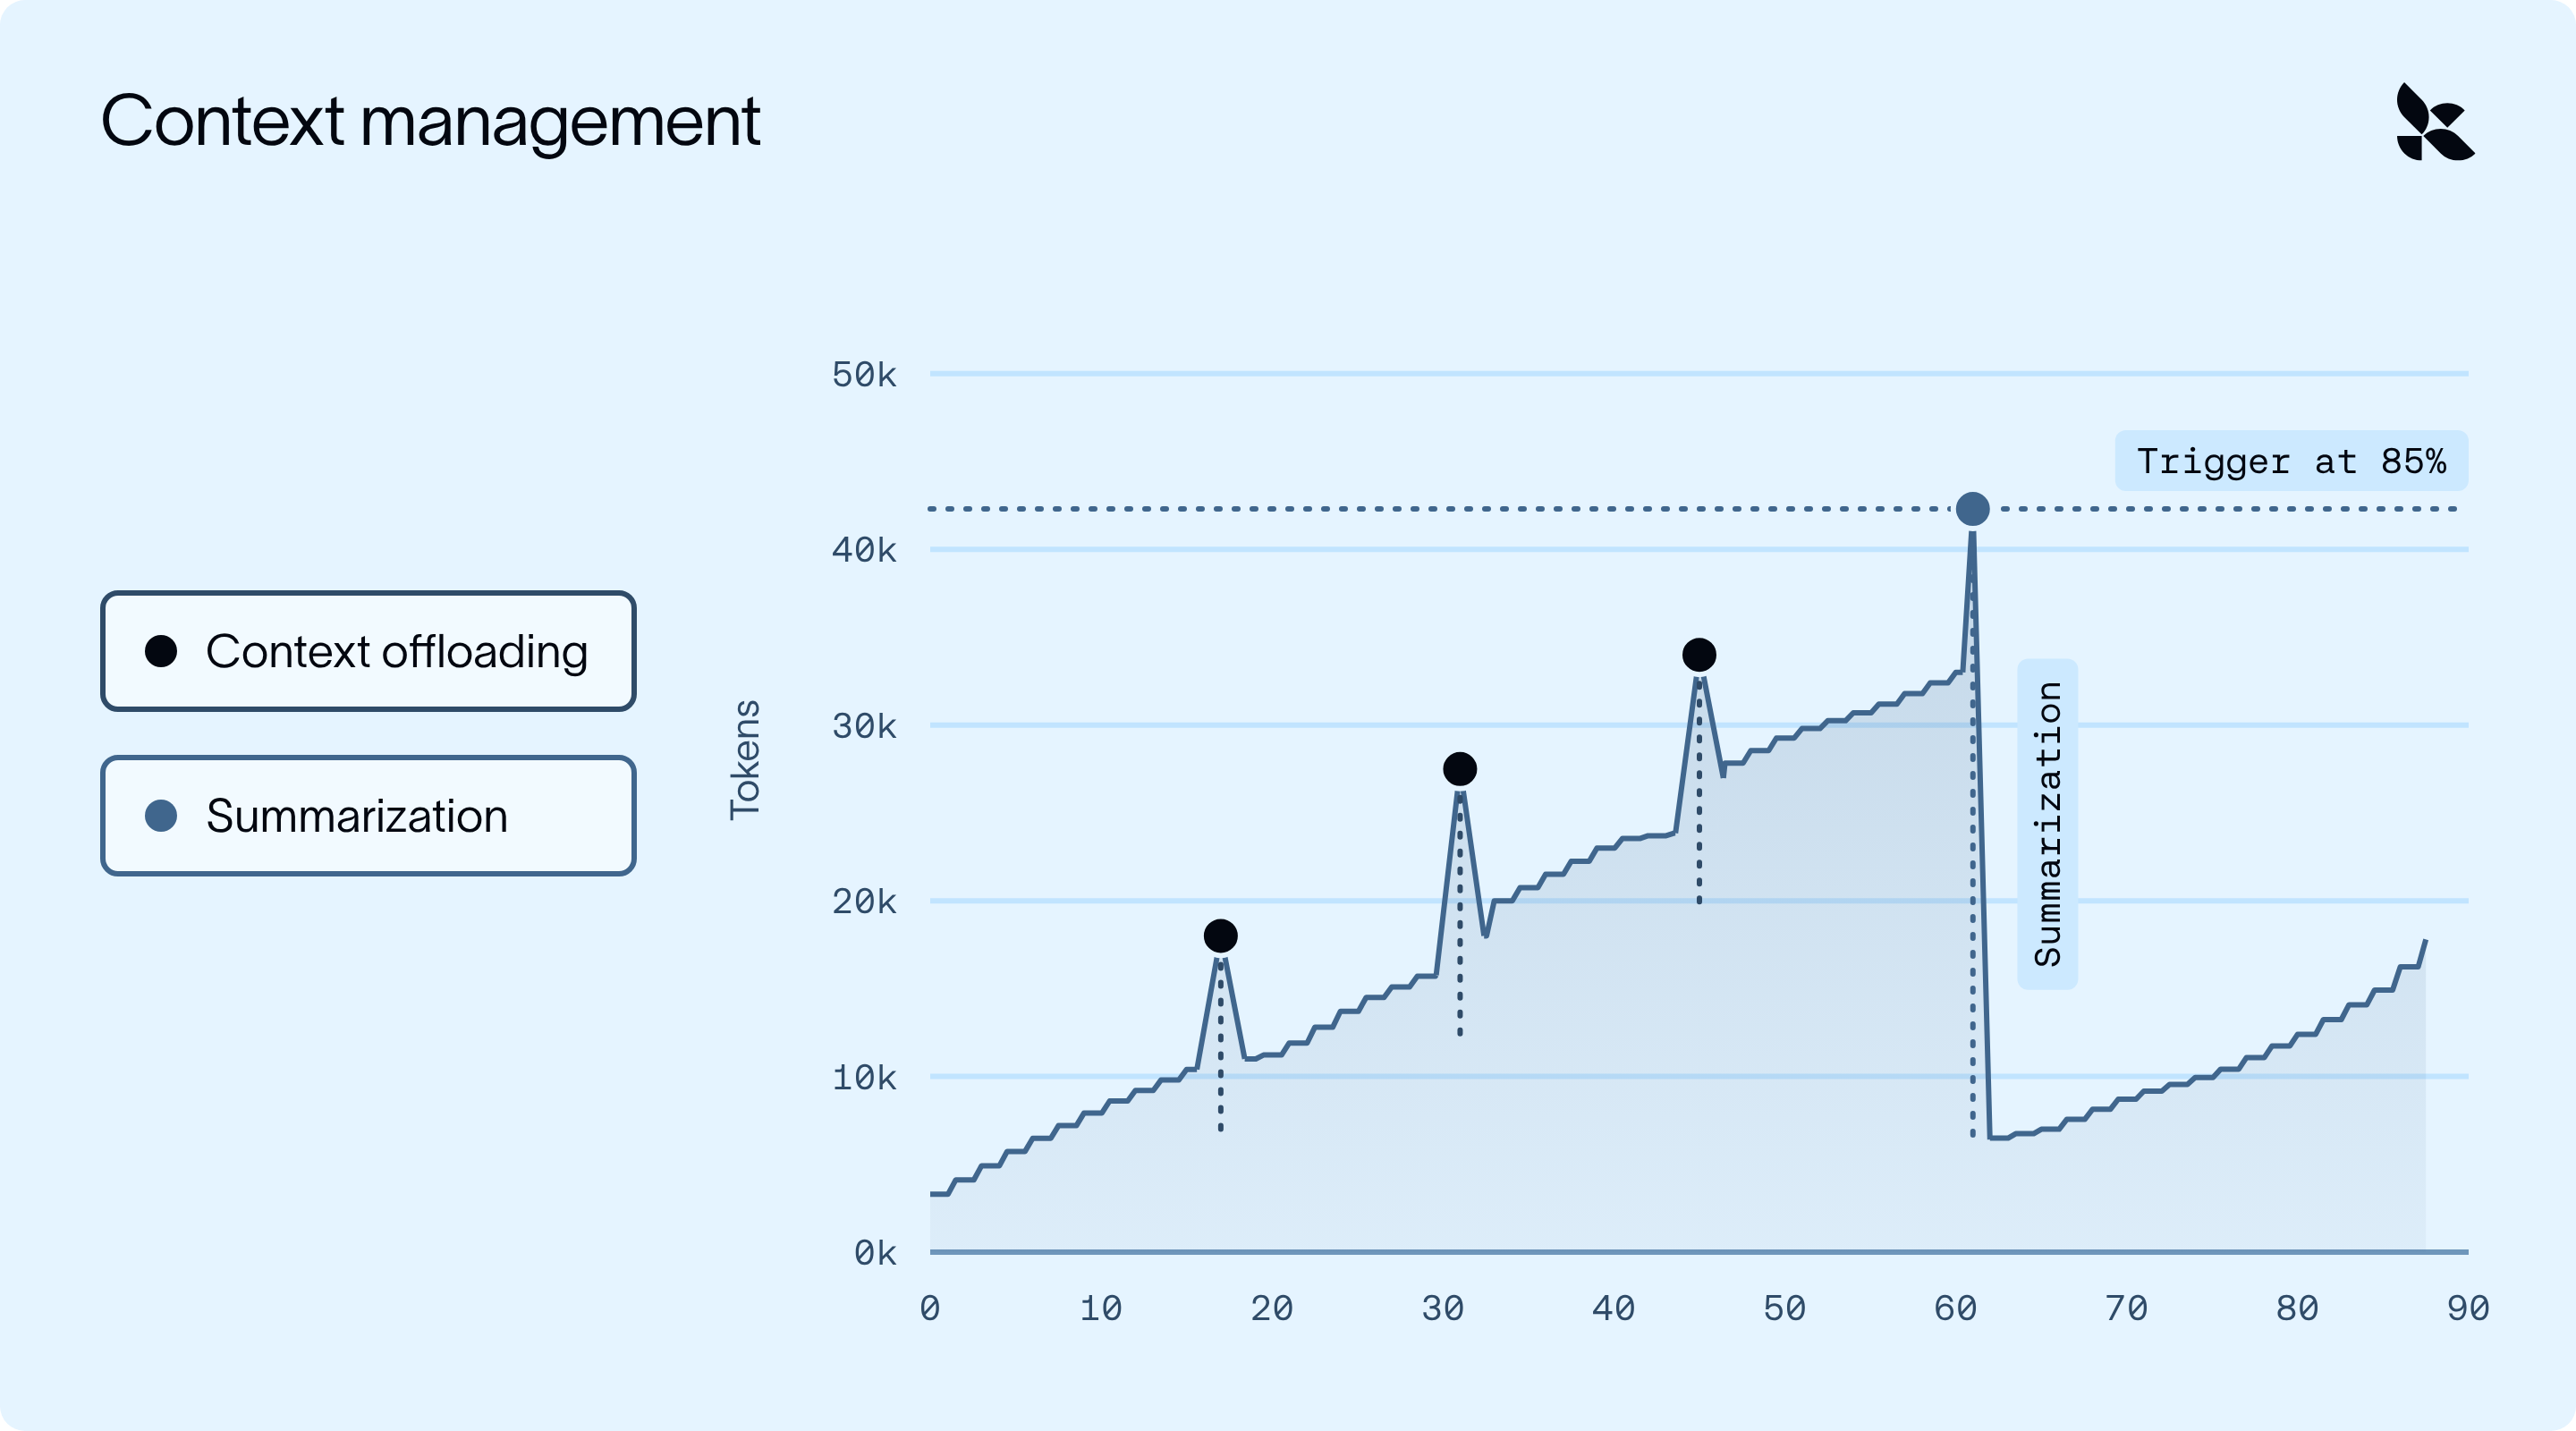
- 那些尖峰是到达的较大工具结果或人工消息;卸载会把它们各自替换为一段简短预览后才交给模型,因此上下文只增长一点点。
- 摘要处理的是缓慢的攀升:一旦使用率达到 85%,较早的消息会被压缩成一段摘要,上下文随之回落。
SummarizationMiddleware 在每次模型调用前检查 token 用量:
- 当用量超过阈值(默认为模型上下文窗口的 85%)时,会通过一次独立的 LLM 调用将较早的消息压缩成一段摘要。
- 较早的消息会从上下文窗口中移除,最近的消息则原样保留。
- 模型现在会先看到摘要,再看到最近的消息(因此最近的内容不会被改写)。
两个重要细节:
- 可恢复。 被摘要的消息会写入
/conversation_history/{session_id}.md。如果在撰写报告时需要来自公司 A 研究的某个细节,智能体可以重新读取它。 - 会循环。 随着运行继续,用量会再次攀升,下一次摘要会把上一次的摘要一并纳入。
你还可以在话题切换时进行摘要,而不必非要等到某个 token 阈值再触发。自定义摘要提示词(prompt)通常很有帮助。
我们关于 Deep Agents 上下文管理 的文章会更详细地介绍这两部分内容。
Skills(技能):按需加载信息
假设你的销售团队针对季度业务回顾(QBR)有一套固定格式。智能体每个季度只需要这些指令一次,如果把它们一直放在系统提示(system prompt)里,就意味着每次调用都要为之付费(消耗 token 和响应时间)。更好的做法是把这类信息打包为一项技能。
技能(skill)是一个包含指令的文件夹(可附带脚本和参考资料),为智能体完成专门任务提供所需信息。
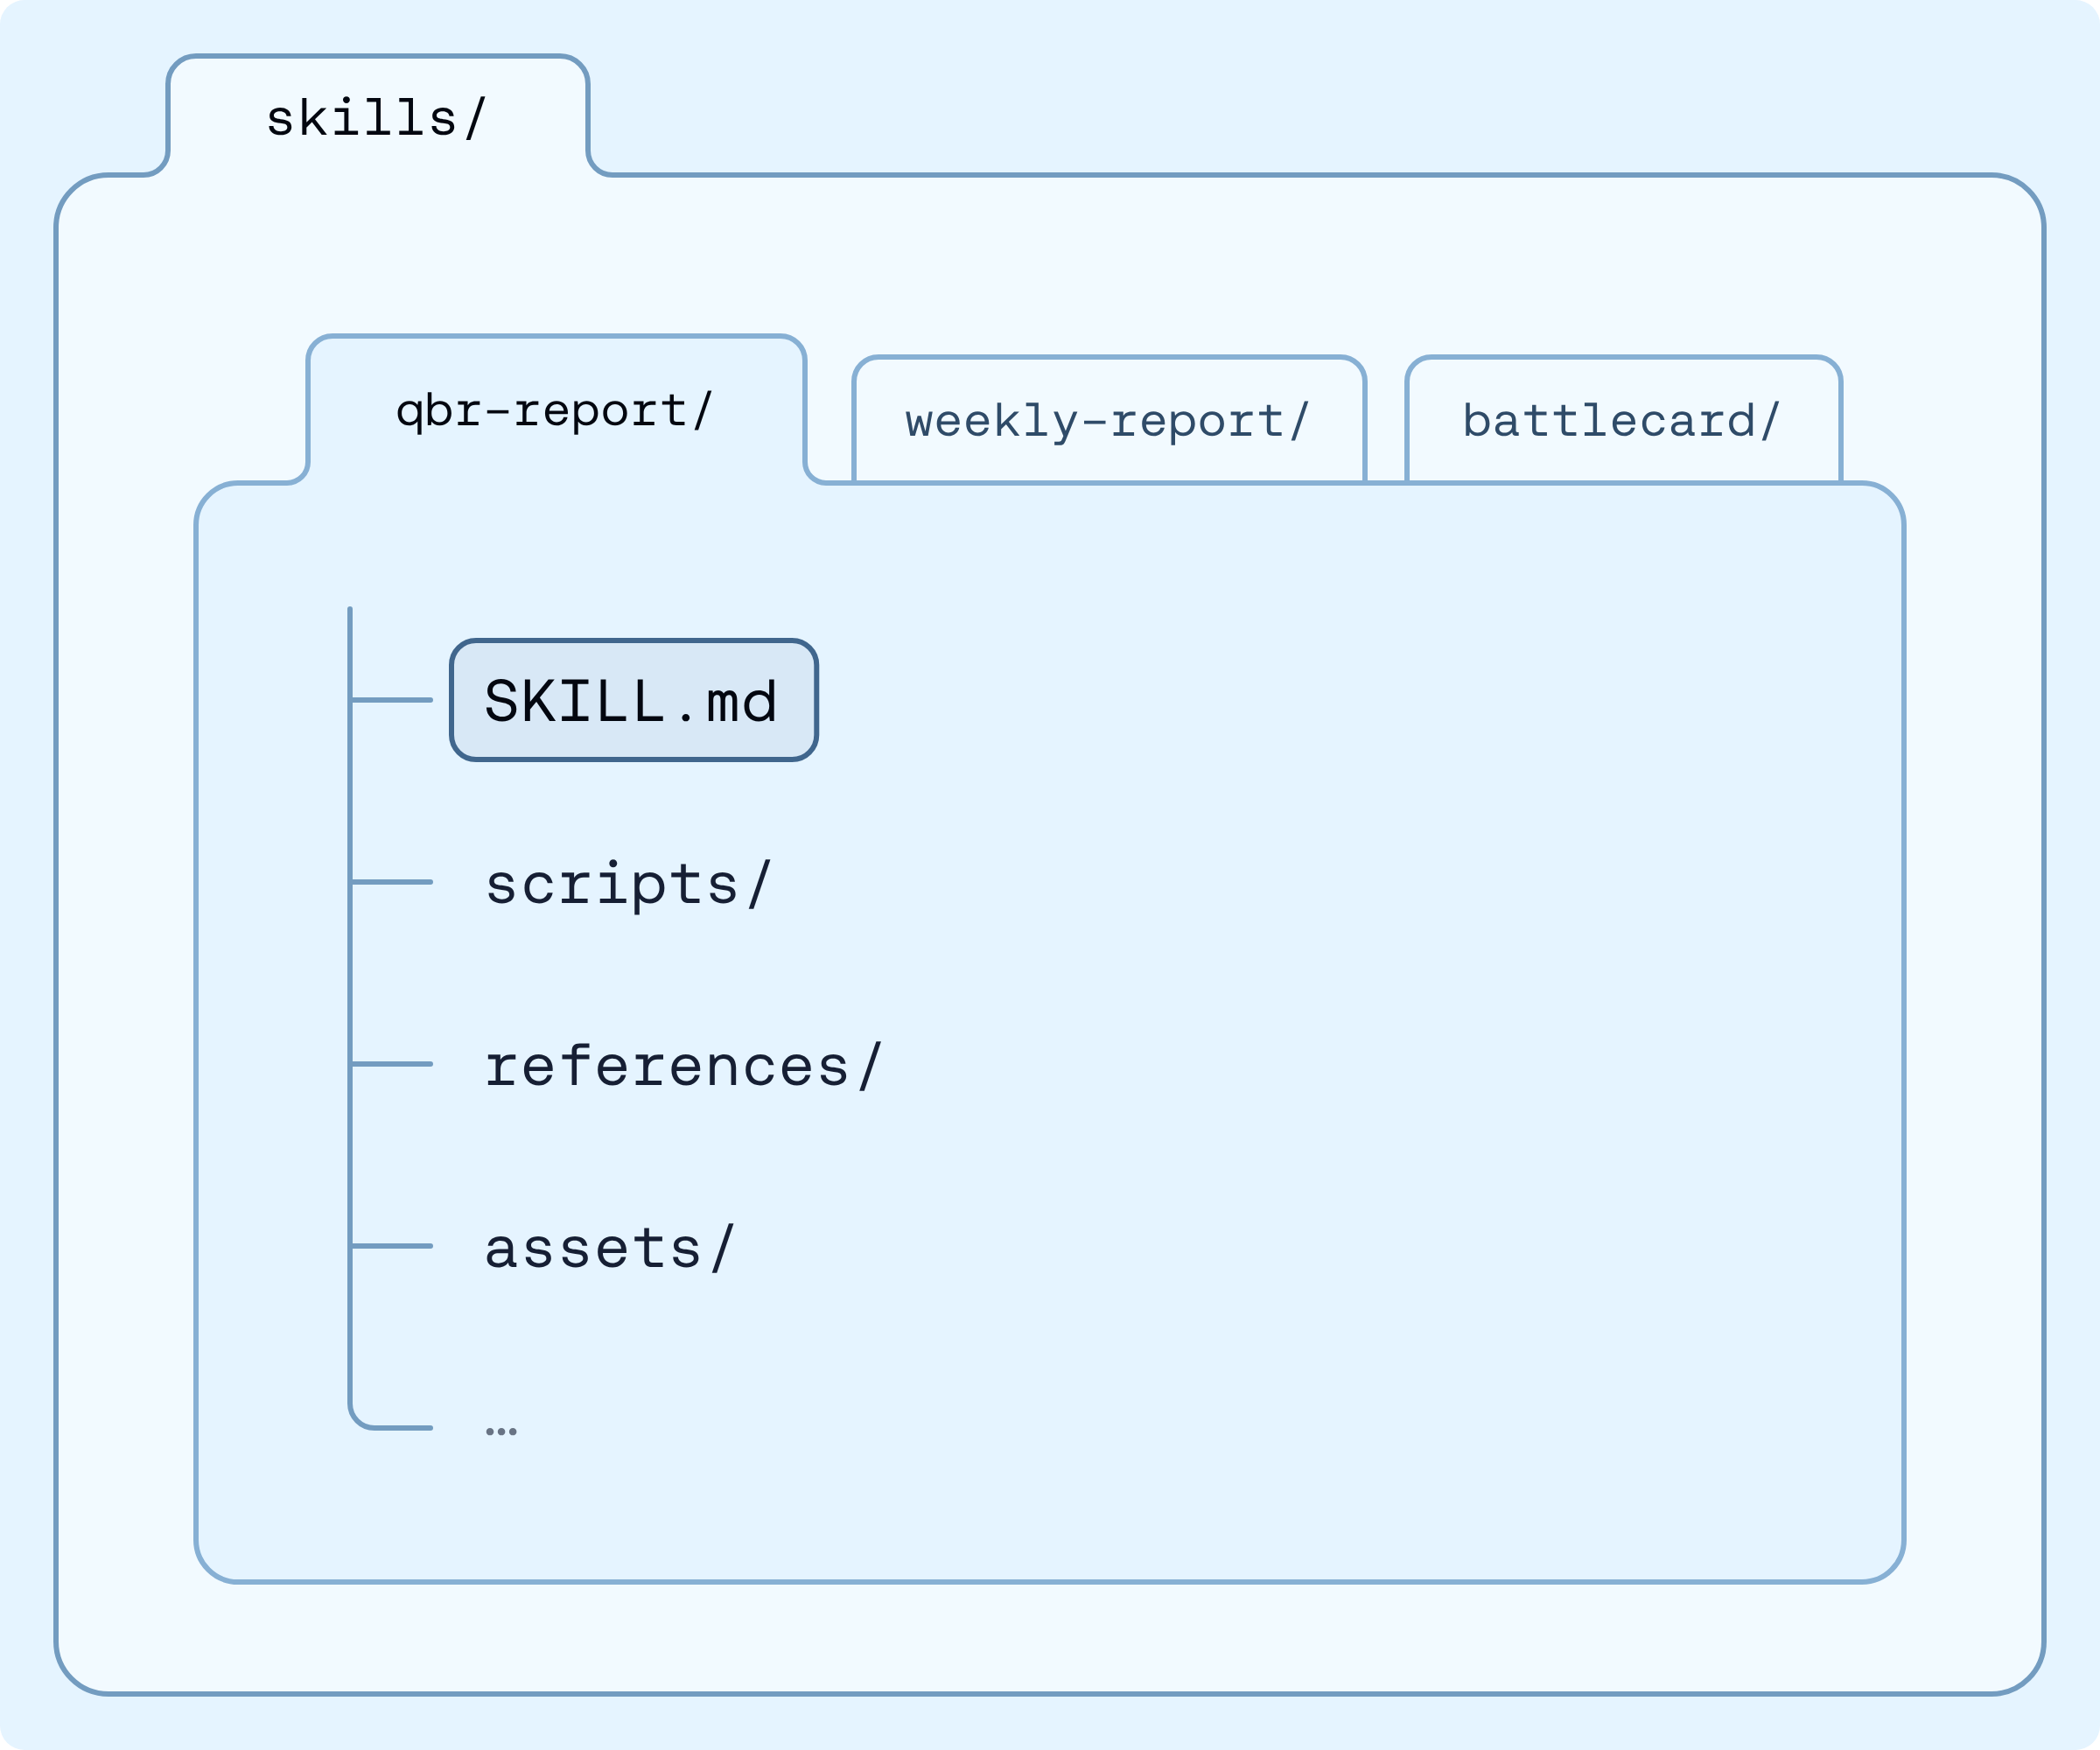
智能体一开始只会看到一段简短的描述,只有当涉及 QBR 时才会加载 qbr-report 的完整指令(其他任务完全不会携带它们)。
技能按层级加载上下文,因此窗口保持得很小,直到真正有相关内容出现。这被称为渐进式披露(progressive disclosure):模型先看到一份“菜单”,在需要时才调入完整配方;这样十项技能所占用的上下文,大约和十条一句话提示相当。
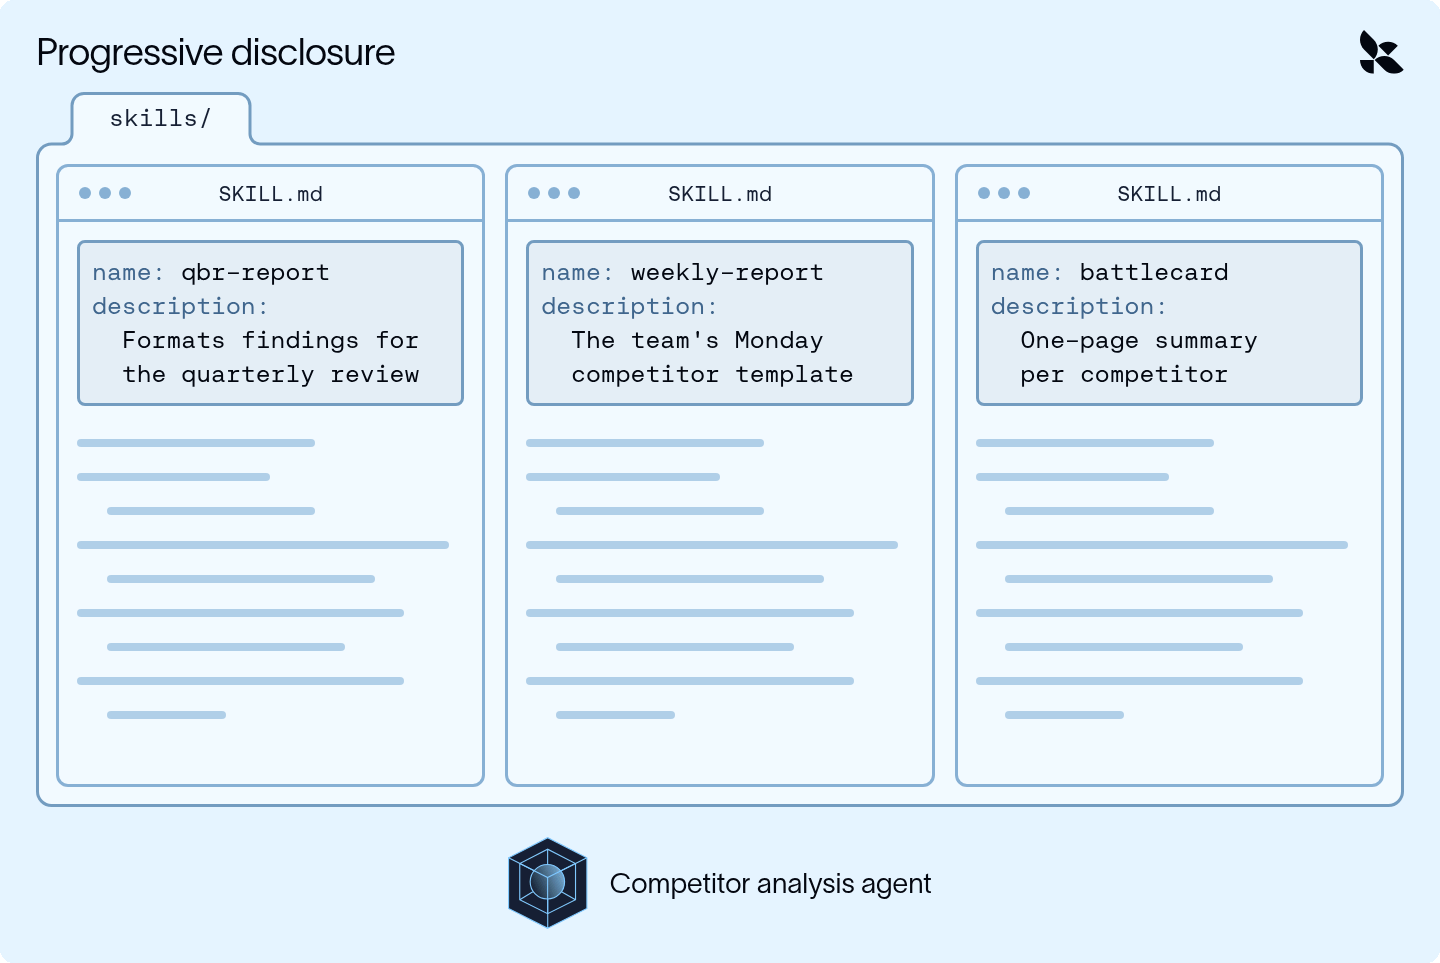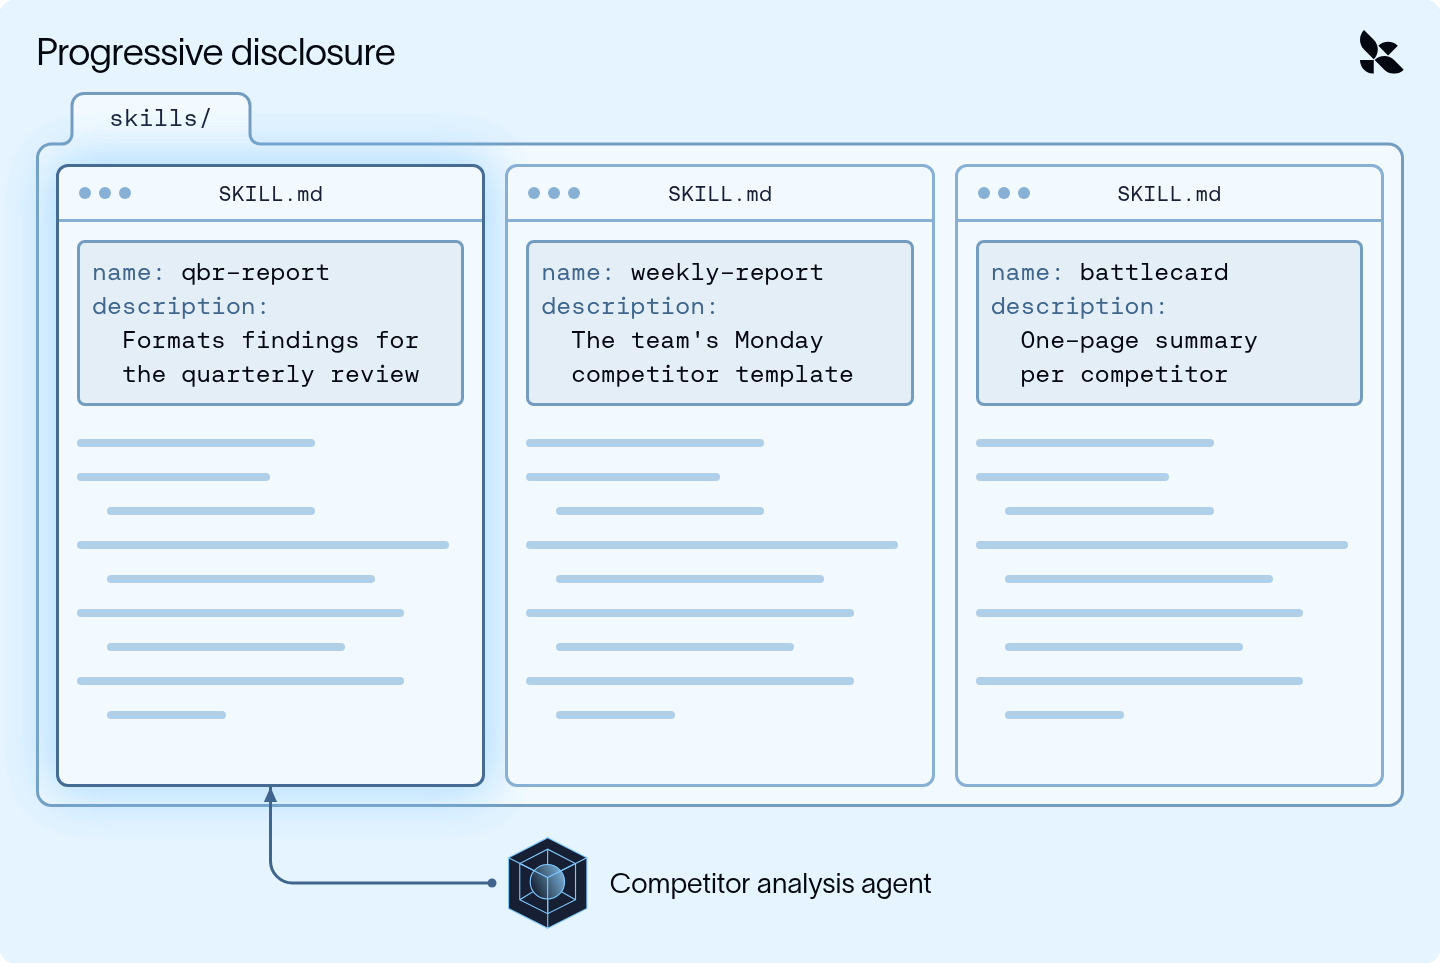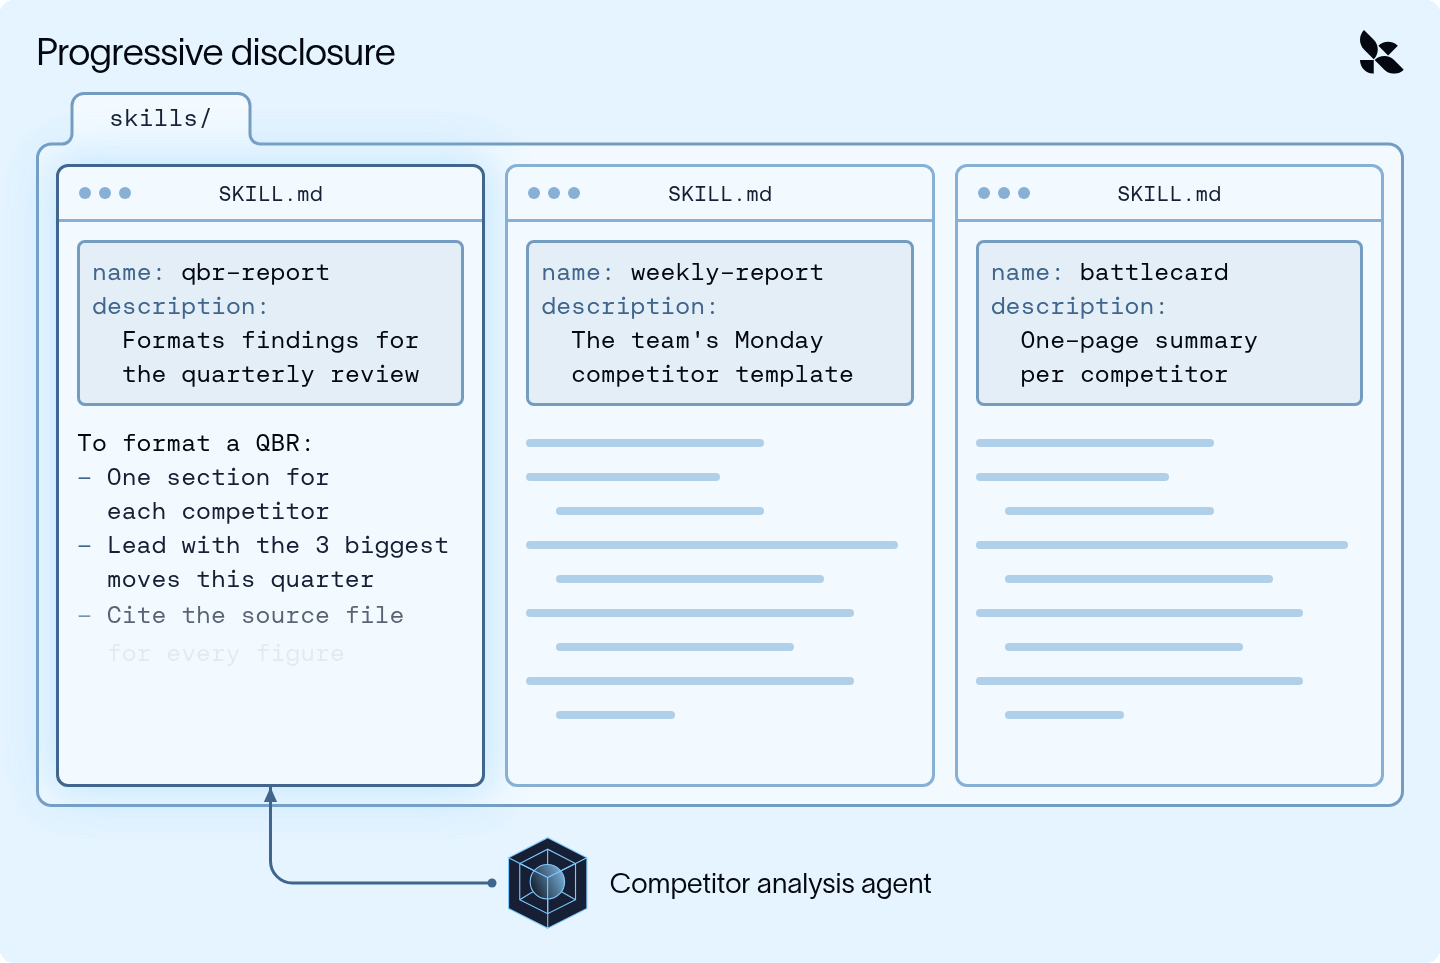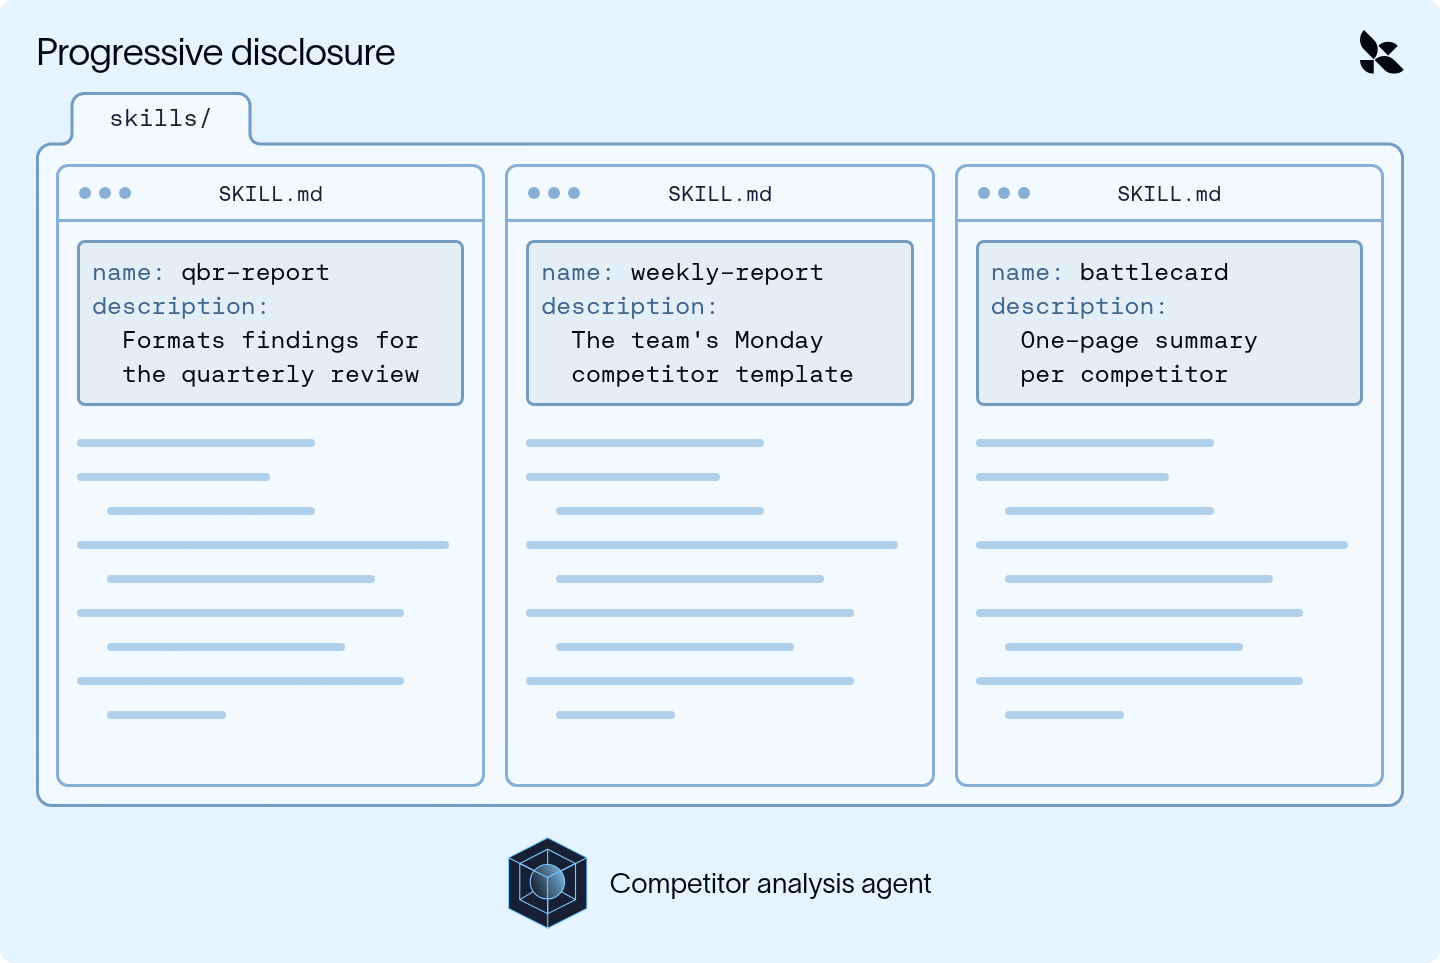
你把技能目录指给智能体,SkillsMiddleware 会通过两个钩子(hook)来工作:
- 在智能体启动前,它扫描技能目录,只读取每个
SKILL.md的头部。 - 在每次模型调用时,它将这些技能名称和描述添加到系统提示中。
完整指令只有在模型判定某项技能相关时(并通过 read_file 工具读取)才会进入上下文。于是我们的智能体在研究阶段不会加载模板,只在需要排版 QBR 时才加载它。