AI 编程智能体时代,验证(Verification)为何成为核心瓶颈?
在 AI 编程智能体(AI Coding Agent)快速发展的当下,代码生成能力已不再是唯一的竞争焦点。越来越多从业者意识到,真正决定智能体能否落地的关键,是「验证」这一环节。
为什么验证成为瓶颈
随着大模型在代码生成上的表现不断提升,生成代码本身的门槛在下降。但生成的代码是否正确、是否满足需求、是否引入回归问题,仍然需要可靠的验证手段。验证环节的缺失或不完善,会直接导致智能体的输出无法被信任,进而限制其在真实工程场景中的应用。
核心要点
- 代码生成能力快速进步,验证能力却相对滞后,两者之间形成明显落差。
- 智能体需要能够自主检查、测试和确认自身产出,才能形成闭环。
- 验证不仅是跑测试,还涉及需求理解、边界条件与回归风险的判断。
结语
在 AI 编程智能体的竞争格局中,验证能力正在从辅助环节上升为核心瓶颈。谁能更好地解决验证问题,谁就更有机会让智能体真正融入生产流程。
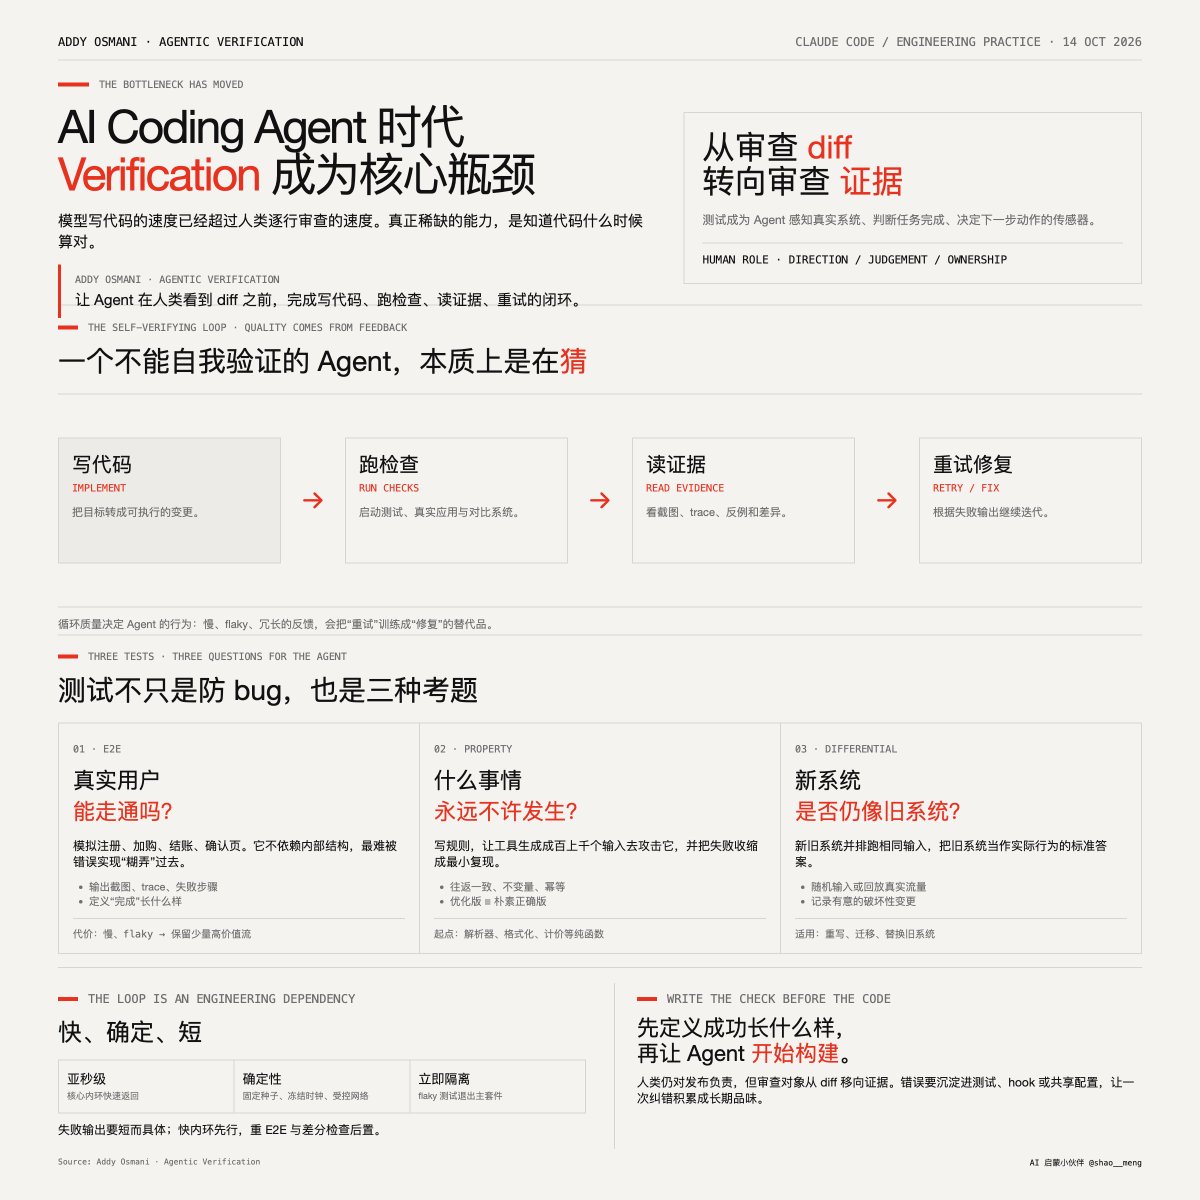
来自 Claude Code 团队 @addyosmani 最新分享「Agentic Verification」,他认为瓶颈已经从 “写出代码” 转移到 “知道代码是对的” :
Addy 的核心观点:验证改变了 Agent 的行为模式
一个不能自我验证的 Agent,本质上是在“猜”。猜的结果就是把慢速的人类循环强加给流程:人类读 diff、跑测试、点应用、报 bug。而一个能自我验证的 Agent,会在人类看到任何东西之前就完成“写代码 → 跑检查 → 读输出 → 重试”的闭环。
由此,测试的定义被改写了。传统上测试是防 bug 和支持重构的工具;现在测试是“Agent 感知世界、判断自己何时完成的传感器”。“实现这个功能”是个模糊目标,“让这条 E2E 测试通过”是一个可以追逐的目标。人类的工作从“逐行 review”变成“构建 Agent 能自己跑的验证循环”;人仍然对发布负责,但审查的对象从 diff 变成了证据。
三种测试,其实是三种给 Agent 的“考题”
-
E2E 测试:如果只能选一种,选它。 E2E 模拟真实用户流程 (注册、加购物车、结账、看到确认页),不关心内部结构,因此很难被“糊弄”。相比之下,基于 mock 的单元测试可能出现 Agent 和测试共享同一个误解的情况,代码错、测试也按同样的错误理解写,双双通过。E2E 的额外价值在于:失败时给出的是截图、trace、具体失败的步骤,而不是一句 "Timeout after 30s"。代价是慢和 flaky,所以要维护一小套高价值的集合。配套技巧(来自 Lauren/@poteto):给 Agent “手和眼”,一个能启动、驱动、观察真实系统的 skill/CLI (CDP、模拟器、API harness),再加一份 feature map:以用户视角清点功能、入口、选择器、预期结果和坑。
-
属性测试 (property-based),规定“什么永远不许发生”。 由工具 (fast-check / Hypothesis / proptest) 自动生成成百上千个输入去攻击你的规则,失败后自动收缩成最小复现案例。典型属性:编解码往返一致、不变量(排序不丢元素、余额永不为负)、幂等性、等价性(优化版和朴素正确版行为一致)。这对 Agent 尤其关键:Agent 倾向于自己编造能通过的示例;属性测试强制它面对任意生成的输入。实践建议:从纯函数(解析器、格式化、计价)入手;先用自然语言写属性再翻译成代码;让 Agent 写“属性”而非“示例”。更高阶的做法(引自 Claude Code 的 Boris Cherny):对最刁钻的状态机和并发逻辑用形式化模型(Lean、TLA+),靠反例暴露竞态条件。
-
差分测试 (differential),把旧系统当“标准答案”。 新旧系统并排跑相同输入(随机生成或回放真实流量,而非手工挑的用例),差异要么是 bug、要么是有意的破坏性变更。这是 Agent 辅助重写的理想模式:改代码 → diff → 审查不一致 → 修,循环推进。Addy 引用了一个匿名团队的观察:从“修好一处又弄坏另一处”变成有条不紊的推进。三条纪律:归无语义意义的差异(如顺序);把有意的变更记入“已批准清单”,防止“不一样”被默认容忍;迁移完成后彻底删掉旧系统,两套并存等于双倍工作和双倍故障面。
回路质量:慢和 flaky 是在“训练” Agent 学坏
慢或不稳定的测试不只是浪费时间,它是一次训练。人类能容忍偶发的 flaky CI,但 Agent 会从回路的激励中学习:如果重跑有时能过,“重试”就会取代“修复”成为首选策略。测试慢则 Agent 跑得少、改动打包提交、无法定位是哪次改动引入的失败。最阴险的是,这两种失败模式都让 Agent 悄悄变差,而没有任何可见的失败信号。因此:"主套件里一条 flaky 的测试比没有测试更糟,因为它摧毁了对其他所有结果的信任。"
合格回路的标准:核心循环亚秒级完成;结果完全确定(随机性固定种子、冻结时钟、受控网络、隔离状态);flaky 测试立即隔离移除;失败输出短而具体(冗长的通过日志浪费 Agent 的注意力);快内环先行,重 E2E/diff 后置。一句话:把测试基础设施当作 Agent 的依赖来投资,改进它是复利。
人的角色:先写检查,再写代码
结论落在方法论上:在让 Agent 构建之前,先明确“成功长什么样”(一条 E2E 流程、一个属性、或一次与旧系统的对比)并且要快、要确定。你定义成功标准的判断力,“将比你自己读 diff 的能力扩展得好得多”。配套习惯:让 Agent 编码前先复述目标;用新上下文或独立的 reviewer Agent 做验证;对 Agent 生成的测试本身保持怀疑,它真的能区分“正确实现”和“貌似正确的实现”吗?出错的地方沉淀为共享配置、hook 或测试,让错误累积成“品味”而非重复。
addyo.substack.com/p/agentic-veri…