来自中国的一枚开源“炸弹”
2026 年 10 月 21 日 · 6231 次分享
由 SerpAPI 赞助呈现:今天的发布内容覆盖面很广,而你可以把这一切都抓取成供你的智能体使用的 Markdown!token 成本仅为 JSON 的 50%。
我们在 4 月最后一次讨论了推理拐点,而历史上这一领域的大多数进展都来自闭源的十角兽公司,从 Fireworks 到 Baseten,再到 Modal。
那么,现在轮到开源的回应了。今天是 PyTorch Conf 的第一天,DeepSeek 精准地把一枚洲际弹道导弹投进了讨论之中:它开源了 DeepInfer,这是其生产级技术栈,支持长达 72 小时的提示缓存,而 OpenAI 刚刚宣布的只有 12 小时:
[
DeepSeek@deepseek_ai🚀 隆重推出 DeepInfer,这是我们自研的推理框架,现已完全开源!它以高吞吐、低延迟支撑 DeepSeek-V4.1-Flash 的大规模运行。我们分享生产级技术栈,以帮助社区降低算力成本、减少能源消耗,并让 AI 更加……2026 年 10 月 20 日上午 9:30 · 346 万次查看
1.21K 条回复 · 3.59K 次转发 · 3.11 万次点赞](https://x.com/deepseek_ai/status/2112476496283775135)
这是他们对 vLLM 的定制版本,并致谢 SGLang 和 TRRTLLM,但其中新增了大量内容……唯独没有包含他们的看家本领——他们极致优化的 KV 缓存(紧凑且生命周期超过 8 小时)、PD 分离(预填充/解码分离)以及负载均衡(他们的 3FS 此前已经开源)。我们已翻译了他们的博客文章,并发布在此处,同时附上完整的研究指南、讲解材料、代码地图和子系统指南:
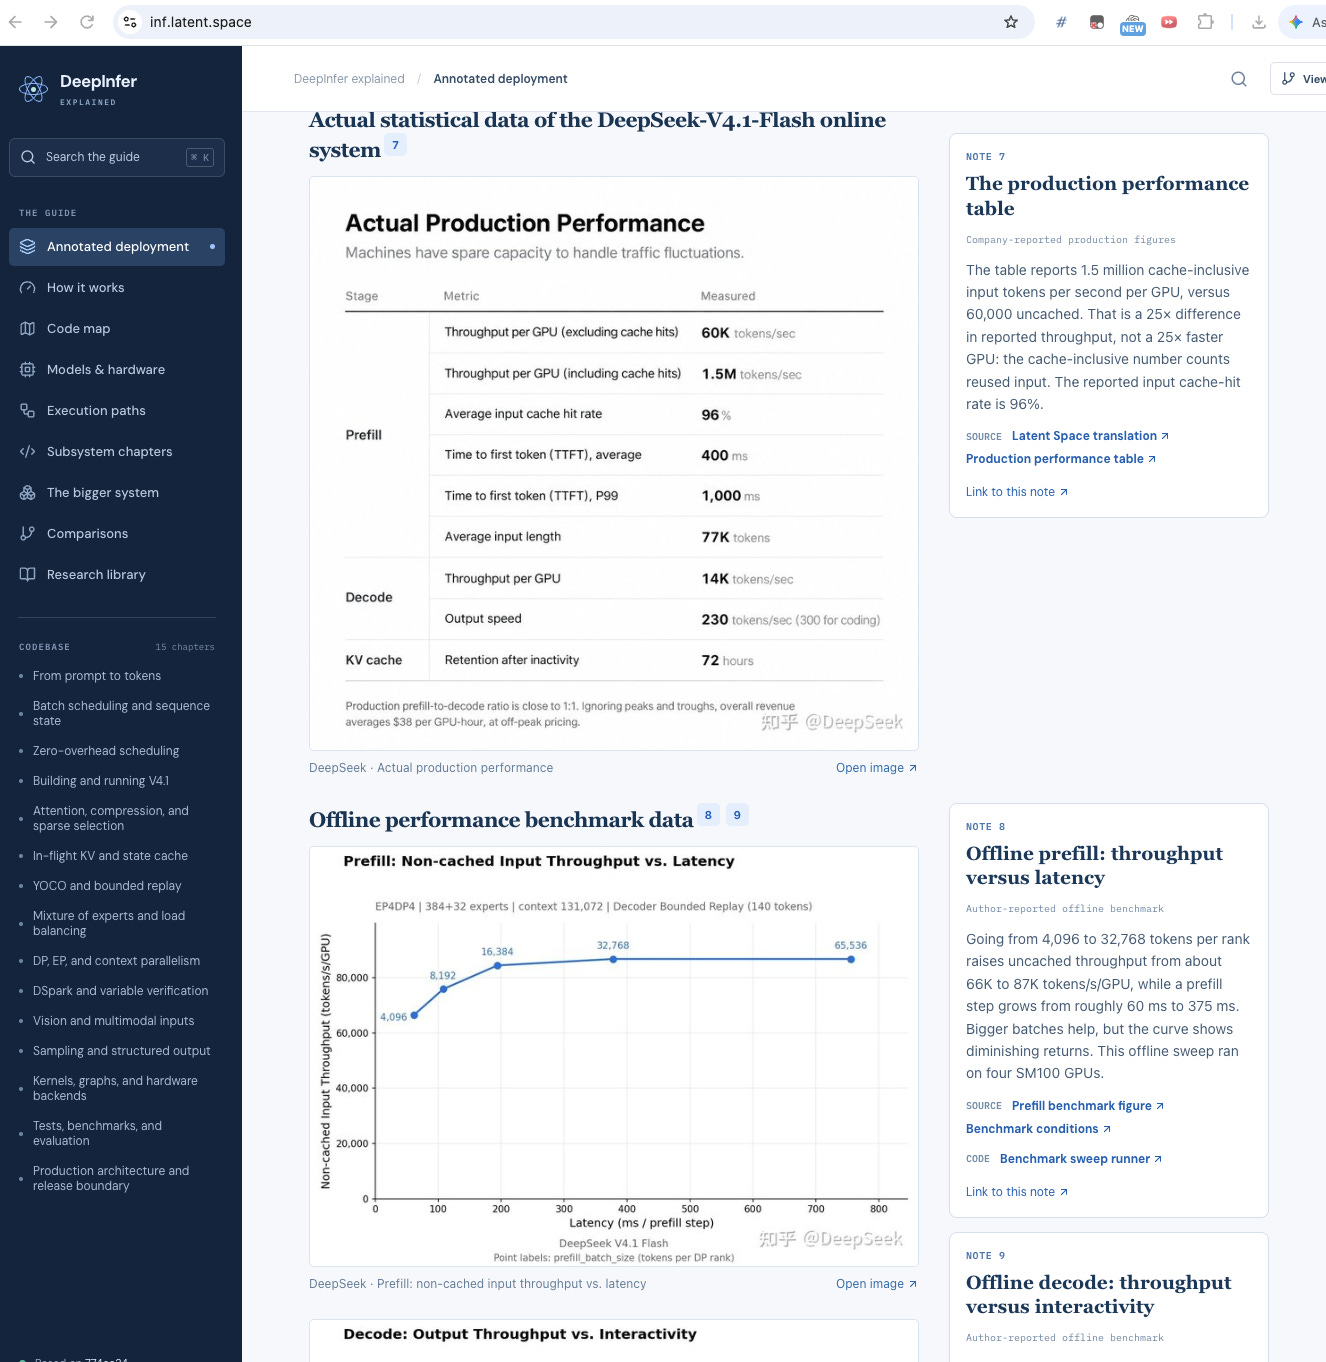
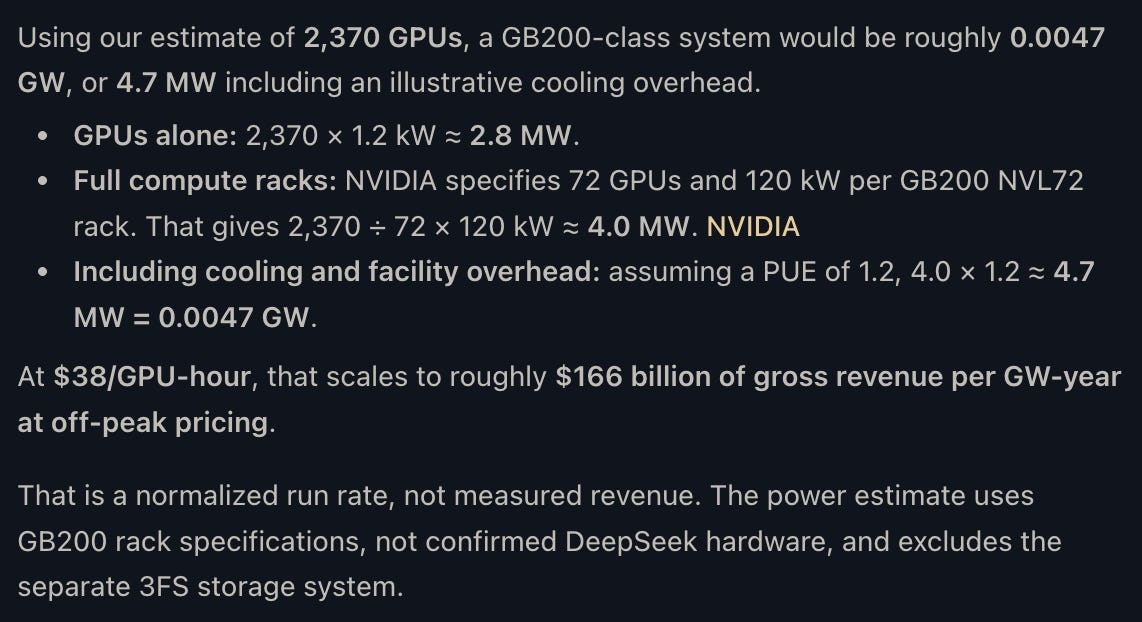
正如我们在他们额外的披露中所指出的,他们声称每天服务 155 万亿 token,按非高峰价格计算,这相当于每块 SM100/A950 卡每小时 38 美元(目前输入/输出分别为每百万 token 0.15/0.60 美元:155000000 个 token × 0.14 美元的综合成本 ÷ 24 小时约为每小时 100 万美元)。结合他们的生产数据(我们已翻译):每块预填充 GPU 每秒 150 万个包含缓存的输入 token、96% 的输入缓存命中率、每块解码 GPU 每秒 14000 个输出 token(约 2400 块 GPU):
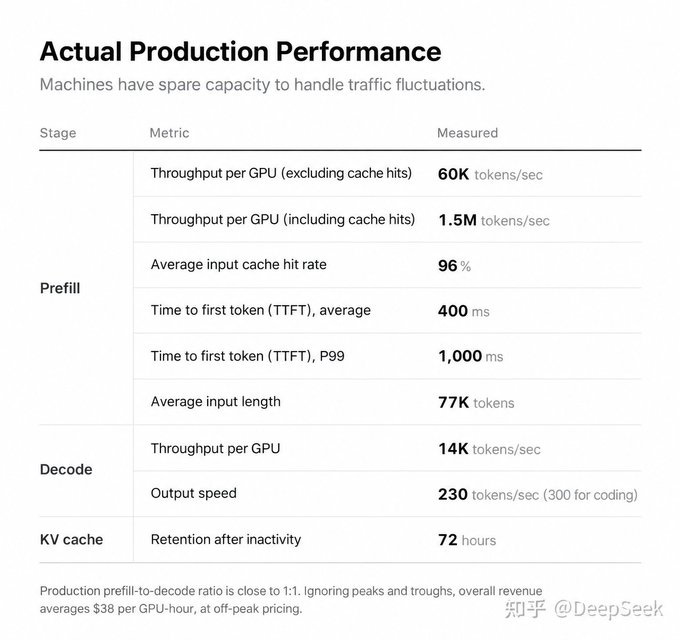
按每卡每小时 5—8 美元的全包成本计算,这就是超过 80% 的推理利润率!
做个集群层面的算术,这大约是每吉瓦 1660 亿美元,按推理利润计算回本周期为 81 天(DeepSeek 著名的计划是 10 个月回本)。想象一下这头鲸鱼拥有更多吉瓦时能做些什么。
由 SerpAPI 赞助!
用更少的 token 为你的 AI 智能体提供实时搜索数据
将 SerpApi 的 100 多个 API 中任意一个的结果接收为干净、结构化的 Markdown,平均比 JSON 少用约 50% 的 token。只需添加 output=md 或使用 /search.md 端点。它无需任何配置,并且所有套餐均免费附带此功能。
2026 年 10 月 19 日—10 月 20 日的 AI 新闻。我们检查了 12 个 subreddit、544 个 Twitter 账号,未检查更多 Discord。AINews 网站可搜索所有往期内容。提醒一下,AINews 现在是 Latent Space 的一个栏目。你可以选择开启/关闭邮件推送频率!
AI Twitter 回顾
头条:DeepSeek DeepInfer——生产级推理、开源边界与缓存 token 的经济学
发生了什么
DeepSeek 发布了支撑 V4.1 Flash 的推理引擎 DeepInfer,并同时公布了生产服务细节,使得这份工程报告与代码本身同样重要。
- 本次发布涵盖推理引擎和 API 处理层。 DeepInfer 支持分布式推理、投机解码、SWA 有界重放(SWA Bounded Replay)以及 NVIDIA 和华为昇腾平台上的结构化输出。随附的
deepseek-recipe组件实现了生产级 token 编解码以及与官方 API 兼容的处理。DeepSeek 表示,未来的模型推理实现与优化也将出现在该仓库中。@deepseek_ai、@deepseek_ai、公告翻译 - 公布的生产数据相当可观——但描述的是一项高度依赖缓存的服务。 DeepSeek 的工程报告(按所提供帖子的总结与引用)报告了单个集群每天 155 万亿 token、96% 的输入缓存命中率、平均首 token 时间 400 毫秒、每秒生成 230 个 token,编码场景达到每秒 300 个 token。它还报告了按非高峰价格计算的每加速器小时 38 美元收入。这些是第一方生产声明,并非独立审计的测量结果。@ZhihuFrontier、@swyx
- “完全开源”并不意味着整个生产服务都能通过本次发布复现。 尽管 DeepSeek 将 DeepInfer 描述为完全开源,但技术说明指出 KV 缓存管理和负载均衡组件尚未完全发布,因为它们仍与内部基础设施耦合。引擎是开源的;重要的服务级编排仍属于部署方的责任。@deepseek_ai、@ZhihuFrontier
- vLLM 给出了最具体的对比回应。 在承认 DeepInfer 最初主要基于 vLLM 构建并以 Apache 2.0 协议发布之后,vLLM 团队报告称,在匹配配置下,其在 GB200 上的解码吞吐量与 DeepInfer 公布结果相差不到 6%。它还发布了 AgentX 结果和复现步骤,实质性地质疑了“DeepSeek 的效率是现有开源引擎无法企及的”这一说法。@vllm_project、@vllm_project、复现资源
- 本次发布引发了两场不同的争论: DeepSeek 是否拥有独一无二的强大服务栈,以及其披露是否在更普遍意义上证明了推理业务的高盈利性。第一个问题现在已有对比基准证据;第二个问题仍受制于工作负载构成、缓存核算方式、硬件成本以及计入哪些费用。@Tim_Dettmers、@zephyr_z9、@Yuchenj_UW