Nathan Lambert 哈佛讲座:开源模型现状全景,中国开源全面领先,但美国有 10 倍以上的算力优势;蒸馏不是关键问题
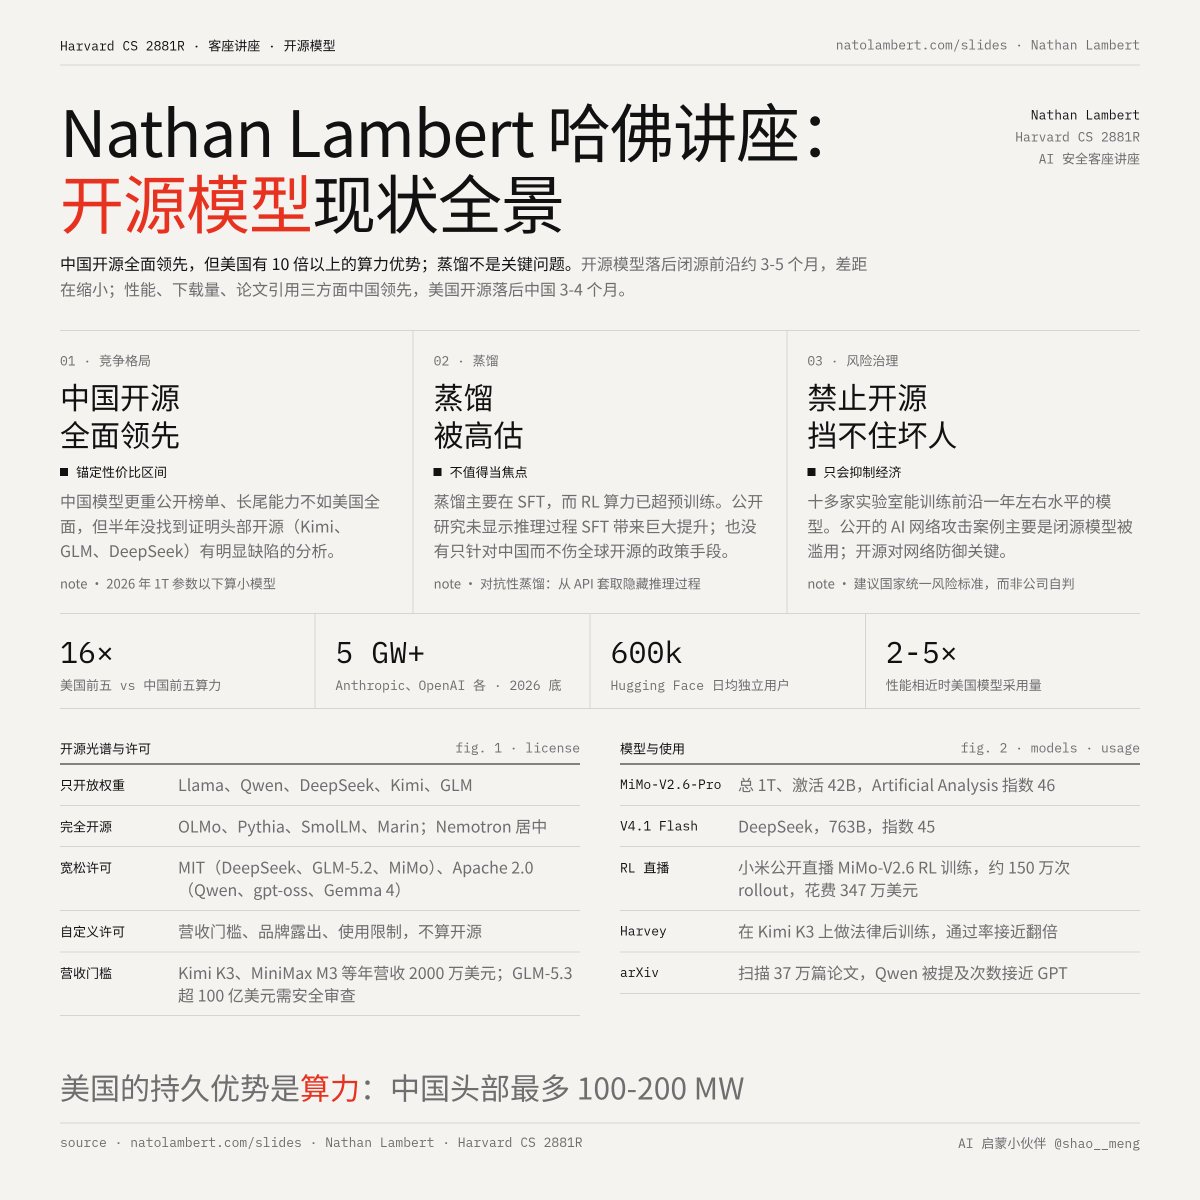
@natolambert 在哈佛大学 CS 2881R「AI 安全」的客座讲座,他认为:开源模型落后闭源前沿大约 3 到 5 个月,差距还在缩小。性能、下载量、论文引用这三方面,中国开源模型全面领先,美国开源模型又比中国落后 3 到 4 个月。核心判断有三点:把"蒸馏"当成核心问题是高估了;美国真正持久的优势是算力;禁止开源只会损害经济活动,挡不住坏人。
什么是开源模型,许可证是关键
· 开源是一个光谱:从只开放权重(Llama、Qwen、DeepSeek、Kimi、GLM),到连数据和代码都开放的完全开源(OLMo、Pythia、SmolLM、Marin),Nemotron 处在中间。
· 宽松许可证:MIT(DeepSeek、GLM-5.2、MiMo),Apache 2.0(Qwen、gpt-oss、Gemma 4)。
· 自定义许可证带附加条件,并不算开源:营收门槛(Kimi K3、Muse Spark Open、MiniMax M3 的年营收门槛是 2000 万美元,GLM-5.3 超过 100 亿美元要做安全审查)、品牌露出要求、使用限制。这些条款大多还没有在法庭上检验过。
为什么要开源
支持开源的力量来自几个方向:资本(把互补品变成廉价商品)、科研和教育、防止权力集中、自由。按 Bill Gurley 的说法,开源也是"第二名的自然选择",用来抢市场和分发渠道、获得软实力。中国实验室集体走向开源,是为了在西方 AI 圈获得存在感;DeepSeek R1 之后,小米、美团、蚂蚁等也纷纷入场。企业用开源模型来"拥有自己的模型",例如 Harvey 在 Kimi K3 上做法律方向的后训练,全部通过率接近翻倍,成本基本不变。
竞争力
· 2026 年,1T 参数以下就算"小模型"了。新近的强模型:小米 MiMo-V2.6-Pro(总参数 1T、激活 42B,Artificial Analysis 指数 46)、DeepSeek V4.1 Flash(763B,45)、MiniMax M3.1 Flash(42,第三方测评低于官方宣传)。
· 关于"刷榜":中国模型确实更看重公开榜单,长尾能力也不如美国模型全面。但他花了半年时间,也没找到能证明头部开源模型(Kimi、GLM、DeepSeek)有明显缺陷的分析。
· 开源模型依然锚定着性价比的最优区间,不过闭源厂商现在也开始在这个区间竞争。
蒸馏之争(全篇最有观点的部分)
· 训练分三个阶段:预训练、中期训练和 SFT、强化学习。蒸馏主要发生在 SFT 阶段,而现在强化学习消耗的算力已经超过预训练。
· 现在说的"蒸馏"其实是对抗性蒸馏:想办法从 API 里套取被隐藏的推理过程。中国不少实验室有专门的团队做这件事。
· 他认为不值得把它当成焦点:公开研究并没有显示用推理过程做 SFT 能带来巨大提升;没有好的政策手段可以只针对中国而不伤害全球开源生态;中国实验室本身就很强,"快速跟进"本来就比开拓前沿省算力。小米公开直播了 MiMo-V2.6 的强化学习训练(约 150 万次 rollout,花费 347 万美元),就是不只依赖蒸馏的证据。
· 真正持久的优势是算力:美国前五家实验室的总算力平均是中国前五家的 16 倍;到 2026 年底,Anthropic 和 OpenAI 各有 5 GW 以上的算力,而中国头部实验室最多只有 100 到 200 MW。
使用情况
开源模型的推理量快速增长,本地模型下载在加速;Hugging Face 日均独立用户约 60 万。性能相近时,美国模型的采用量是中国模型的 2 到 5 倍,说明市场对美国开源模型有需求。他扫描了 37 万篇 arXiv 论文,Qwen 被提到的次数已经接近 OpenAI 的 GPT。总结是:性能、下载、科研三方面中国都领先,推理和后训练市场也主要是中国模型。
风险与治理
· AI 驱动的网络攻击已经真实发生,而目前公开的案例主要是闭源模型(Claude Code、Codex)被滥用。
· 想禁止开源模型,在现实中做不到(美国不可能建起有效的"防火墙"),而且十多家实验室都能在前沿一年左右的水平上训练模型,结果只会抑制经济活动。不少关于开源风险的说法被夸大了(比如虚假信息),但深度伪造这类风险确实被加速了。
· 建议:发布方按每个模型评估它带来的"额外风险",并由国家统一风险标准,而不是让各家公司自己判断。开源模型对网络防御非常关键,因为公司的受信任访问项目没法覆盖整个经济。
natolambert.com/slides/2026/ha…
Nathan Lambert@natolambert
终于整理出了一份关于开放模型现状的完整演示文稿。
内容涵盖:它们是什么、许可证、竞争力如何、人们正在使用它们的迹象、蒸馏的影响,以及我们如何平衡开放带来的风险与收益!
我很快会录制一期这些内容的视频讲座,希望每年能重做几次。
