发布 Artificial Analysis Coding Agent Index v2.0:Cognition 的 FrontierCode v1.1 取代 DeepSWE,SWE-Atlas-QnA 评分修订,Claude Code 中的 Claude Opus 5.5 以 61.7 分领先
我们发布 Artificial Analysis Coding Agent Index v2.0,这是对编码智能体(Coding Agent)综合评测的一次重大更新。本次更新包括:用 Cognition 的 FrontierCode v1.1 取代此前的 DeepSWE 基准,修订 SWE-Atlas-QnA 的评分方式,并纳入最新一批智能体与模型的评测结果。
本次更新要点
- 基准替换:Cognition 的 FrontierCode v1.1 取代 DeepSWE,成为索引中的核心编码能力基准。
- 评分修订:SWE-Atlas-QnA 的评分规则经过修订,以更准确地反映智能体在真实问答任务上的表现。
- 榜单变化:Claude Code 中的 Claude Opus 5.5 以 61.7 分位居榜首。
%%IMG1%%
排名概览
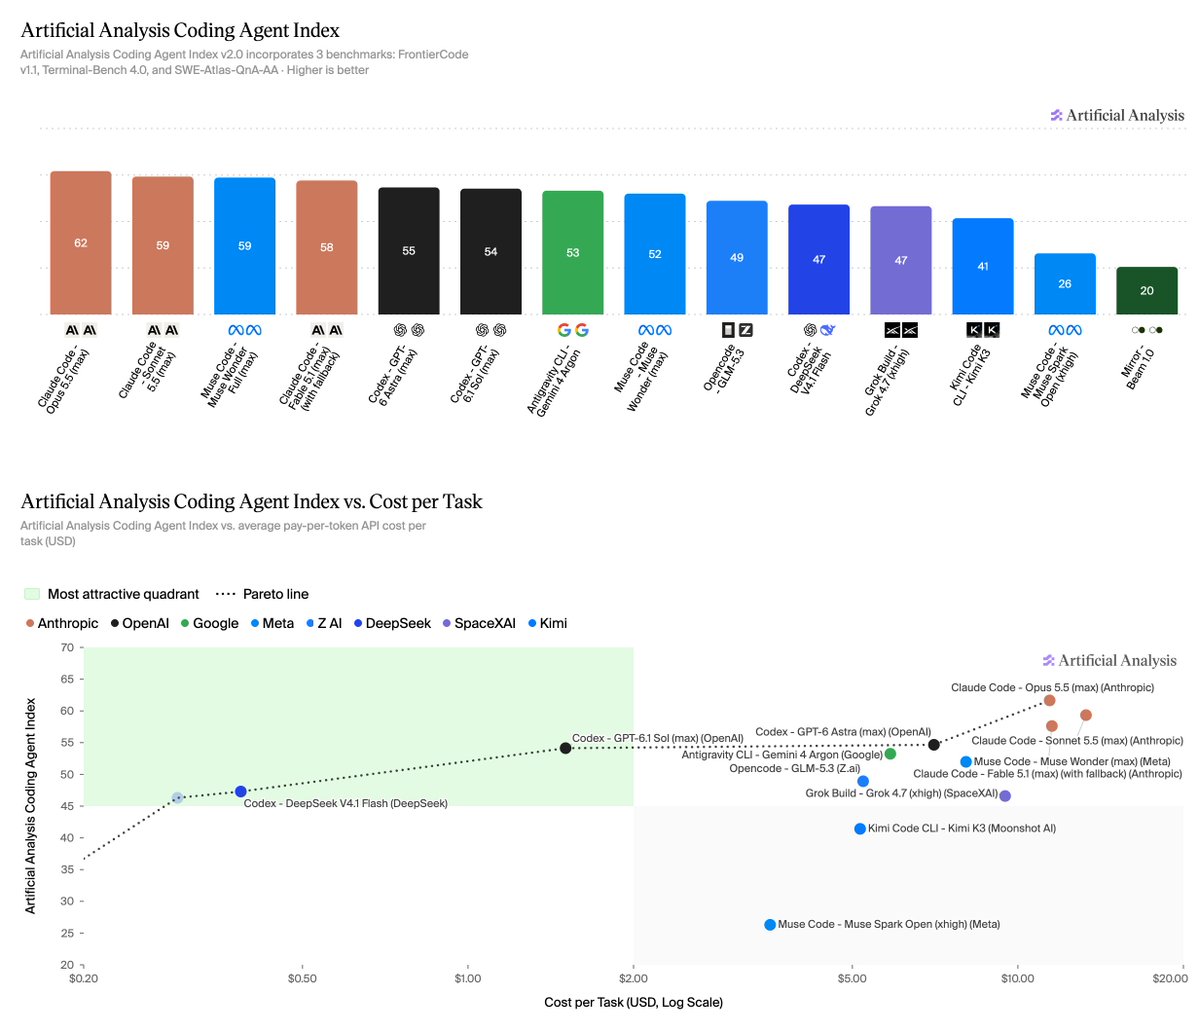
在 v2.0 索引中,Claude Code 中的 Claude Opus 5.5 以 61.7 分排名第一。紧随其后的是其他前沿编码智能体配置,完整排名与各分项得分见上方图表及下方数据说明。
FrontierCode v1.1
FrontierCode v1.1 由 Cognition 开发,用于评估编码智能体在贴近真实软件工程任务上的能力。相较于此前使用的 DeepSWE,FrontierCode v1.1 在任务设计、评分粒度与覆盖范围上均有更新,因此本版本索引的分数与历史版本不可直接横向比较。
SWE-Atlas-QnA 评分修订
SWE-Atlas-QnA 用于衡量智能体在软件工程相关问答任务上的表现。本次修订调整了评分规则,使评分更能反映答案的正确性与完整性。修订后的评分已应用于本版本全部参评智能体的结果。
如何解读本索引
Coding Agent Index 旨在对编码智能体进行端到端评估,而非仅评测底层模型。同一模型在不同智能体框架(如 Claude Code 等)中的表现可能存在差异,因此索引以「智能体 + 模型」的组合为单位进行排名。
支持状态
本索引持续跟踪主流编码智能体与模型的组合。随着新模型与新智能体框架发布,我们会定期更新参评列表与评测结果。
快速开始
如需查看完整排名、分项得分与评测方法说明,请访问 Artificial Analysis 网站上的 Coding Agent Index 页面。
技术栈
本索引的评测流程涵盖任务执行环境、智能体框架适配、结果评分与聚合排名等环节,具体方法说明请参见官方文档。
今天我们发布 Coding Agent Index 的 v2.0 版本。该指数将模型与其智能体运行框架(agent harness)放在一起评估,目前覆盖 290 项任务,涵盖软件工程、终端使用和代码仓库问答,三项基准测试权重相同。
更新日志(Index v1.5 → Index v2.0):
- 本次未提供可整理的资讯正文内容,仅有一行章节标题,无法生成符合要求的全文翻译与结构化 Markdown 正文。
FrontierCode v1.1 取代了 DeepSWE v1.1。FrontierCode 是 @cognition 推出的一个基准测试,带有一个非公开测试集:包含 100 个基于真实开源仓库的软件工程任务,评分标准是维护者是否会合并该改动。只要有一项阻断性检查未通过,该尝试即得零分;若全部通过,则根据满足的非阻断性检查情况,得分在 70% 到 100% 之间。我们还会用 Cognition 规则扫描器的修改版对每条执行轨迹进行扫描,任何被标记为访问了解决方案材料的尝试均得零分。
修订了 SWE-Atlas-QnA 的评分方案,现更名为 SWE-Atlas-QnA-AA。Scale AI 的 124 个仓库问答任务保持不变。我们对 1,306 条评分标准中的 127 条进行了措辞调整,以使判定结果更加一致,并将评判模型切换为 GPT-6 Luna(xhigh),每条标准进行五次投票。数据集与评判配置已发布在 Hugging Face 上。
主要结果:
Claude Opus 5.5 领跑指数:Claude Code 搭配 Claude Opus 5.5(max)得分 61.7
Claude Opus 5.5 在指数中领先:Claude Code 搭配 Claude Opus 5.5(max)得分为 61.7,紧随其后的是 Claude Code 搭配 Claude Sonnet 5.5(max)的 59.3,Muse Code 搭配 Muse Wonder Full(max)的 58.9,以及 Claude Code 搭配 Claude Fable 5.1(max,带 fallback)的 57.6。
➤ 在 FrontierCode v1.1 上,Opus 5.5 拉开了领先优势:Opus 5.5 在 FrontierCode 上得分 56.0%,领先于 Codex 搭配 DeepSeek V4.1 Flash(max)的 52.6%、Codex 搭配 GPT-6.1 Sol(max)的 49.4%,以及 Codex 搭配 GPT-6 Astra(max)的 49.3%。在头部之下,FrontierCode 的分数分布十分密集:该指数上 24 个配置中有 15 个的得分落在 43% 至 49% 之间。
➤ SWE-Atlas-QnA-AA 的评分更严格、也更一致:在两个 Index 版本上共同评估的 21 个配置中,平均分下降 1.7 分,从 58.8% 降至 57.1%,其中 21 个配置里有 14 个分数下降。单个配置的变动幅度最多可达 7 分:Muse Code 搭配 Muse Spark Open(xhigh)下降 7.0 分,Kimi K3 在 Kimi Code CLI 中、以及 Codex 搭配 GPT-6 Luna(max)下降 6.2 分,Muse Code 搭配 Muse Wonder(max)下降 5.6 分,而 Codex 搭配 GPT-6.1 Sol(max)则上升 2.1 分。
成本前沿上的四种配置: Codex 搭配 DeepSeek V4.1 Flash(max)得分 47.3,每任务成本 $0.39;Codex 搭配 GPT-6.1 Sol(max)得分 54.1,成本 $1.50;Codex 搭配 GPT-6 Astra(max)得分 54.7,成本 $7.04;Claude Code 搭配 Claude Opus 5.5(max)得分 61.7,成本 $11.42。成本为按 token 计费的 API 费用,而非订阅价格。
我们将持续增量更新「编程智能体指数」(Coding Agent Index),后续会加入更多评测与更多智能体。