
Jess Weng 2026年10月14日 10分钟 返回博客 创建 Agent 分享
核心要点
- 当长时间运行的 Agent 累积的上下文超出模型能容纳的范围时,就会出现「上下文腐化」(context rot),导致准确率下降。
- 深度 Agent(Deep Agents)是 LangChain 的开源 Agent 运行框架(harness),它使用五种技术把上下文移出活动窗口(而不是删除它),以防止上下文腐化。
- 在深度 Agent 中,Agent 的记忆以纯文件形式存储在你可控的存储中,因此你可以切换模型或提供商,同时保留它学到的一切。
如果你曾在考前一晚临时抱佛脚,你就懂那种感觉:学得越多,前面几章反而开始从脑中滑走。
Agent 也有同样的问题。当它们承担更长的任务时,会接收越来越多的信息(指令、工具结果、文件等);最终这会变成过多的上下文,难以舒适地放进模型的上下文窗口中。模型承载的历史、噪声和工具输出越多,其准确性和推理能力往往越差。
在 Agent 工程领域,我们称之为上下文腐化。本文介绍管理 Agent 上下文窗口的技术,以及深度 Agent 框架如何利用名为中间件(middleware)的概念,将这些技术注入 Agent 的运行过程。
理解上下文工程技术
简单来说,Agent 就是一个被运行框架包裹的模型。
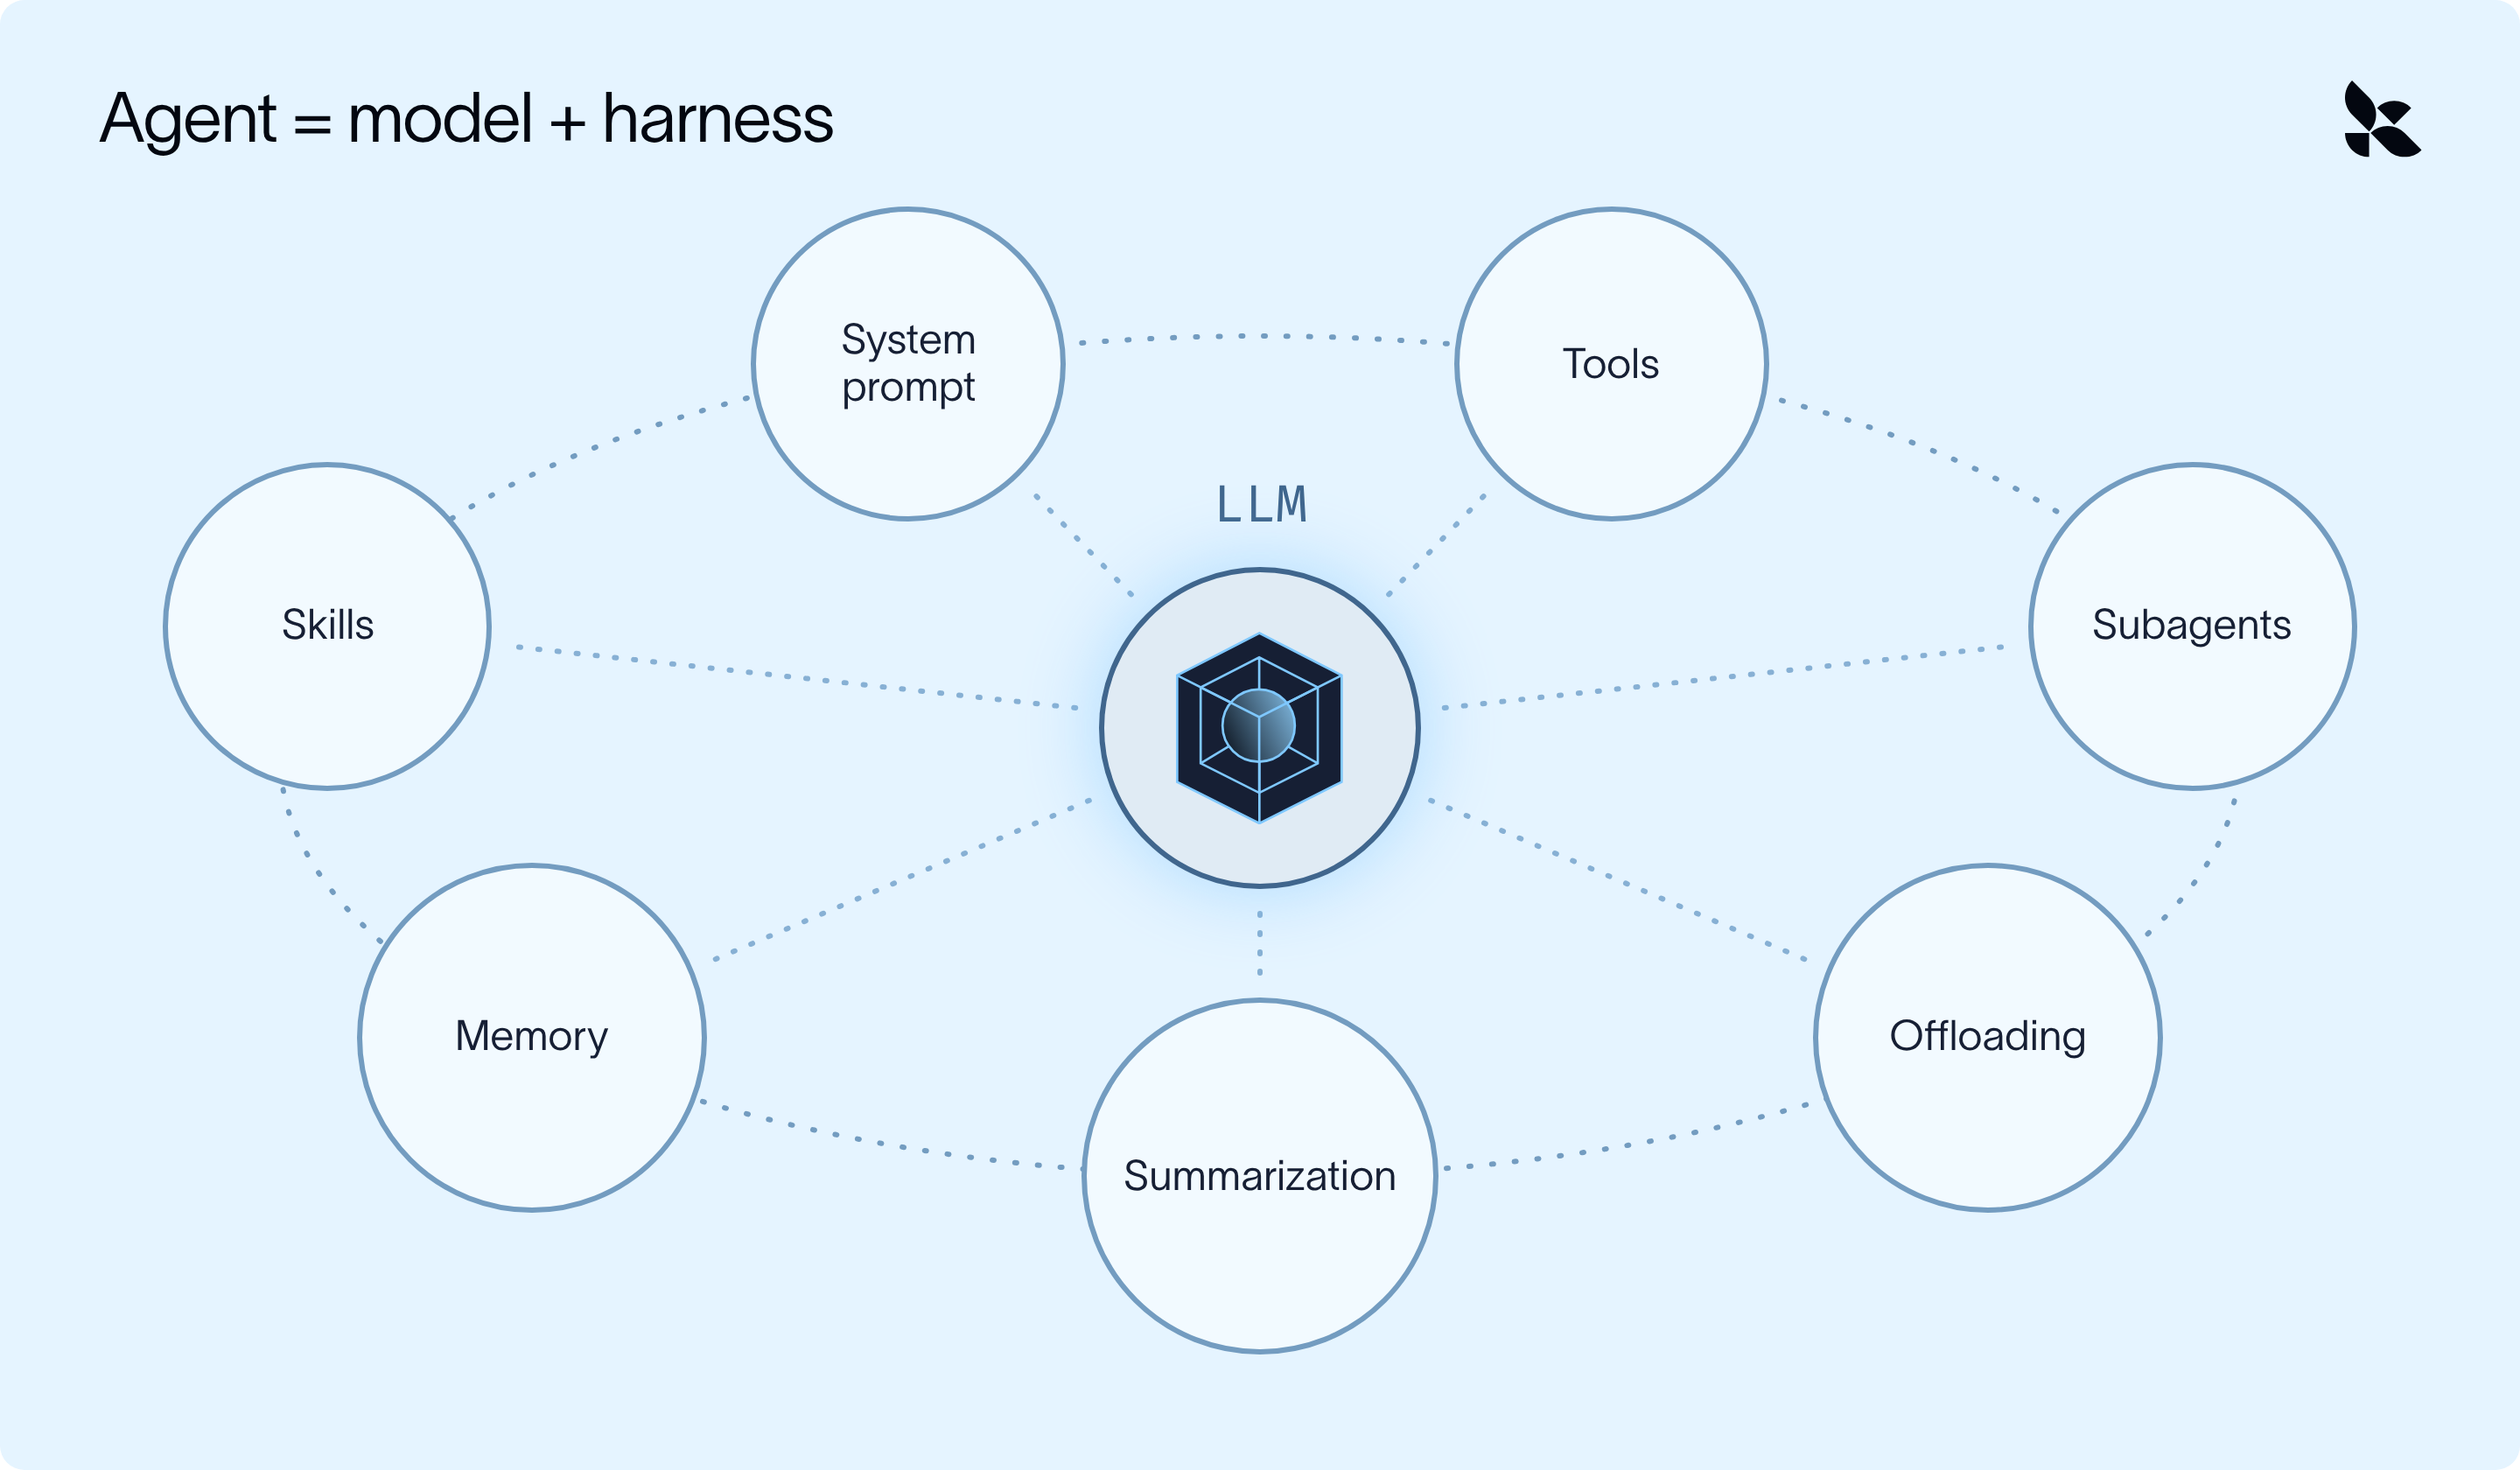
Agent 可用来应对上下文腐化的上下文工程技术主要分为两类:
- 防止不必要的信息进入上下文窗口
- 管理和过滤已经在上下文窗口中的内容
运行框架会策略性地应用这些方法,为给定任务在正确的时间给模型正确的上下文(检索)。
然而,要接好一个能出色完成这件事的运行框架,说起来容易做起来难,需要大量工作(如果你是那种考前临时抱佛脚的人,可能工作量太大了)。
深度 Agent 是 LangChain 的开源运行框架。它用各种技术包裹你选择的模型,把上下文移出活动窗口(移入文件、摘要或单独的 Agent),让主 Agent 只携带它需要的内容(并且可以在之后需要时恢复原始数据):
- 卸载(Offloading): 大型工具结果和用户消息被保存到文件系统,模型只看到预览。
- 摘要(Summarization): 当对话接近上下文限制时,较早的消息被压缩成摘要。
- 技能(Skills): 任务知识只在模型判断其相关时才加载。
- 子 Agent(Subagents): 嘈杂的工作在单独的上下文窗口中运行,只把结果带回来。
- 长期记忆(Long-term memory): Agent 学到的东西被保存到一个文件中,并延续到下一次对话。
将上下文工程应用于常见用例
让我们看看如何将上述技术应用到一个真实场景中:一个竞品分析 Agent。每周一,这个 Agent 会调研五家竞争对手,并按照团队模板撰写一份报告。单次运行大致如下:
- 拉取公司 A 的市场数据导出文件(数万行)
- 搜索新闻、阅读几篇文章并做笔记
- 对公司 B 到 E 重复上述步骤
- 起草报告,根据你的反馈进行修改,并完成排版
到第 4 步时,这个 Agent 在每次模型调用中都会携带五份原始导出文件、数十条搜索结果和两份过时的草稿。其中大部分内容对最终报告的排版毫无用处。
检索方法(RAG,或文件系统搜索)能帮助 Agent 只 拉取它需要的内容,但这仍然只解决了一半问题。即便是精准的 Agent 也会累积不必要的消息、工具结果和中间工作产物,因此运行框架(harness)还必须管理上下文窗口内部及其周围已经存在的内容。
如何实现这些技术:中间件
Agent 在一个循环中运行:模型决定要做什么、调用工具、读取结果,然后重复,直到任务完成。中间件(Middleware) 是接入该循环中特定位置的代码:例如在 Agent 启动之前、在每次模型调用前后,或在每次工具调用前后。
- 在每个接入点,它可以读取上下文,并在下一步运行之前对其进行修改。
- 本文中的每一项上下文工程技术,都是挂接到这些接入点之一的中间件。
- 其中大部分是内置的,因此你无需编写任何中间件即可使用这些技术(除非你想自定义某些具体内容)。
卸载:将其留在上下文窗口之外
我们的 Agent 并不总是需要看到每次工具调用或人类消息返回的 全部 数据,尤其是当数据量很大时。
例如,每次 pull_market_report 工具调用都会返回一份完整的数据导出文件(数千行);然而,Agent 只需要其中的几个数字,因此可以限制模型只看到那几行。
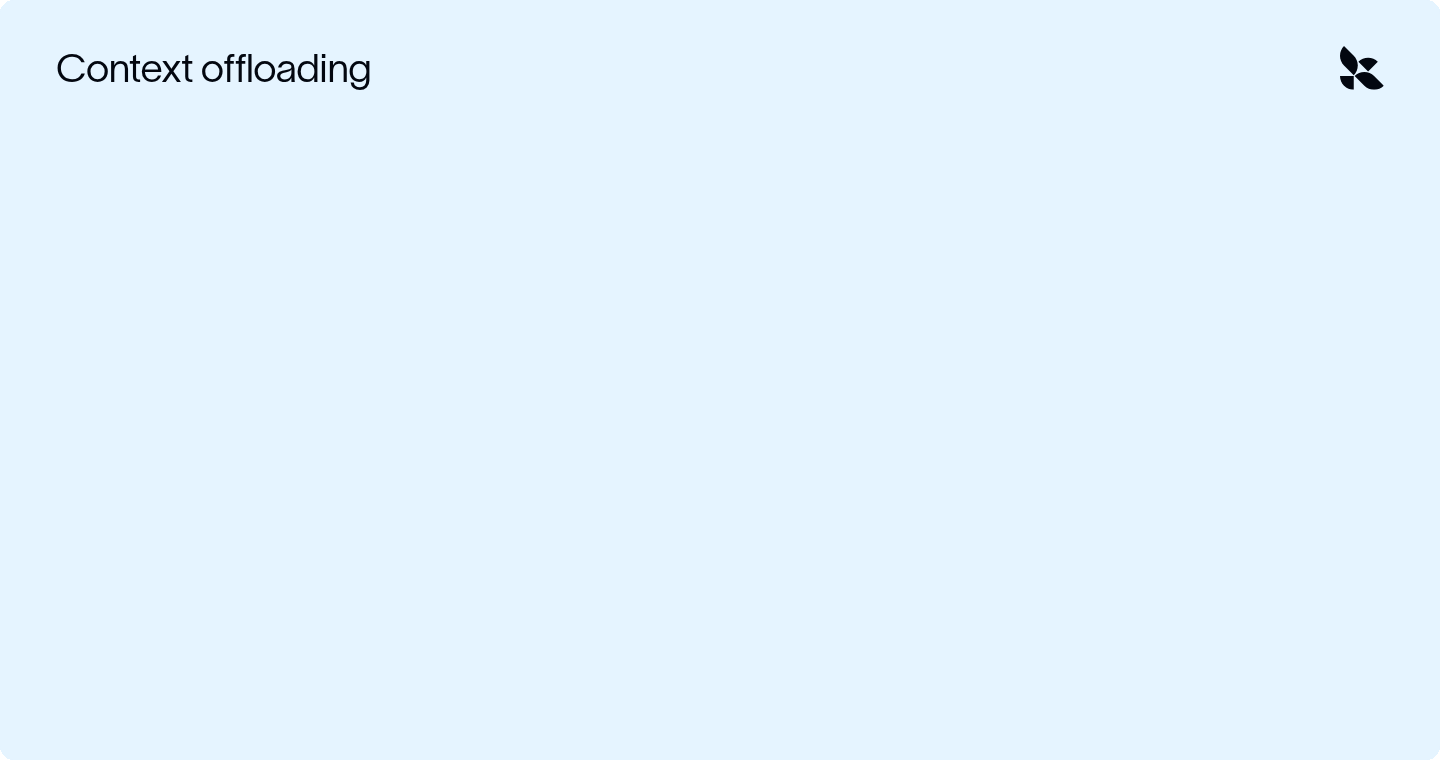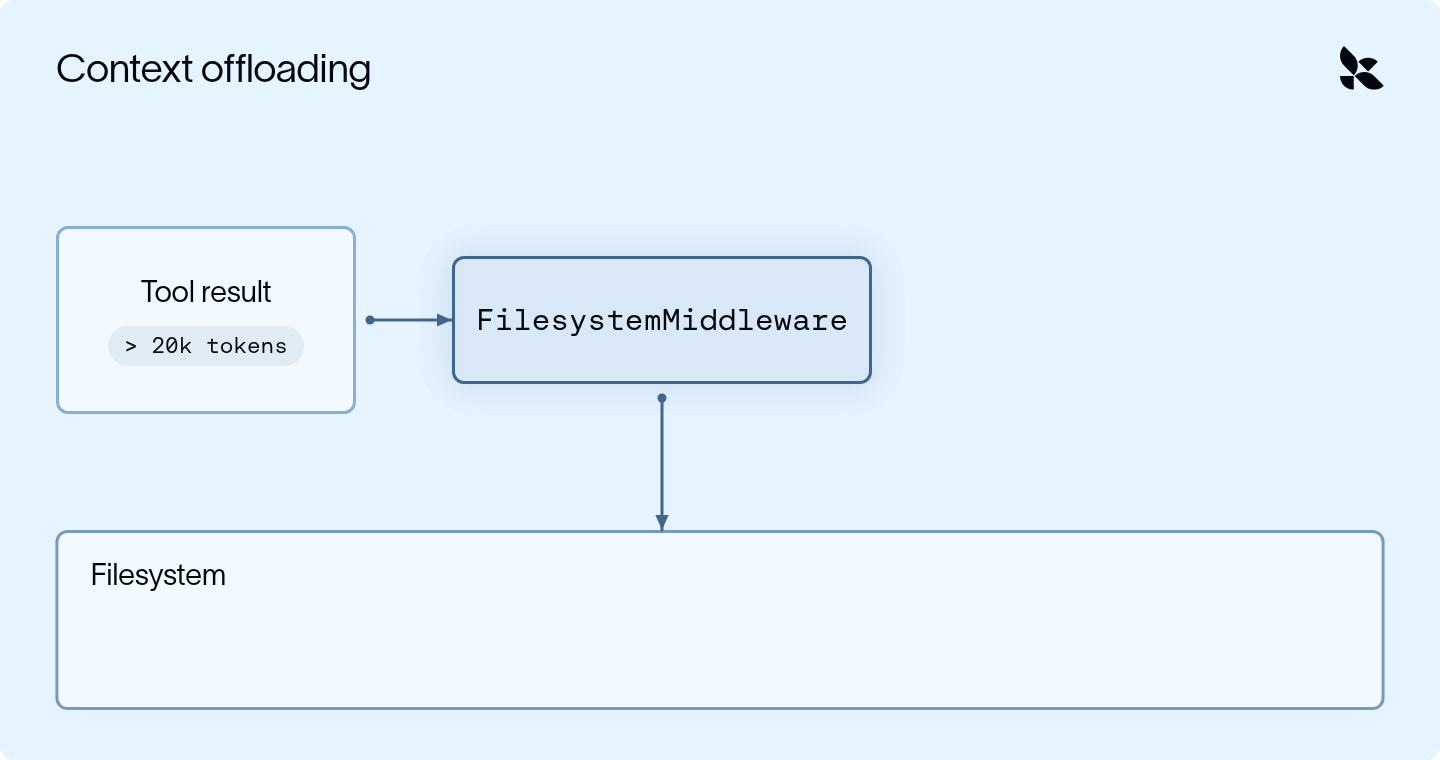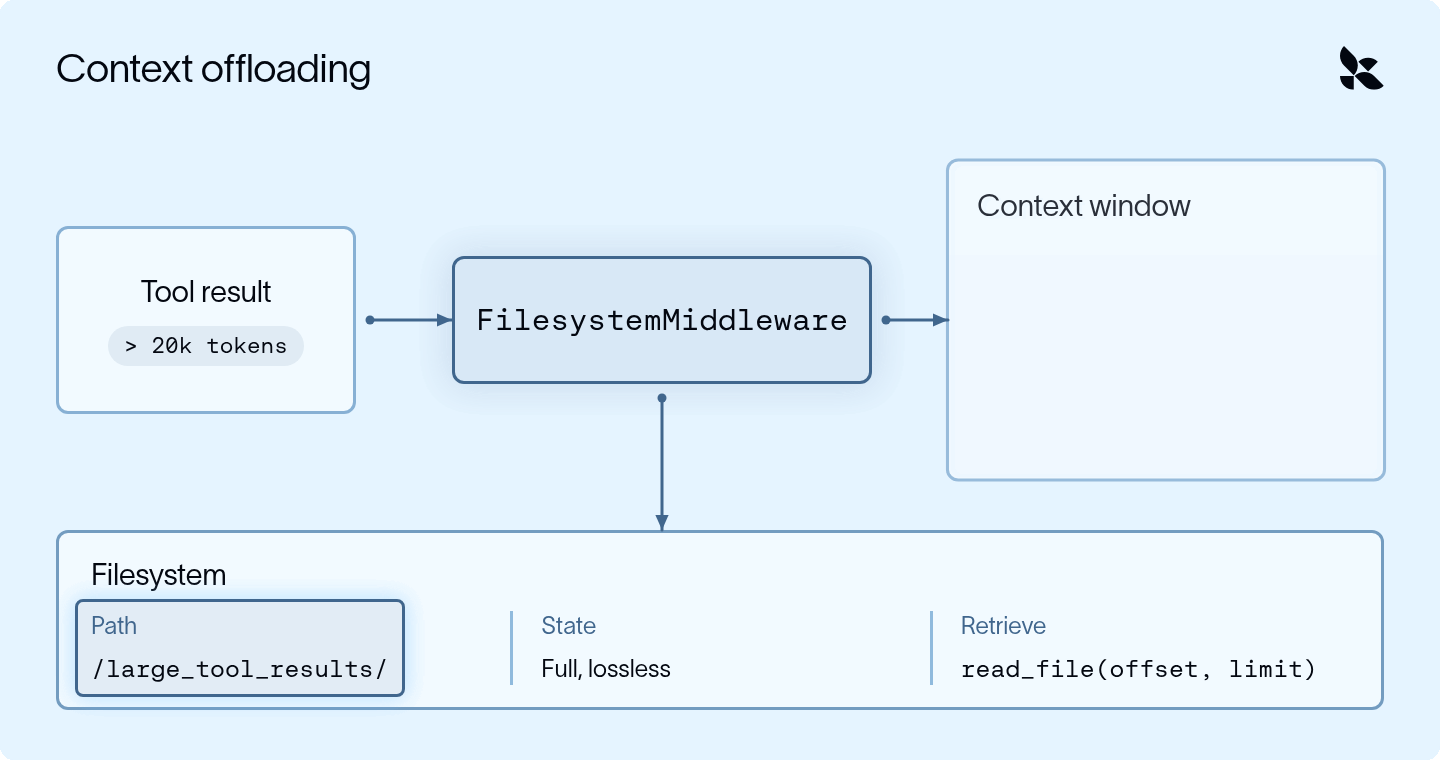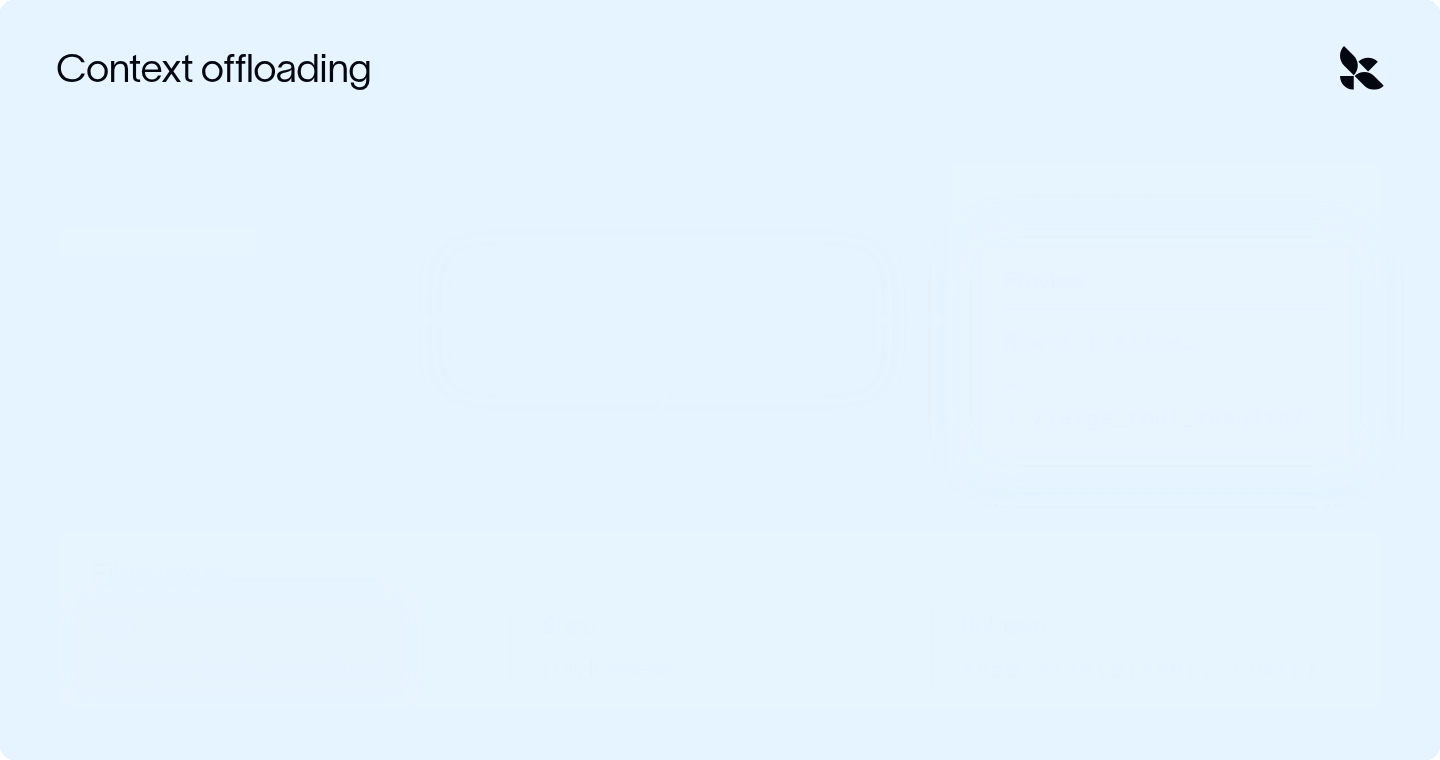
FilesystemMiddleware 在每次调用工具时运行:
- 当工具结果超过约 20,000 个 token 时,完整结果会在进入对话之前被写入 /large_tool_results/{tool_call_id}。
- 模型只能看到一段简短预览(开头和结尾几行)以及文件路径。
- 当 Agent 稍后需要公司 B 的季度营收时,它会使用 read_file 逐页读取该文件。
过大的用户/人类消息(例如粘贴的通话记录)会以更高的阈值(50,000 个 token)接受同样的处理,并被保存到 /conversation_history/。
摘要:压缩已有内容
尽管我们尽可能把冗长的工具调用卸载(offload)出去,在长时间运行中(例如五家公司的搜索、笔记和草稿),上下文仍会逐渐堆积。摘要(Summarization)可以把 agent 的整个上下文窗口浓缩为对迄今所发生事情的总结,让它得以继续推进研究任务。
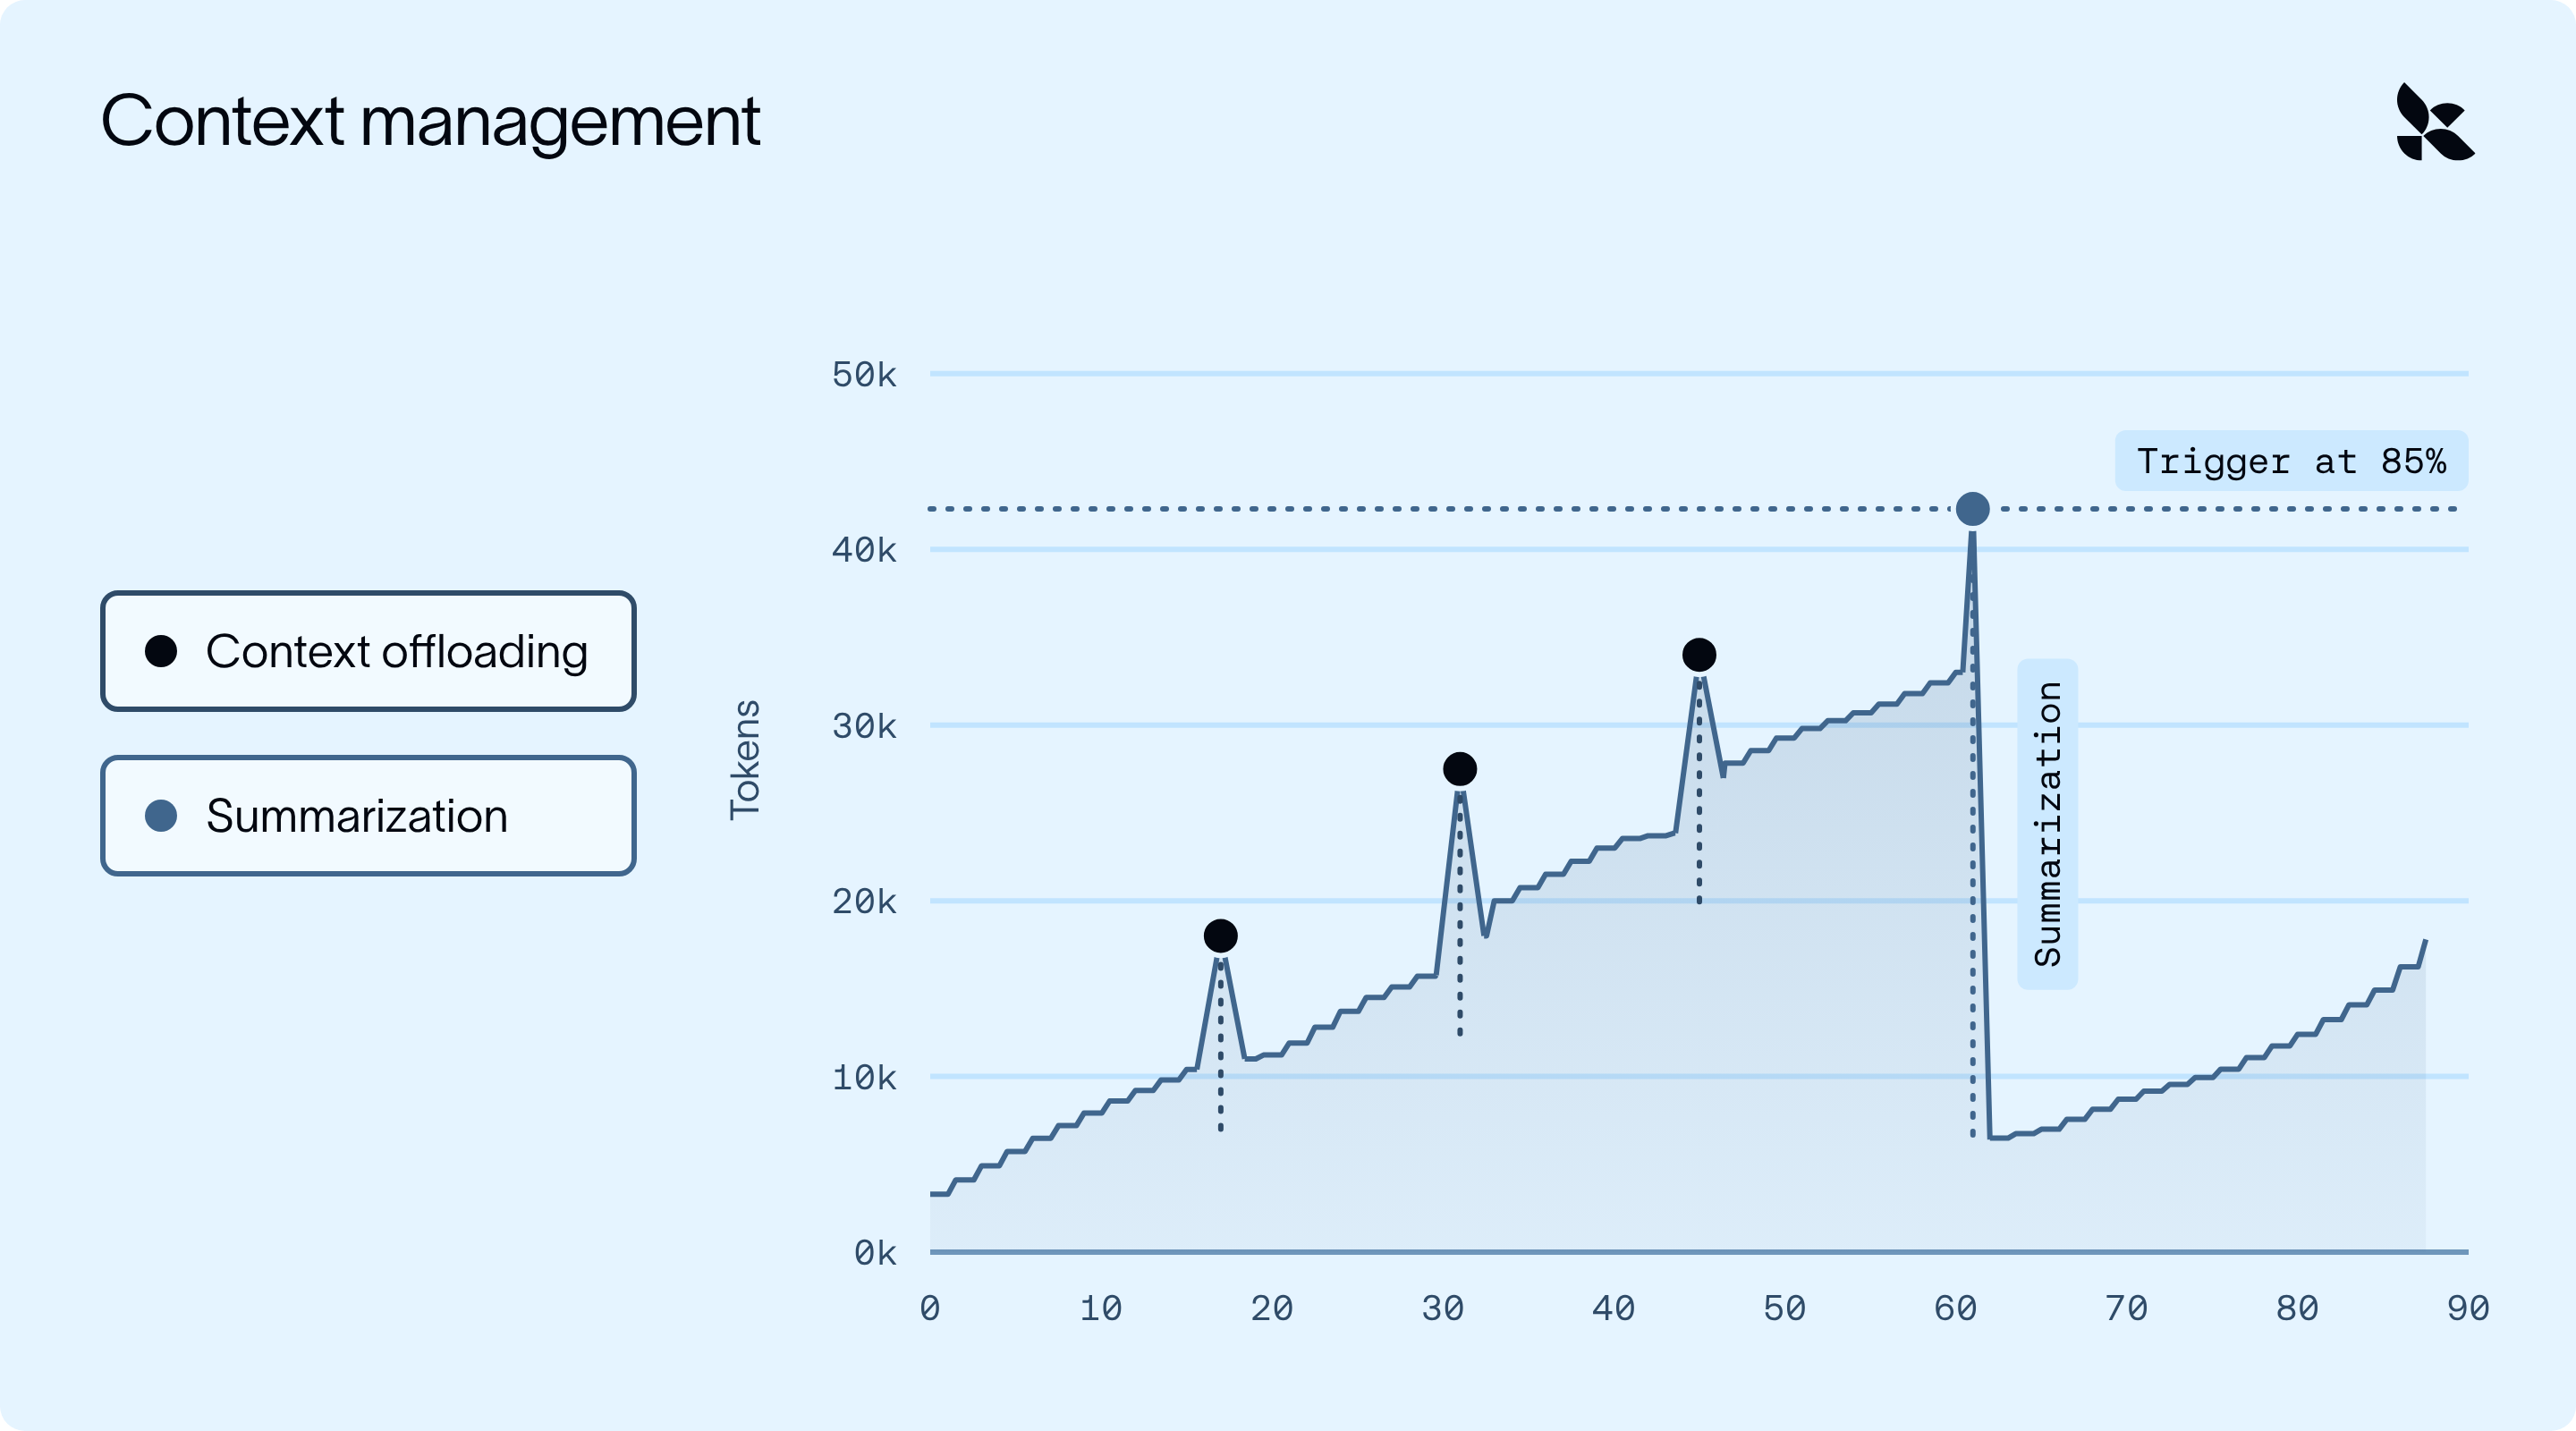
- 图中的尖峰是大型工具结果/人类消息到达所致;卸载会在模型看到之前把每一条替换成简短预览,因此上下文只会小幅增长。
- 摘要机制应对的是缓慢攀升:一旦使用率达到 85%,较早的消息就会被浓缩成一份摘要,上下文随之回落。
SummarizationMiddleware 会在每次模型调用前检查 token 用量:
- 一旦用量越过阈值(默认为模型上下文窗口的 85%),就发起一次独立的 LLM 调用,把较早的消息浓缩为一份摘要。
- 较早的消息会从上下文窗口中移除,而最近的消息则逐字保留。
- 模型现在先看到摘要,再看到最近的消息(因此近期内容不会被改写)。
两个重要细节:
- 它是可恢复的。 被摘要的消息会写入 /conversation_history/{session_id}.md。如果 agent 在撰写时需要 A 公司研究中的某个细节,它可以再读回来。
- 它是循环进行的。 随着运行继续,用量会再次攀升,下一次摘要会包含上一份摘要。
你也可以在话题切换时进行摘要,而不只是在达到某个 token 阈值时。自定义摘要提示词(prompt)往往会很有帮助。
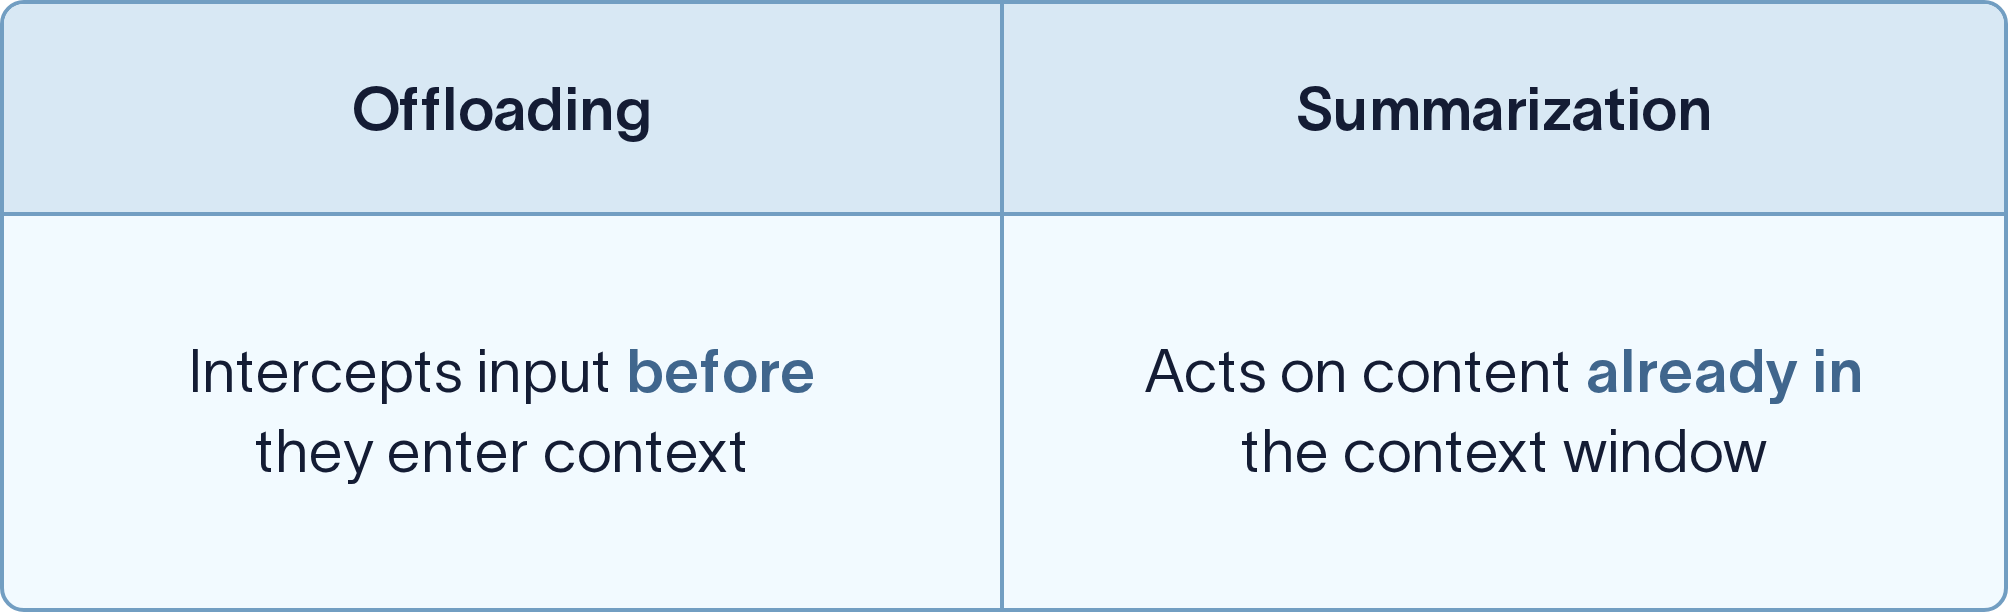
我们关于Deep Agents 上下文管理的文章对这两者都有更详细的介绍。
技能:只在需要时加载信息
假设你的销售团队对季度业务回顾(QBR)有特定的格式要求。agent 每季度才需要一次这些说明,若把它们放在系统提示词里,就意味着每次调用都要为它们付出代价(token 与响应时间)。你可以改为把这类信息打包成一个技能(skill)。
技能是一个存放说明的文件夹(可附带脚本和参考文档),为 agent 提供完成某项专门任务所需的信息。
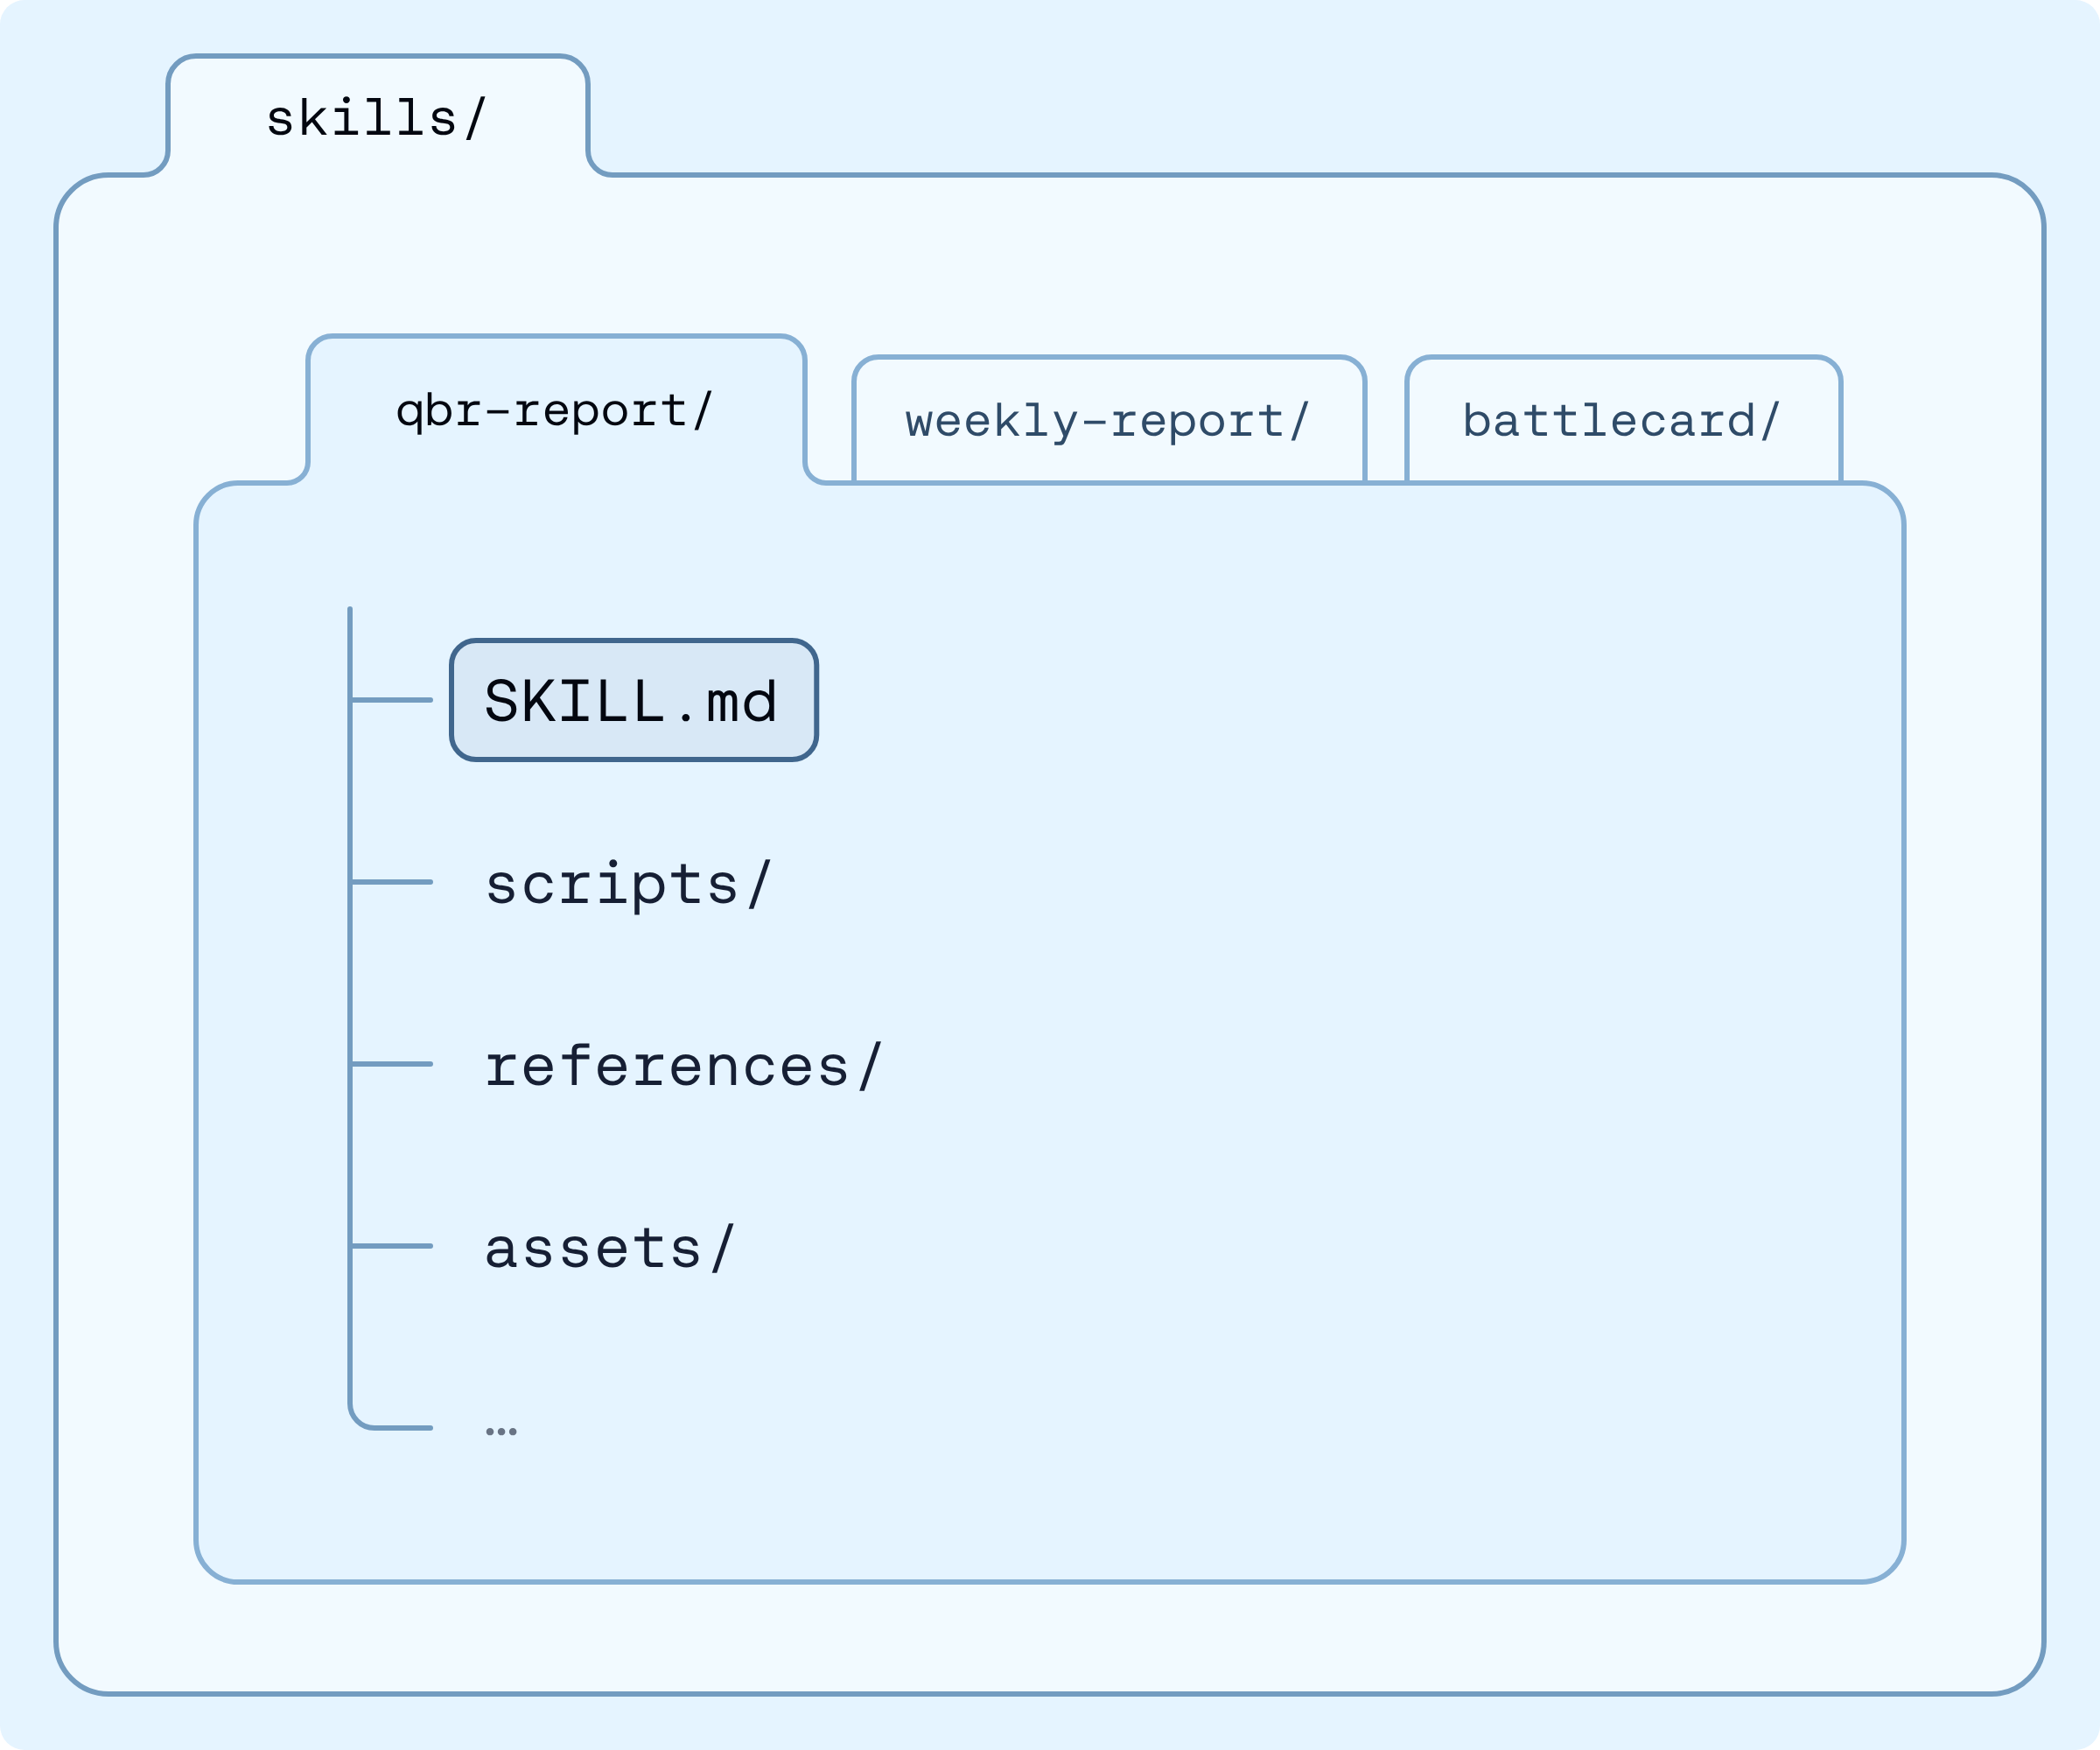
agent 一开始只会看到一段简短描述,只有当 QBR 出现时才加载 qbr-report 的完整说明(其他任务永远不会携带这些说明)。
技能按层加载上下文,因此在真正相关之前,上下文窗口可以保持很小。这被称为渐进式披露(progressive disclosure):模型先看到一份“菜单”,需要时才取来完整配方,所以十个技能消耗的上下文大约相当于十句单行简介。
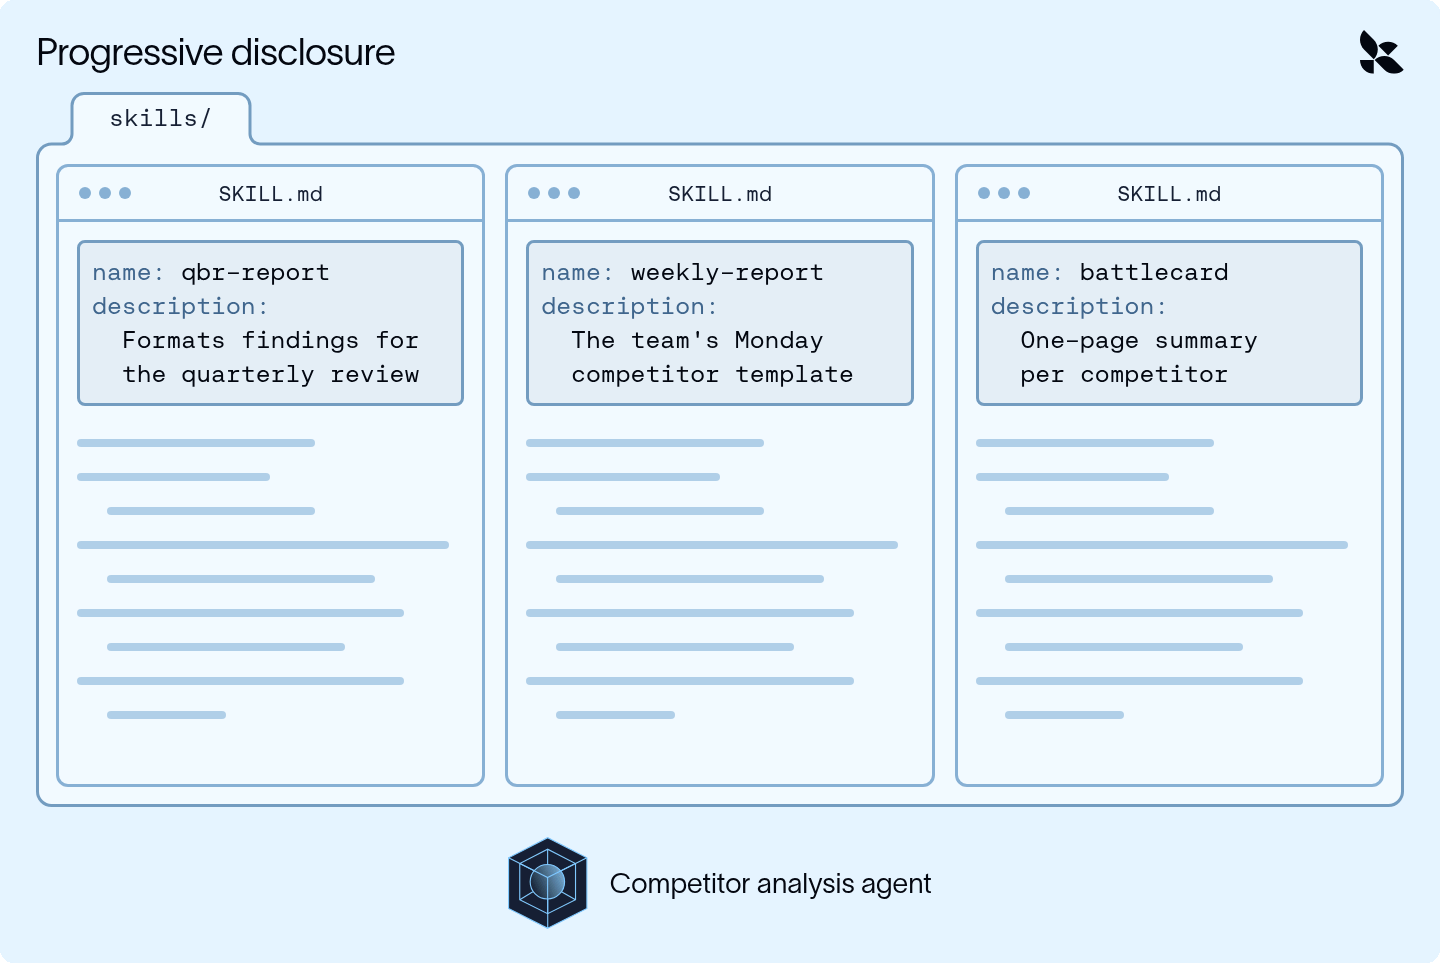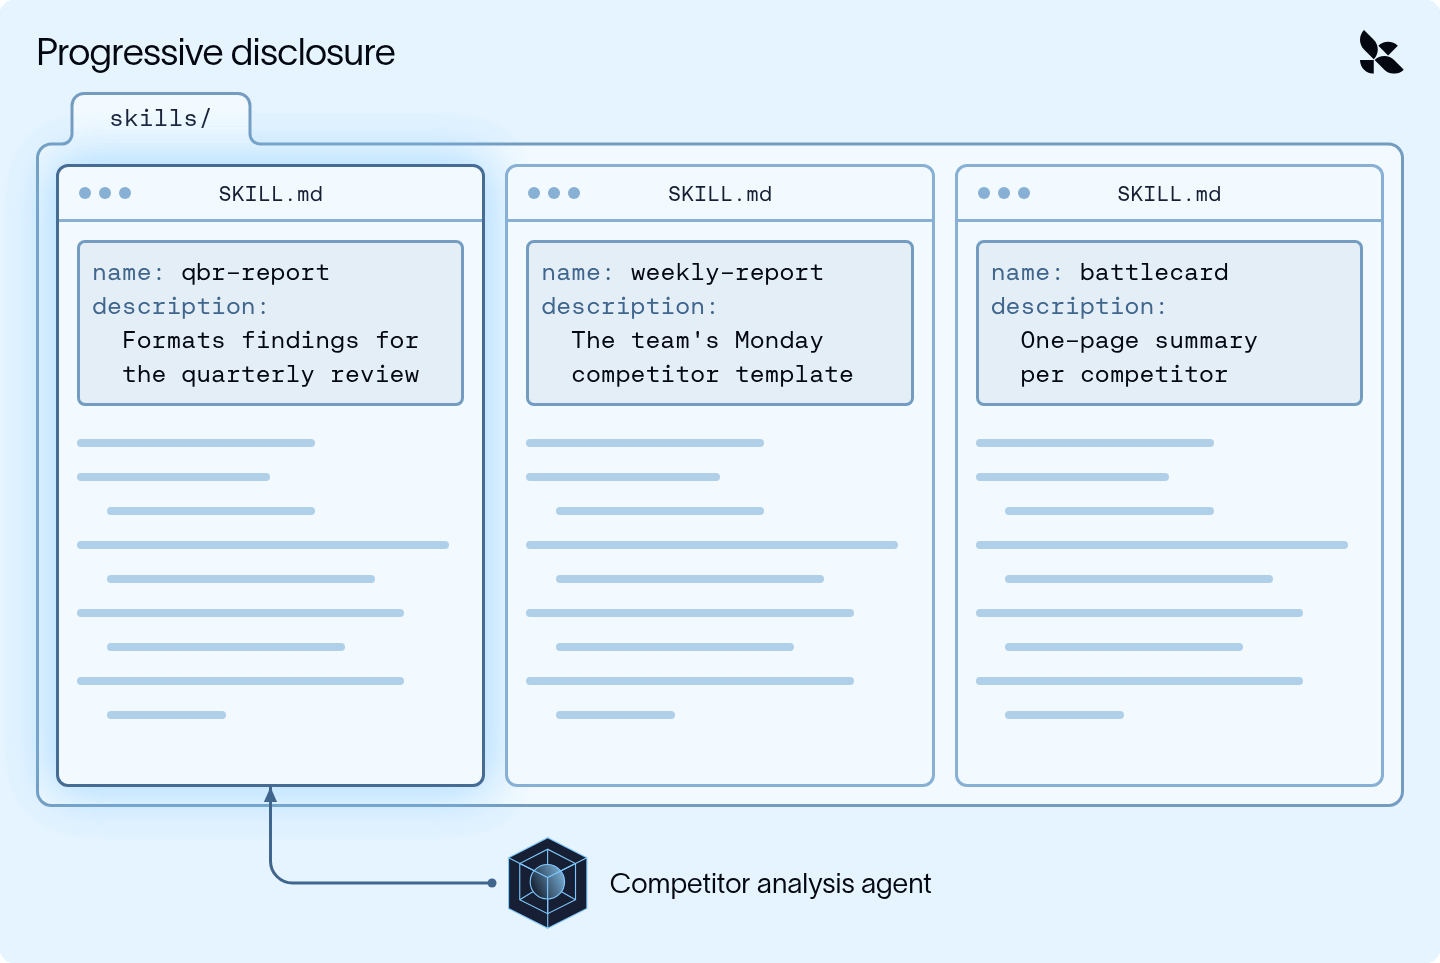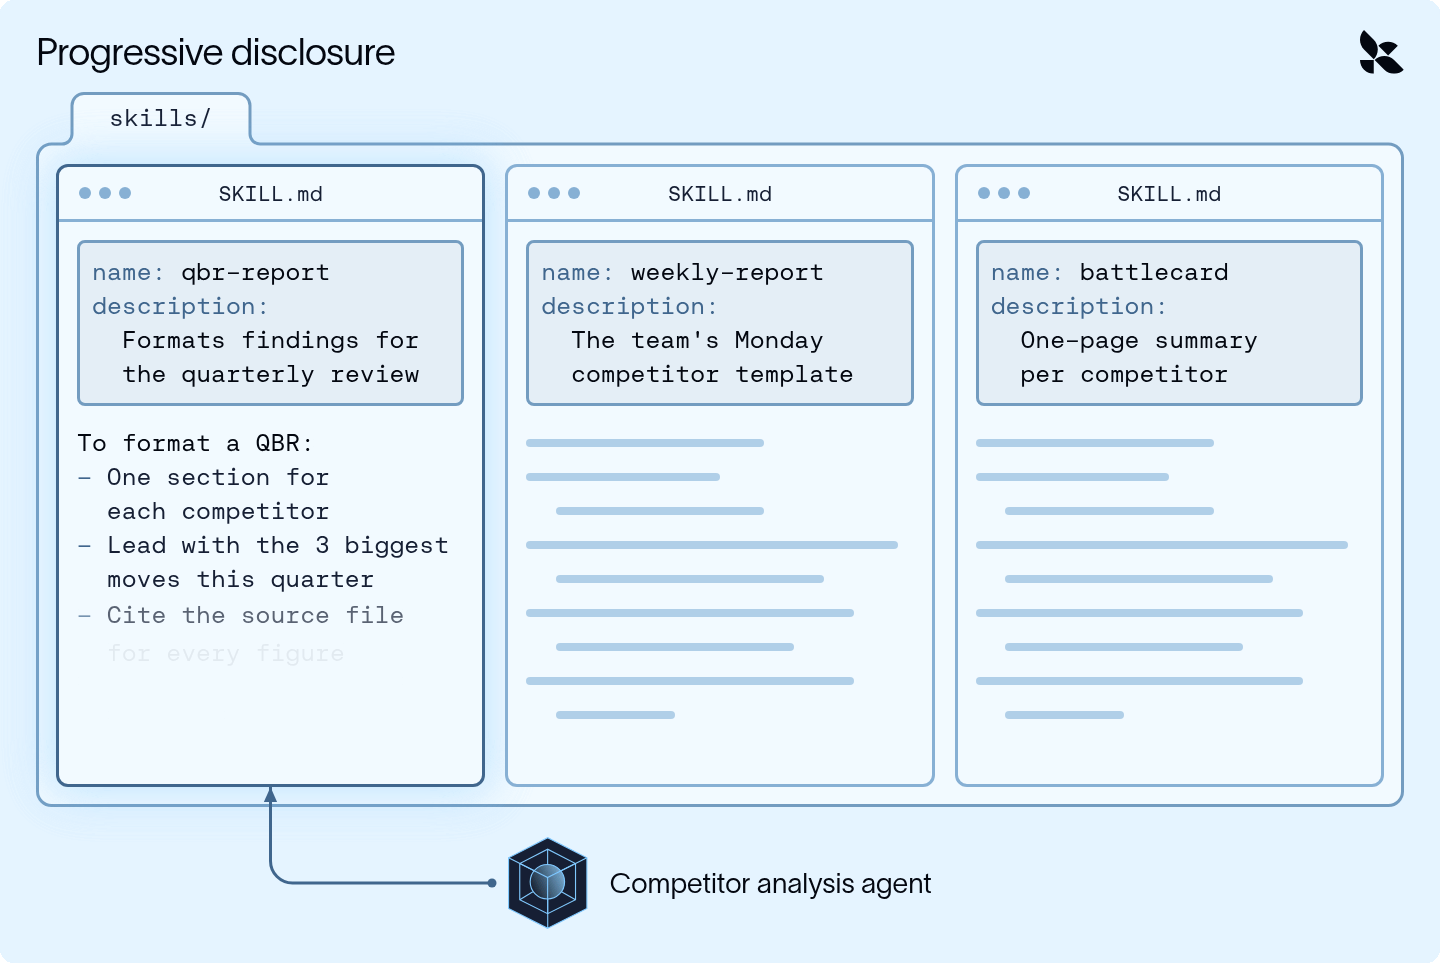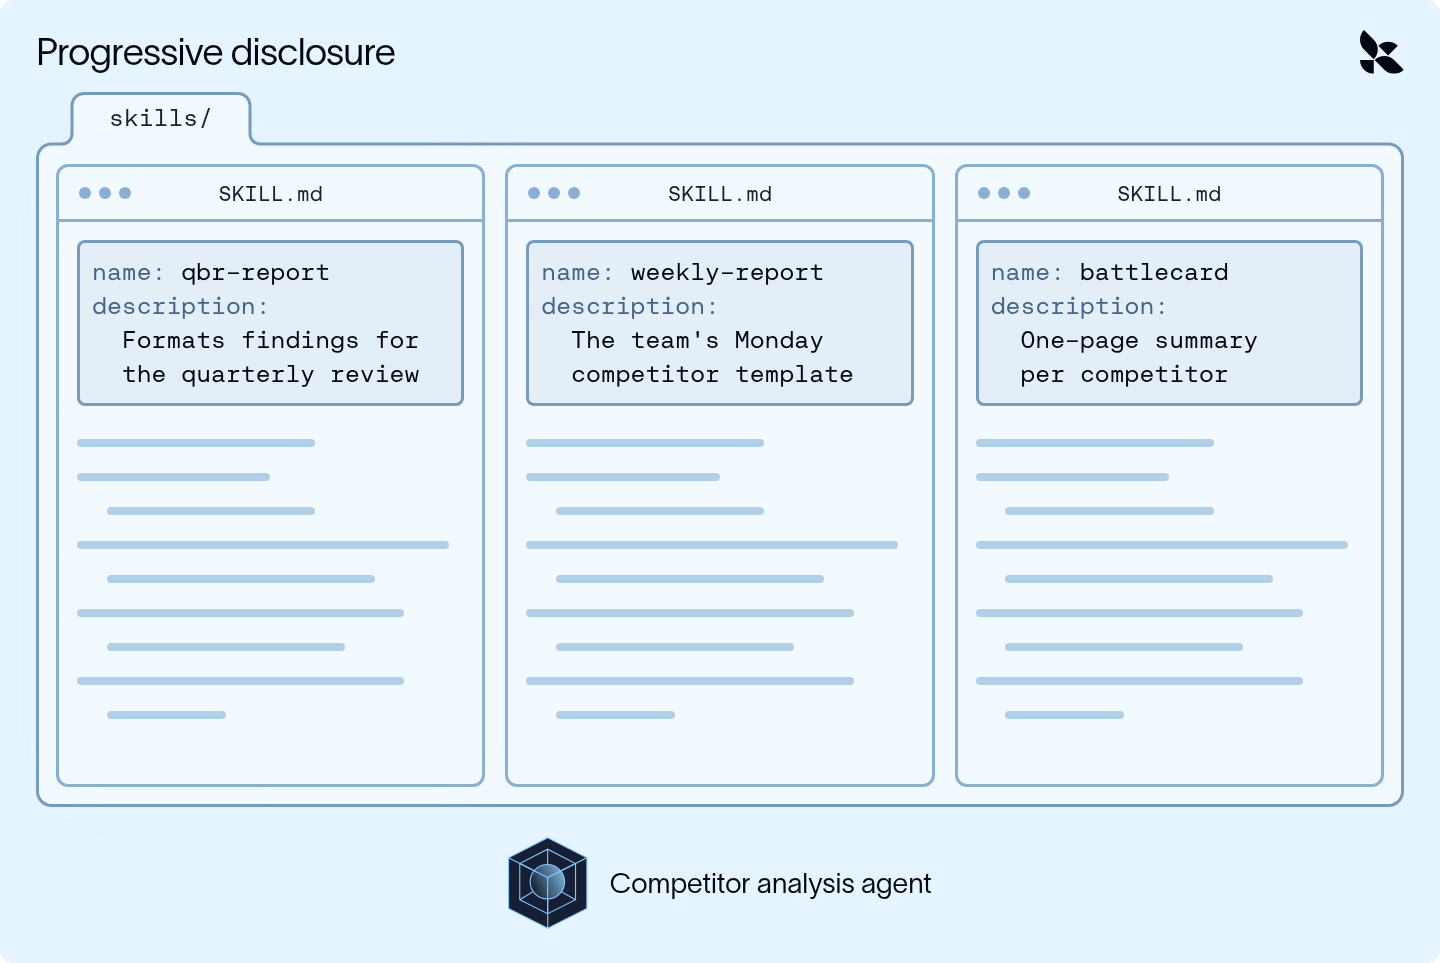
你把 agent 指向你的技能文件夹,SkillsMiddleware 会使用两个钩子:
- 在 agent 启动前,它扫描技能文件夹,只读取每个 SKILL.md 的头部信息。
- 在每次模型调用时,它把这些名称和描述加入系统提示词。
完整说明只有在模型判定某个技能相关时(并通过 read_file 工具读取它)才会进入上下文。因此我们的 agent 在没有模板的情况下开展研究,只在需要格式化 QBR 时才加载模板。