彭博社:OpenAI 完成 110 亿美元新一轮融资,这是其估值达 1.25 万亿美元的整体融资轮的首批款项。
投资人今天已完成打款,其余资金——总计最高可达 200 亿美元——预计将在数周内到账。
先选日期回看当天导读,再按主题筛。下面列表会跟到那一天。
一个训练AI帮自己做研究的模型,可能已经在今年7月越过了自家设的预警线。今天值得看的不止这条:视频模型把单条时长拉到15秒,还能边聊边改;另一边,有团队把世界模型塞进一台复古掌机,单张图就能实时跑。出门前提醒一句,真正会用电脑的AI,比你以为的还笨。
Google发布Gemini Omni 1.2 Flash,原生视频最长15秒,可用多轮对话改背景、光线和画幅。便宜的档位是360p每秒0.07美元,也支持升到4K;已陆续进Flow、Google Vids和Gemini。
METR拿到Anthropic内部数据访问权,测出模型自2025年10月以来提速约1.9倍,近八成加速来自AI用于自家研究。Anthropic把这类加速写成风险预警指标,如今可能已被触发;关键证据被删改过。
李飞飞团队World Labs放出研究预览Frameboy,把自回归世界模型Atlas装进复古掌机造型,输入一张图就能实时交互生成画面,大约每秒15帧。信息还少,但形态本身就是看点。
展开本期选读,查看 7 条精选新闻与编辑推荐
本期选读已读完 · 查看详细,返回资讯浏览
今日 AI 日报总结:根据当期推送内容整理,推荐优先关注的方向与热点。向下滚动左侧列表可浏览近半个月往期。
一个训练AI帮自己做研究的模型,可能已经在今年7月越过了自家设的预警线。今天值得看的不止这条:视频模型把单条时长拉到15秒,还能边聊边改;另一边,有团队把世界模型塞进一台复古掌机,单张图就能实时跑。出门前提醒一句,真正会用电脑的AI,比你以为的还笨。
点击左侧任意资讯,切换到具体文章阅读。
谷歌DeepMind推出了新一代视频生成模型Gemini Omni 1.2 Flash。据Arena.ai的评估,它在文生视频和图生视频两项里都排到第一。关注AI视频生成进展、想了解各家模型排名的人可以留意一下。
这次比较值得看的一点,是它在两项评测里都拿了第一,说明文生视频和图生视频两个方向的表现都受到了认可,而不只是单项突出。
另外,原文还提到价格和画质:360p视频每秒成本0.07美元,并且支持升级到4K。对成本敏感、又需要较高画质的创作者来说,这组信息值得重点看看。
OpenAI 已完成 110 亿美元新一轮融资,这是其估值达 1.25 万亿美元的整体融资轮的首批款项,投资人今天已完成打款。其余资金总计最高可达 200 亿美元,预计将在数周内到账。该消息由彭博社报道。
彭博社:OpenAI 完成 110 亿美元新一轮融资,这是其估值达 1.25 万亿美元的整体融资轮的首批款项。
投资人今天已完成打款,其余资金——总计最高可达 200 亿美元——预计将在数周内到账。
Google 发布视频模型 Gemini Omni 1.2 Flash,原生视频时长从 10 秒提升到最长 15 秒,支持多轮对话修改画面,可结合图片、最长 3 秒动作片段和音频引导生成,并能从 360p 或 720p 放大到 4K;720p 每秒 0.07 美元,比 Omni 1.1 降 30%。
YouTube 哔哩哔哩
#4#5#6#7#8#9#10#14#15#16#17#1Google 推出视频模型
Gemini Omni 1.2 Flash,原生视频时长从 10 秒提升至最长 15 秒,还能多轮对话修改画面。用户可结合图片、动作片段和音频引导生成,改善人物和场景的一致性;新模型也增强了对白、口型同步和镜头控制。模型正在陆续上线Flow、Google Vids 和Gemini等产品以及Gemini API。
正文
Google 推出 Gemini Omni 1.2 Flash 视频生成模型。模型原生生成和编辑视频的时长从上一代最长 10 秒 提升至 15 秒,用户可按秒设置时长,并通过多轮对话调整同一片段的背景、光线或画面比例。
用户还可以结合角色、产品或风格图片、最长 3 秒 的动作片段及音频提示引导生成;Google 称参考遵循更准确,人物和场景在镜头转换中更连贯。对白、口型同步、多说话人和连续镜头控制也有改善。
用户可先以 360p 或 720p 生成,再将成片放大至 1080p 或 4K;720p 视频价格为每秒 0.07 美元,较 Omni 1.1 下降 30%。
模型正陆续进入 Flow、Google Vids 和 Gemini 等产品,其中 Gemini App 正向 Google AI Ultra 订阅用户推出。Google 表示,快速体育动作、快速脚本变化和复杂物理效果仍需改进。
相关链接:
#2OpenAI 发布网络安全模型
GPT-6 Cyber,找漏洞能力更强,也更可靠地留在研究者设定的范围内。该模型已在 Firefox 和 Linux 内核中发现并验证数千个漏洞利用,目前向部分获批的 Daybreak Red 客户开放。
正文
OpenAI 发布网络安全模型 GPT-6 Cyber,称其在关键网络安全基准上较上一代 GPT-5.6 Cyber 明显提升:ExploitGym 得分从 32.1% 升至 48.5%;越界测试中,不使用部署安全提示时 99.93% 的测试守在任务范围内,加上提示后为 100%。
OpenAI 研究人员已用该模型发现 Firefox 中 81 个此前未知、被 Mozilla 评为高危的漏洞,并为 948 个 Linux 内核漏洞开发出可用利用。
基于评测结果,OpenAI 按 Preparedness Framework 将 GPT-6 Cyber 归类为网络安全 Critical 级,高于 GPT-5.6 Cyber 的 High 级。
模型目前通过 API 和 Codex 向部分获批的 Daybreak Red 客户开放,后续将逐步扩大到全部 Daybreak Red 客户。

相关链接:
#3蚂蚁百灵推出原生多模态模型
Ling-3.2-flash,总参数量为 560B,激活参数量为 25B。该模型支持文本、图像和视频输入,可用于复杂视觉理解、多模态 agent 协作和 3D 交互等任务。
正文
蚂蚁集团 百灵团队 推出原生多模态模型 Ling-3.2-flash,总参数量为 560B,激活参数量为 25B,支持 1M token 上下文及文本、图像和视频输入。
该模型面向复杂视觉理解、长时程多模态 agent、3D 理解与交互及医疗智能等场景。
官方称,该模型在 OmniDocBench1.5、ZEROBench(Sub) 和 Vision2Web 的发布评测中得分均高于 Claude Opus 5(max)。
目前模型可通过 API 平台使用,权重尚未在 Hugging Face 公开。

相关链接:
#4Thinking Machines 发布模型
Inkling 2 Small,在Artificial Analysis的智能指数上得 31 分,比前代高出 18 分。模型先以闭源形式在其Tinker平台提供微调和推理,该公司计划在外部安全测试完成后,于下周以Apache 2.0协议开放完整权重。
正文
Thinking Machines 发布第二代模型 Inkling 2 Small,在 Artificial Analysis Intelligence Index v5.0.1 上得分 31,较前代 Inkling Small 的 13 分提高 18 分。
该模型采用 MoE 架构,总参数 594B、激活参数 17B,支持图像输入和可变 effort。
模型当前以闭源形式上线,可在 Tinker Playground 试用,并在 Tinker 平台开放微调与推理,Artificial Analysis 给出的定价为每百万 token 输入 0.3 美元、输出 1 美元。
Thinking Machines 计划在外部安全测试和红队测试完成后,于下周以 Apache 2.0 协议发布完整权重。


相关链接:
#5百度发布
ERNIE-5.5-Flash-Base,开放预训练终点权重,供领域适配、指令微调等后续训练使用。该模型总参数 280B、激活参数 14B,基于 33.5T tokens 从零预训练,官方称经过后训练的ERNIE 5.5 Flash将随后推出。
正文
百度文心团队发布 ERNIE-5.5-Flash-Base,并开放预训练终点权重。该模型是总参数 280B、每 token 激活 14B 的稀疏 MoE 语言模型,在 33.5T tokens 上从零完成预训练,训练上下文最长 128K,微调与推理支持 1M tokens 上下文。
本次开放的 checkpoint 未经中训练与后训练,可作为领域适配、指令微调和强化学习研究的起点。权重已在 Hugging Face、ModelScope 提供 FP8 与 BF16 两个版本,支持 SGLang 与 vLLM 部署。
官方评测中,该模型在推理、代码等基准上表现突出,MMLU 得 93.3 分、HumanEval+ 得 82.3 分,经过后训练的 ERNIE 5.5 Flash 将随后推出。


相关链接:
#6中国科学技术大学团队发布开源 RNA 序列基础模型
structRFM,成果发表于《自然》。该模型用约 2100 万条序列与结构配对数据完成结构引导预训练,可预测 RNA 结构并推断功能,数据、模型权重和源代码均已开放。
正文
中国科学技术大学宣布,该校医学影像智能与机器人(MIRACLE)实验室周少华教授、熊鹏特任研究员团队发布开源 RNA 序列基础模型 structRFM,相关成果发表于《自然》。
研究团队构建了约 2100 万条经计算注释的序列与二级结构配对数据,用结构引导掩码语言建模策略同时学习序列上下文与结构依赖。预训练后的模型仅需输入序列,即可提取序列级、核苷酸级和核苷酸对级特征。
structRFM 支持 RNA 二级结构与三级结构预测,以及剪接位点预测、IRES 识别、非编码 RNA 分类等功能推断任务,并可借助滑动窗口策略处理最长 3000 nt 的长非编码 RNA。
目前,团队已开放完整配对数据、模型权重和源代码。

相关链接:
这篇讲的是有人用模拟出来的「假电脑」环境来训练AI学会操作电脑,还特意设计了一批高难度题目,结果连GPT-6 Astra都没能做对。关心AI智能体、AI学用电脑这类话题的读者可以看看。
最值得留意的一点是,题目难度高到连GPT-6 Astra都答不对,说明让AI真正会用电脑这件事,比想象中要难。
文章讲的不是空谈概念,而是训练方法和出题思路本身,想了解AI操作电脑进展到哪一步的人会比较感兴趣。
阮一峰在周刊中提到一篇文章,作者希望人类文明停在21世纪初,最佳是2003年左右、2007年6月29日iPhone发布之前。那时功能手机只能打电话、发短信、玩贪吃蛇和浏览简单网页,不够智能所以不易上瘾,社会主流仍是人与人的互动,上网只是可选,离线生活毫无问题。作者认为那是科技与现实生活的平衡点,如今生活已完全在线化。

作者:阮一峰
日期:2026年11月 6日
这里记录每周值得分享的科技内容,周五发布。
本杂志开源,欢迎投稿。另有《谁在招人》服务,发布程序员招聘信息。合作请邮件联系([email protected])。

雄安新区正在建设的雄安大剧院,它的幕墙采用 3D 打印装饰板拼贴而成,是世界最大的 3D 打印建筑幕墙。(via)
(1)
网上流行一道题目,大家应该都见过:“如果可以穿越,你愿意生活在哪个朝代?”
我觉得,这个题目有点侮辱智商,因为答案显而易见。正常人肯定只愿意生活在现代,而且越现代越好。
理由很简单,古人没有科技,生活之艰难,现代人难以想象,更不要说亲身体验了。我随便说几点:食物调料只有盐,其他调料很少,更没有糖;没有冰箱保存食物,只能腌制和烟熏来长期保存;晚上点油灯或柴火照明;平均寿命30多岁。这样的生活,你愿意过吗?
(2)
但是,前几天读到一篇文章,却让我陷入了沉思。
作者明确希望,回到21世纪开始的那几年,而且人类文明就停在那里,不要再向前发展了。
他认为,技术并不是越现代越好,而是需要与人类平衡。21世纪初才是科技与现实生活的完美平衡点,人类既能生活得足够轻松方便,又能有生活的主导权。
再往后发展,到了现在,技术完全占据了主导,控制了社会,人类反倒成了附庸,自主权几乎丧失。
(3)
具体来说,就是他想回到2007年6月29日之前,最佳时期是2003年左右。
那一天,苹果公司发布了 iPhone,标志人类进入智能手机时代。
在此之前,大部分人都用功能手机,那种手机有一些智能功能,但又不足够智能。

它可以打电话、发短信、玩贪吃蛇、浏览简单的网页,日常通信足够用了,但想用它做更多的事情就不行了。它的摄像头很烂,但拍出的照片也能看。
更重要的是,用这样的手机,你不会上瘾,不会每隔几十秒就忍不住低头滑一下屏幕。正因为它不那么智能,社会的主流依然是人与人的互动,而不是人与机器的互动,更不是机器与机器的互动。
那时,你想找人聊聊,就要打电话,而不是用聊天软件;想结识某人,就要去跟这个人见面,而不是访问他的社交媒体账户。
人类的生活还是实体的,而不是数字化的。科技的主要作用还依然是辅助真实世界,而不是建立线上的虚拟世界,开始取代真实世界。
(4)
那时,上网只是一种选择,你可以不上,完全离线的生活毫无问题。现在不行了,你已经不能离线了,人类的生活完全在线化了。
那时,世界还是实体的,聊天、约会、购物、娱乐、地图,都是一件件具体的事情或东西。现在,它们都是一款 App,不管你要做什么事,都需要先打开对应的 App。
以前,技术只是工具,不是生活方式。
(5)
人类的最佳生活时期,会不会就在刚刚过去的21世纪初:足够现代化,足够便利,但又不是那么现代化,那么便利。
你无需时刻接触科技,也能体验到科技带来的好处。大部分的生活没有被数字化,这意味着很多事情你通过互联网做不到,不得不亲自去做。
20年过去了,科技让一切变得更方便容易,提供更多可能性,我们回首才发现,曾经的生活是如此不同,缓慢生活和各种不便利,也有让人怀念的一面。
现在的科技永久改变了人类的生活方式,实体生活变得不那么重要了,大部分事情都转移到线上了。
尤其是 AI,创造了超越人类的智慧机器,让大多数人类技能都变得没有价值,但愿它能把我们带到一个更好的地方。
本周介绍一个开源的企业 AI 工作台 MonKeyAI(中文名“百智办公”),GitHub 已有5000颗星。
它可以私有化部署,所有员工通过它统一使用 AI,方便进行管理。

它允许指定模型,共享知识库、技能、MCP 等资源,所有数据保留在本地,并且提供强大的管理后台,进行权限管理和使用统计。
它本身提供一个单独的窗口,支持办公(处理文件、文档、表格、PPT 等)、编程、设计(平面设计、交互设计、短剧制作)三个核心场景,可以直接使用,不需要外部工具。

它提供各种客户端,包括 Web、iOS、安卓、Mac/Win/Linux,甚至还支持鸿蒙。服务器端也非常轻量化,仅需单核 CPU + 1G 内存的 Linux 服务器即可部署。
它免费使用,但如果团队超过10个人,则需要购买授权。
谷歌本周宣布,它的太空机房实验成功。

它在太空部署了4颗 TPU 芯片,预装了Gemma 4 模型。工程师向卫星发出提示词:
请以一块绕地球飞行的 TPU 的视角,写一首俳句。
卫星成功返回了结果:
蓝色星球在下方,数据静静流淌,星光滋养着我的核心。
但是,这个实验很可能表明“太空机房”不那么可行。
因为这颗实验卫星每小时只能发1度电,且受散热限制,TPU 每次只能连续工作大约20分钟,就要停机散热。
可以推算,即使卫星的太阳板增大100倍,每小时发100度电,也是远远不够用。
1、一光日的距离
美国的旅行者1号飞行器,将在2026年11月18日来到距离地球一光日的位置(即光在1天内的传播距离)。它是有史以来第一个达到这个距离的飞行器。

旅行者1号是1977年9月5日发射的。光需要走一天,它走了49年2个月零11天。
这个时间乘以365,约等于1.8万年,这就是它走过一光年所需要的时间。而距离太阳最近的恒星比邻星是4.24光年。
2、英国关闭固话
英国宣布将于明年1月关闭固定电话,也就是淘汰使用铜线的电话,只保留使用光纤或网线的数字电话。

中国早就把模拟电话网淘汰了,改用数字电话网。但是,光纤入户后,光猫依然提供电话接口(RJ11),把数字信号转成模拟信号传给电话。

英国这次就是要淘汰 RJ11 接口的电话,完全改用数字电话和无线通信。国内迟早也会这样做。
著名 IDE 厂商 JetBrains 2025年亏损,是该公司成立20年以来第一次亏损。

JetBrains 公司的主力产品 IntelliJ IDEA 是 Java/Kotlin 开发的利器,绝大部分使用 Java 语言的公司都在用。
这样的公司都亏损了,只有两种可能。一是 AI 编码盛行,传统 IDE 的需求变少了;二是 JetBrains 为 AI 投入巨资。不管是哪一种原因,都反映了传统 IDE 正在衰落。
4、语音年龄
有些人的声音,听起来比实际年龄苍老。英国科学家开发了一个相关 App,可以评估你的声音听起来像几岁。

根据他们的研究,如果你的“语音年龄”比实际年龄要老很多,往往预示你患阿尔茨海默病(老年痴呆症)的可能性较高。
因为控制语音的神经与阿尔茨海默病的神经,可能有相关性。所以,声音听上去年轻,其实象征着健康。
科学家称,他们的 App 是最简单便宜的阿尔茨海默病检查方法,下载后对着手机说一段话即可,很值得推广。
5、外链需要付费
Facebook 推出了一个离谱的规定:免费用户的发言,每个月最多只能包含两个外部链接,超过就需要开通付费会员。

这反映了,社媒平台越来越不愿意为外部网站引流,都希望把用户关在自己的平台里面。
大家考虑过吗,什么样的编程框架适合 AI 来使用?
有人做了这样的测试,让 AI 模型使用不同的 JS 框架完成同一个编程任务,然后统计了每个框架的使用成本。

成本指标包括:费用(上图)、耗时、消耗的 Token 等。
基本上,前三名都是一样的,只是名次会有变化:Hono + htmx、Astro、Nuxt。
有意思的是,所有比较的最后一名竟然都是同一个框架:Angular。

LaTex 排版软件的插件,在页面空白处生成植物图案。
这个概念很棒,而且可以移植到网页。


这个工具可以将指定的图片刻录到光碟上,使得图案在光碟表面上肉眼可见。
3、OutCrap

一个免费的手机 App(苹果和安卓),可以根据照片分析地质地貌,也可以根据 GPS 定位给出地质信息。
4、SOML
一种可以取代 JSON 的数据文件格式,消除了 JSON 的大多数缺点,更容易使用,基本上是 YAML 的简化版,提供各种语言的实现。
5、Casnode

开源的 Discourse 风格的论坛程序,采用 Go + Next.js 开发,数据库默认为 SQLite。(@hsluoyz 投稿)
6、澜姿

这个开源工具提供一套可以微调的人体姿态/服装/表情模板,供 AI 模型套用到图片上面。(@zc520pyfm 投稿)
7、Crossbow

开源的代理桌面客户端,支持双内核一键切换。(@Richard-Zhang1019 投稿)
微信读书全书无损导出工具,抓取微信读书 Web 端已购或会员书籍全文,一键导出为 PDF、EPUB 以及 Markdown 笔记。(@WANGXIN-567 投稿)
9、Linkit

浏览器书签的桌面管理器,基于 Go + Wails + SQLite 构建,支持本地语义向量检索、404 死链检测与知识图谱。(@blue-idea 投稿)
10、halfsize
开源的命令行工具,将视频文件压缩到指定大小。(@YKLovePython 投稿)

一个 Youtube 视频网站,汇集了“黑客新闻”论坛上提到的所有 Youtube 视频,可以用来寻找值得看的科技视频。
另有 HackerBooks 和 HackerPodcasts,分别收集了“黑客新闻”提到过的各种书籍和播客。(@qcrao 投稿)


2、开始学习图论(Start Doing Graph Theory)

一本面向初学者的图论入门教材(英文),免费阅读和下载。
3、Python 数据科学手册(英文)

该书向初学者介绍用于数据处理的一些 Python 基本工具(比如 NumPy、Pandas),出版于2016年,免费阅读。
1、挪威的最佳厕所
挪威政府为了推广观光,在网站上选出了该国的十佳厕所。
只看照片,你根本想不到这些地方是厕所。
19世纪60年代,德国医生卡尔·温德利希面临一个迫切的问题:发烧到底是一种疾病,还是一种症状?
他为此需要准确定义,什么是发烧。他就开始了一项雄心勃勃的计划,在15年的时间里,他定期收集25000名患者的腋下温度,最终获得了超过一百万条数据。

根据这些数据,他首先确定了,人体的正常体温是37摄氏度。我们今天的体温/发烧的概念,就是源于他的这项研究。
但是,最近的研究发现,人体的正常体温似乎在下降。比如,美国男性的体温比19世纪低了约0.59摄氏度,现在的正常体温似乎应该是36.39摄氏度。
对于这种现象,科学家给出了多种解释。
解释一:人类的整体健康状况大大改善。
以前的人往往有很多疾病,比如肺结核、牙病、痢疾、风湿热和骨髓炎。这导致人体的免疫系统一直在对抗这些疾病(也就是发炎),这会导致体温升高。
现在的人比较健康,炎症减少,所以体温下降了。
解释二:生活环境的温度变化。
当代人的室内生活比较舒适,往往有空调,温度变化小,所以不需要努力维持体温。如果身体不用费力调节体温,消耗的能量减少,释放的热量也就少了。
解释三:温德利希弄错了
19世纪的温度计不精确,有科学家认为,温德利希测量体温的温度计比现代温度计高出2摄氏度,加上他测量的是腋下温度,而不是如今更常用的口腔温度。这导致37度是一个高估的值。
除了这些解释,影响体温的还有四个因素。
(1)老年人体温较低。随着年龄增长,人体的新陈代谢减慢,身体活动减少,因此消耗的能量也更少,身体产生的热量也少。
(2)女性比男性体温高。目前,关于这点还没有可信的。
(3)清晨体温下降。体温在凌晨3点至5点之间下降,在下午4点至6点之间上升。这可能是因为白天活动量的增加。
(4)身高和体重成反比。体温会随着身高的增加而降低,因为体表面积越大,散热越多;而体温会随着体重的增加而略微升高。
1、
真心,正义,无畏,同情。
-- 电影《无问西东》
2、
民众在自己电脑上装内存,其实是一件很糟糕的事情。因为这些内存95%的时间都处于闲置状态,如果人们想要解决当前的内存供应问题,那就应该把内存都交给我们用在机房。
-- 山姆·奥特曼,OpenAI 公司首席执行官
3、
人们还没有充分认识到,既然电动汽车配备了大容量电池,为什么还要买个小电池仅仅为了应急?
电动汽车其实是家庭的备用电源。
4、
AI 生成的内容就像沥青,看起来光鲜明亮,而且很容易随处涂抹。但如果你以后需要清除沥青,即使一切顺利,也需要数年时间。
-- 《AI 帕斯卡的赌注》
5、
“说清楚你的需求”是21世纪的一项关键技能。
这篇是跟阿里千问算法负责人聊 Personal Agent 的对话,重点不在炫技,而在讲清楚它难在哪。如果你关心 AI 助手到底能不能真正帮上生活里的忙,或者好奇大厂做这类产品卡在什么地方,这篇值得看。
文章提到一个关键对比:代码领域有明确的反馈信号,对错好判;但生活服务场景没有“判卷标准”,好坏很难量化。这直接决定了做 Personal Agent 的难点和思路。
最值得看的一点是负责人的判断:Personal Agent 拼的是下限,生态才是最大壁垒。也就是说,决定体验的不是偶尔惊艳,而是稳定不出错,以及背后能接住多少服务。
想了解 Personal Agent 落地难点和竞争逻辑的读者,可以顺着这几个点去看原文。
METR发了一份调查报告,头一回把Anthropic内部怎么用AI来加速AI研发这件事讲清楚了,包括用的方式和程度。关心大模型研发进展、或者好奇AI公司内部到底怎么干活的人,应该会想看看。
报告里还提到一个没公开的神秘Claude模型,这点挺抓人。想知道头部实验室真实工作状态、而不只是看发布会的人,这篇值得一读。
最值得看的,是它没有停在概念层面,而是具体披露了内部用AI造AI的方式和程度,这在公开材料里不多见。
OpenAI、Google DeepMind 和 Meta 的多位核心研究者正纷纷出走创办自己的实验室。
 Maximilian Schreiner 查看 Maximilian Schreiner 的 LinkedIn 个人资料 2026年11月6日
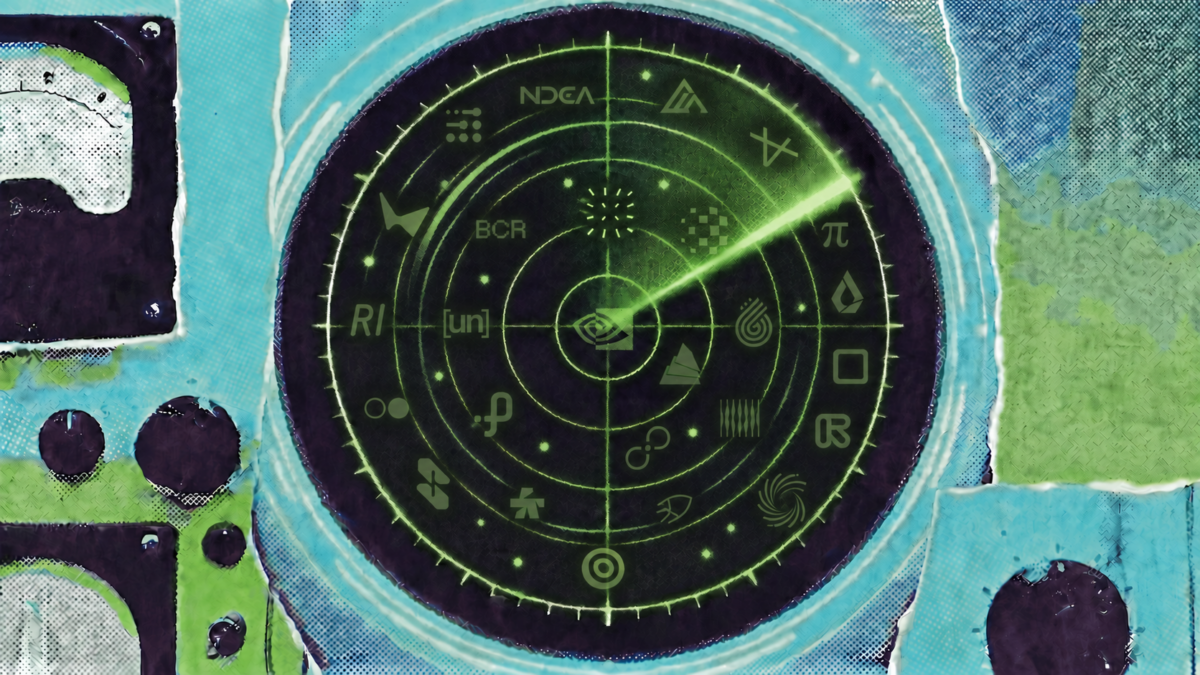
由 THE DECODER 提示生成的 Nano Banana Pro 图像
OpenAI 正在谈论 AGI 时代,英伟达 CEO 黄仁勋则表示 AGI 已经到来。与此同时,当今模型的联合创造者们却纷纷离开 OpenAI、Google DeepMind 和 Meta,去创办自己的实验室,在没有任何产品的情况下融资数十亿美元。为什么?他们押注的是:仅靠当前的配方还不够。我们按研究押注对 45 家新实验室进行了分类,梳理了它们试图克服的当今 AI 的局限,审视了它们工作中已经可见的成果,并解释了为什么英伟达总是赢家。
THE DECODER 编辑团队每年六次在「前沿雷达」系列中深入探讨一个基础性 AI 话题,以新闻简报形式发布,并独家提供给 THE DECODER 订阅者。第 5 期详细介绍了 27 家 AI 实验室,按六项研究押注分类,另有近 20 家简要提及,并附有涵盖起源、估值和公开可用成果的概览。第 1 期探讨了智能体 AI 的现状。第 2 期考察了 AI 对生产率的可衡量影响。第 3 期涵盖了生成式 AI 新兴的 token 经济。第 4 期则探讨了西方对中国的 AI 领先优势还剩下什么,以及欧洲处于什么位置。
亲爱的读者:
GPT-6 Astra 发布后,英伟达 CEO 黄仁勋在 X 上宣称:"AGI 已经到来。" OpenAI 总裁 Greg Brockman 称该模型是一个转折点,并欢迎人类进入"AGI 时代"。这两人究竟是什么意思并不清楚,因为 AGI 并没有公认的定义。但信息还是传达出来了:一个极其强大的 AI,可能是一个能自我改进的 AI,即将到来,而且路径已经规划好了。
许多构建当今系统的人显然看法不同。数十人离开大实验室去创办自己的公司。Ilya Sutskever 联合创办了 OpenAI 并担任其首席科学家;现在他正在打造 Safe Superintelligence。Jerry Tworek 领导了 OpenAI 推理模型的开发,现在经营 Core Automation。AlphaGo 背后的头脑 David Silver 离开 Google DeepMind,创办 Ineffable Intelligence。Yann LeCun 在 Meta 工作十二年后离开,创立了 AMI。Jeff Dean 在谷歌工作了 27 年,最近担任首席科学家,后来创办了 Discovery Loop。
资金随之而来:据彭博社报道,英伟达于 7 月向 SSI 投资,金额据称达五十亿美元。该实验室尚未发布任何模型或论文。Jeff Bezos 的工业 AI 实验室 Prometheus 于 6 月以410 亿美元估值融资 120 亿美元。Flapping Airplanes 同样没有公开模型,却在 10 月的 A 轮融资中筹得十亿美元。
动机是复杂的,并非全都是技术性的。在这样的估值下,创始人很快就能成为纸面上的亿万富翁。LeCun 是在与 Meta 发生战略分歧后离开的。Sutskever 想要在没有产品压力的情况下做研究。其他人则想开辟一个在大实验室里只会是边缘业务的细分领域。有些离职甚至不是彻底决裂:谷歌本身就是 Discovery Loop 的创始投资方。
许多创始人的共同点是一种怀疑。他们并不怀疑更强大的 AI 是否会到来;有些人认为 AGI 已近在咫尺。他们的怀疑在于:仅靠当前的配方是否就够了:越来越大的语言模型,在互联网数据上训练,再用强化学习进行精炼。
没有官方定义。我们用这个词来指独立创立、以研究为驱动的 AI 公司,它们围绕一项长期技术押注来构建业务。它们想要改变 AI 学习、感知世界、解决问题、被控制或进行计算的方式。
当前的这波浪潮在 2024 年变得明显。最强模型的竞赛正进行得如火如荼,云巨头也各有合作伙伴:微软支持 OpenAI,亚马逊支持 Anthropic。随后 Sutskever 于 6 月创立 SSI,并在几个月内为一个没有产品的研究团队融资十亿美元。
投资者资助这样的公司是有原因的。OpenAI 和 Anthropic 凭借成功成长为大型企业,两家都在以创纪录的估值推进 IPO。在内部,研究团队与产品团队争夺资金和注意力。成熟公司难以应对威胁其业务的想法,管理学者称之为"创新者的窘境"。这正是投资者所押注的:一个小团队能找到巨头们错过的东西。
有先例可循。Transformer 是 2017 年在谷歌发明的。DeepMind 用 AlphaGo 击败了世界上最优秀的围棋棋手。然而,面向大众的 AI 助手却来自 OpenAI——2015 年作为非营利组织成立。第二次突破来自 OpenAI 的分拆公司:Dario 和 Daniela Amodei 于 2021 年创立了 Anthropic。到 2026 年 7 月底,彭博社估计其年化收入超过 650 亿美元。
新实验室真正押注的是大玩家不去填补的研究空白,原因要么是没人知道路径,要么是没人为此分配资源。大实验室拥有更多算力、成熟的数据管道,以及来自数亿用户的反馈。一个小实验室构建的东西,可能在首个产品发布后不久就出现在市场领导者那里。
TypeSafe AI 说明了领先优势可以有多短。9 月中旬,它推出了决策模型 Jev。两周后,OpenAI 宣布了其Decisions API。但即便是短暂的领先也能展示专业能力,并可能作为退出途径带来回报。微软聘用了Inflection 的核心团队。谷歌挖走了Character.ai 的创始人和Windsurf 的领导层。AMD 想要以约 82 亿美元收购 World Labs。据《金融时报》报道,英伟达正与 Reflection 进行谈判。
对新实验室来说,一切都归结为一个问题:它们能否交付大玩家没有的东西,某种客户或大玩家自己愿意为之付费的东西?我们挑选了 27 家实验室,大多来自美国和欧洲,并按它们的主要押注分为六组。
当今的模型能做出非凡的事情,但它们的学习方式与人类不同。它们需要海量数据才能掌握一项技能,而且一旦部署,通常不会更新权重。它们可以在对话中利用新信息,但不会从每次经历中永久学习。持续学习仍然是一个核心研究空白。六家实验室想要改变这一点,并从三个角度攻克这个问题:在部署期间学习(Adaption、Core Automation)、从少量示例中学习(Flapping Airplanes、Ndea、SSI),以及从经验中学习(Ineffable)。
GitHub 博客文章讲述代码编写变快后周边工作的变化,介绍如何用 GitHub Copilot 规划、写码、审查改动与排查线上问题,并指出哪些仍需人工判断。
不好意思,一不小心出错了,没有抓取成功。
阅读原文把 Claude Code 变成一支虚拟工程团队:CEO 重想产品、工程经理定架构、设计师挑 AI 味、评审找线上 bug、QA 开真浏览器、安全官做审计、发布工程师出 PR。全是斜杠命令和 Markdown,MIT 免费。
适合想动手 ship 的技术型创始人、第一次用 Claude Code 的新手,以及需要给每个 PR 上严格评审、QA 和发布自动化的技术负责人。
AI 编程工作流 / 代码评审 / 自动化