Gemini 4 Hydrogen 专为速度与日常工作打造,目前已在 @GeminiApp 和搜索中上线🏃💨。
我们设计 Hydrogen,是为了让它能在各类智能体工作流中快速、高效地执行任务;在 Gemini 应用中,它也能帮你把日常助手变得 👏 更加 👏 好用 👏。
借助 Hydrogen,Gemini 能更严格地遵循你的指令、调用正确的工具,并减少来回沟通,更快给出可靠的结果。
滑动浏览完整说明 ↓



先选日期回看当天导读,再按主题筛。下面列表会跟到那一天。
今天最让人停一下的,是一个模型不需要再训练,就能重写自己的权重;另一个则能接管你的 Mac,在后台替你点菜单填表单。同一天里,还有数学家宣称和模型一起干了六周、写出上千万行代码,去碰那个一百多年没解的猜想。
arXiv 论文提出「自改写」:一个开放 27B 模型拿到自身权重和评分后,能诊断失败并改写权重,在没见过的问题上准确率提升 6.6 个百分点。更狠的是,它把受损副本在图像任务上的准确率恢复到原模型的 80% 以上,全程不重新训练。
谷歌给 Gemini Mac 应用加了 Computer Use 功能,只需描述目标,它就会跨本地文件、应用和网站点击输入、操作表单。所有动作在隔离的后台窗口里跑,屏幕和光标不受打扰,还能逐步观看、随时暂停。今天在美国以英语上线。
Anthropic 数学家 Levent Alpöge 称与 Claude 合作约六周、用 1700 万行代码找到黎曼猜想的证明,并称方法可推广到广义黎曼猜想。目前只是宣称,证明成立与否还要数学界检验,先当谈资别当定论。
展开本期选读,查看 7 条精选新闻与编辑推荐
本期选读已读完 · 查看详细,返回资讯浏览
今日 AI 日报总结:根据当期推送内容整理,推荐优先关注的方向与热点。向下滚动左侧列表可浏览近半个月往期。
今天最让人停一下的,是一个模型不需要再训练,就能重写自己的权重;另一个则能接管你的 Mac,在后台替你点菜单填表单。同一天里,还有数学家宣称和模型一起干了六周、写出上千万行代码,去碰那个一百多年没解的猜想。
点击左侧任意资讯,切换到具体文章阅读。
这篇讲的是Anthropic的一位数学家Levent Alpöge宣称,他和Claude合作了大约六周,用1700万行代码找到了黎曼猜想的证明,还说这个方法能推广到广义黎曼猜想。
关心数学、AI能力边界的人会想看,尤其是平时追黎曼猜想进展的读者。
最值得看的一点是工作量:六周、1700万行代码,这个规模本身就说明人机协作的方式和以往很不一样。
不过目前只是宣称,证明是否成立还需要数学界检验,读的时候别把“宣称”直接当成定论。
Google 发布 Gemini 4 Hydrogen,主打速度与日常工作,已在 GeminiApp 和搜索中上线。据 Google 介绍,该版本为在各类智能体工作流中快速、高效执行任务而设计,能更严格遵循用户指令、调用正确工具、减少来回沟通,从而更快给出可靠结果,也让 Gemini 应用中的日常助手更好用。
Gemini 4 Hydrogen 专为速度与日常工作打造,目前已在 @GeminiApp 和搜索中上线🏃💨。
我们设计 Hydrogen,是为了让它能在各类智能体工作流中快速、高效地执行任务;在 Gemini 应用中,它也能帮你把日常助手变得 👏 更加 👏 好用 👏。
借助 Hydrogen,Gemini 能更严格地遵循你的指令、调用正确的工具,并减少来回沟通,更快给出可靠的结果。
滑动浏览完整说明 ↓
谷歌为 Gemini Mac 应用新增“Computer Use”功能,用户只需描述目标,Gemini 就能跨本地文件、桌面应用和网站点击、输入并操作菜单和表单,完成多步骤任务。所有操作在隔离的后台窗口中运行,屏幕和光标保持可用;
用户可选择 Gemini 可访问的应用、实时观看每一步、随时暂停并提前批准关键操作。该功能今天在美国以英语推出。
谷歌现在允许 Gemini 在后台处理 Mac 任务。 Gemini Mac 应用新增的“Computer Use”(电脑操作)功能可跨本地文件、桌面应用和网站完成多步骤任务。据谷歌介绍,用户只需描述目标,Gemini 就会点击、输入并操作菜单和表单。所有操作都在一个隔离的后台窗口中运行,并配有实时聊天预览,从而让屏幕和光标保持空闲,不打断用户的工作。
用户可以选择 Gemini 能访问哪些应用,实时观看每一步操作,随时暂停,并提前批准关键操作。谷歌给出的示例包括批量编辑照片和 3D 场景、根据本地 PDF 填写发货表单,以及制作演示文稿。
Computer Use 今天在美国以英语推出,Gemini Mac 应用可在此下载。OpenAI 近期也聚焦Computer Use,并凭借其 Astra 模型明显领先。
首月 −50% 按月订阅 首月 4.99 美元,之后每月 9.99 美元。可随时取消。按月订阅
最超值 按年订阅 每月 8.25 美元,每年一次性支付 99 美元。按年订阅
已是订阅用户?登录
来源:谷歌
这篇聊的是 Anthropic 的 IPO 招股书里一个容易被忽略的细节:七位联合创始人在致投资人信里,把生物学和医学排在 AI 改变人类未来的第一位,而不是当下最赚钱的编程。
关心 AI 往哪走、或者关注 Anthropic 上市的人可以看看。公司还在湾区自建了分子生物学湿实验室,这个动作比嘴上说说更能说明态度。
最值得看的一点是,它押注的生命科学市场规模超过 2 万亿美元。招股书往往藏着公司真实优先级,这个信号值得留意。
arXiv 论文提出「自改写」(self-rewriting):语言模型无需梯度、无需训练,靠自身推理重写自己的权重。一个开放的 27B 模型在获得自身权重、带评分的作答结果和运行自身的能力后,能诊断失败并改写权重,在从未见过的问题上准确率提升 6.6 个百分点,连续八个会话中准确率只升不降。
arXiv:2611.21885(cs 分类) [2026 年 11 月 16 日提交(v1),2026 年 11 月 18 日最后修订(本版本为 v2)]
作者:Jiajun Fan、Neil He、Changyi Yang、Andy Mao、Xi Zhu、Chaoran Cheng、Kaiqu Liang、Shuaike Shen、Zetian Li、Ruihan Guo、Ge Liu
查看题为《语言模型能够重写自身权重》的论文 PDF,作者为 Jiajun Fan 及另外 10 位作者:查看 PDF HTML(实验性)
摘要:语言模型一次训练完成后便会被冻结。要让它变得更好,需要再进行一轮训练,或者借助提示词、运行框架(harness),或者依赖推理阶段额外的计算——这些手段在任务结束后便不复存在。我们展示了第三种方式:据我们所知,这是首次让语言模型通过自身推理重写自己的权重并变得更好,全程无需梯度、无需训练。我们称之为自改写(self-rewriting):模型本身就是自己的优化器。在早先的工作中,一个前沿模型编辑的是一个比它小得多的模型;而在这里,一个开放的 27B 模型在获得自身权重、带评分的作答结果以及运行自身的能力后,能够诊断自己的失败,并重写背后的权重。它超越了自己:它自己的编辑让它在从未见过的问题上准确率提升了 6.6 个百分点。它还在不断变好:它在练习题上测试自己的编辑,只提交有效的部分,每一次编辑都在上一次的基础上改进,在连续八个会话中其准确率只升不降。它能修复自己受损的副本,就像一台损坏的机器人无需重建即可自行修复:该副本几乎解不出任何问题,但在不重新训练、也从不读取原始权重的情况下,该模型将其在从未见过的图像任务上的准确率恢复到原模型的 80% 以上。而且这种能力随规模涌现:在同一个模型家族中,较小的模型要么做不出编辑,要么把自己弄坏,只有最大的模型能改进并修复自己。与测试时扩展(test-time scaling)不同,自改写把收益写入权重,每个答案都没有额外成本;与训练不同,它只运行前向传播,就像推理服务那样。训练与推理之间的墙是我们工具的限制,而不是智能本身的属性。我们相信,自改写是迈向递归自我改进的必要一步:一个像人类那样不把训练与推理分开的模型,可以终身自我升级,无需更大的模型、无需运行框架或提示词工程,也无需预训练或后训练。
| 主题: | 人工智能(cs.AI) |
|---|---|
| 引用格式: | arXiv:2611.21885 [cs.AI] |
| (或本版本使用 arXiv:2611.21885v2 [cs.AI]) | |
| https://doi.org/10.48550/arXiv.2611.21885 聚焦了解更多由 DataCite 签发的 arXiv DOI |
来自:Jiajun Fan [查看邮箱]
[v1] 2026 年 11 月 16 日星期一 20:55:08 UTC(6,363 KB)
[v2] 2026 年 11 月 18 日星期三 08:57:59 UTC(6,379 KB)
全文链接:
导出 BibTeX 引用 加载中……
× 加载中…… 数据提供方:
文献工具
文献浏览器开关 文献浏览器 (什么是文献浏览器?) Connected Papers 开关 Connected Papers (什么是 Connected Papers?) Litmaps 开关 Litmaps (什么是 Litmaps?) scite.ai 开关 scite 智能引用 (什么是智能引用?) 代码、数据与媒体
alphaXiv 开关 alphaXiv (什么是 alphaXiv?) 代码链接开关 CatalyzeX 论文代码查找器 (什么是 CatalyzeX?) DagsHub 开关 DagsHub (什么是 DagsHub?) GotitPub 开关 Gotit.pub (什么是 GotitPub?) Huggingface 开关 Hugging Face (什么是 Huggingface?) ScienceCast 开关 ScienceCast (什么是 ScienceCast?) 演示
Replicate 开关 Replicate (什么是 Replicate?) Spaces 开关 Hugging Face Spaces (什么是 Spaces?) Spaces 开关 TXYZ.AI (什么是 TXYZ.AI?) 相关论文
影响力之花链接 Influence Flower (什么是影响力之花?) CORE 推荐器开关 CORE 推荐器 (什么是 CORE?) 关于 arXivLabs
arXivLabs 是一个允许协作者在我们的网站上直接开发和分享新的 arXiv 功能的框架。
与 arXivLabs 合作的个人与组织都认同并接受了我们关于开放、社区、卓越和用户数据隐私的价值观。arXiv 致力于这些价值观,并且只与同样遵守这些价值观的伙伴合作。
你对能够为 arXiv 社区增值的项目有想法吗?进一步了解 arXivLabs。
本文哪些作者是背书人? | [禁用 MathJax](https://arxiv.org/abs/javascript:setMathjaxCookie())([什么是 MathJax?](https://info.arxiv.org/help/mathjax.html))
Thinking Machines 发布开放权重模型 Inkling 2 Mini,采用循环 Transformer 架构,每个 token 把中间层运行三次。
它是混合专家模型,总参数 26.4B、激活参数 3.4B,每 token 权重激活量 5.4B,内存占用约 20GB,可在笔记本本地离线运行。
今天,我们发布 Inkling 2 Mini,这是一款快速、强大且小到可以在笔记本电脑上运行的模型。
Inkling 2 Mini 是一种循环 Transformer(looped transformer),对每个 token 都会把模型的中间层运行三次。这让模型能够进行更多推理,并以更少的 token 得出正确答案,尤其是在依赖推理质量的智能体编程等任务上。在 DeepSWE v1.1(48.2%)和 Vals Index v2.2(46.5%)等基准测试中,Inkling 2 Mini 领先于所有总参数量低于 100B 的开放权重模型。它的运行速度也快于性能相近的模型。
DeepSWE v1.1
已解决任务(%)
已解决任务(%)
SWE-bench Pro v2 Hard(51 项任务)
已解决任务(%)
已解决任务(%)
Inkling 2 Mini 是一个混合专家(Mixture-of-Experts)模型,总参数量 26.4B,激活参数量 3.4B,考虑到循环,每个 token 的权重激活量为 5.4B。循环让模型能够在不把推理过程写下来的情况下进行更长时间的推理,这对监控很重要:监控指的是我们通过阅读模型的思维链(chain of thought,CoT)来监督和理解模型行为的能力。
我们使用 Inkling 2 Mini 以及随它一同发布的一个用于研究的可变循环(variable-loop)变体,测量了循环对性能和可监控性的影响。可变循环模型的无 CoT 时间跨度(no-CoT time horizon)从单次运行的 16 秒提升到三次运行的 37 秒,其在串行推理基准上的表现一直提升到十次循环——是它训练时所用循环次数的两倍。模型的思维链随着循环次数增加而变短,但始终保持可读。随着循环增加,模型在智能体破坏(agentic sabotage)测试上的表现并没有上升趋势。
我们很高兴能向研究者提供首批采用循环架构的模型。可变循环模型被用于我们的可监控性实验,因为它可以在不同循环深度之间进行更清晰的比较。
Inkling 2 Mini 的大部分权重都以 NVFP4 原生训练和部署,最后四层使用 MXFP8。Inkling 2 Mini 的总内存占用约为 20GB,因此可以在消费级笔记本电脑和桌面 AI 计算机等本地设备上运行。我们的研究人员带着 Inkling 2 Mini 上了一趟航班,它在一台 MacBook Pro 上离线运行,并在几分钟内构建了一个可玩的飞行模拟器。
演示产物 MacBook Pro(M5 Pro,48GB)飞行模式打开视频:PlaneBench 飞行模拟器演示,屏幕内嵌手机视频0:0015×正在加载 Inkling 2 Mini 构建的飞行模拟器……要试用该飞行模拟器,请在桌面端打开此页面。
Inkling 2 Mini 以开放权重形式发布,今天已在 Tinker 上提供,用于推理和定制。
Inkling 2 Mini 的优势与 Inkling 2 Small 一致:它最擅长长时程的智能体任务,在我们测量的多数任务上,是同尺寸开源权重模型中的最佳选择。
在 DeepSWE v1.1、SWE-bench Pro v2 等智能体编程基准上,Inkling 2 Mini 的得分领先于所有同类模型;在另一些基准上则仅次于 Qwen3.8-27B。在核函数优化基准 PMPP-Hard 上,它的成绩接近规模大得多的 Inkling 2 Small。
循环(looping)能提升模型的推理能力,但无法让权重存储更多事实——知识量主要取决于参数总量。Inkling 2 Mini 在事实性指标 AA-Omniscience 上的得分与同尺寸其他模型相当。通过研究可变循环模型,我们发现:长上下文基准(如 GraphWalks BFS 与 MRCR v2)的表现会随着循环次数增加而提升;但知识密集型基准(如 AA-Omniscience、SimpleQA Verified、SimpleVQA 和 WorldVQA)并不会因循环次数增加而改善。
Inkling 2 Mini 通过高效使用搜索与工具来弥补知识差距。在 BrowseComp、DeepSearchQA 和 MCP Atlas 上,它领先于同尺寸的开源权重模型;在结合搜索与工具使用的知识工作基准上也表现强劲。
| Inkling 2 Mini | Gemma 4 31B | Muse Glimmer | Qwen3.8-27B | Nemotron 3.5 Super VL | |
|---|---|---|---|---|---|
| 模型信息 | |||||
| 参数量(B)激活 / 总计 | 5.4/26.4 | 30.7/30.7 | 30.0/30.0 | 27.0/27.0 | 12.0/124.5 |
| 第三方指数 | |||||
| AA Index (v5.0) | 20.1(本行最佳报告得分) | 4.4 | 6.3 | 20.1(本行最佳报告得分) | 13.6 |
| Vals Index (v2.2) | 46.5%(本行最佳报告得分) | – | – | – | 29.8%(本行第二佳报告得分) |
| 编程与自动研究 | |||||
| FrontierCode v2.0(stirrup v0.2.1) | 15.1%(本行最佳报告得分) | 0.0% | 1.5% | 14.9%(本行第二佳报告得分) | 6.1% |
| DeepSWE v1.1(mini-swe-agent v2.4.6) | 48.2%(本行最佳报告得分) | 0.3% | 4.4% | 42.2%(本行第二佳报告得分) | 24.7% |
| Terminal Bench v4.0(mini-swe-agent v2.4.6) | 5.6%(本行最佳报告得分) | 0.0% | 0.5% | 5.6%(本行最佳报告得分) | 0.0% |
| Terminal Bench v2.1(pi v0.83.0 中的 Inkling 2 Mini) | 71.6%(本行第二佳报告得分) | 43.4% | 51.7% | 73.0%(本行最佳报告得分) | 60.7% |
| SWEBench Pro v2 (Hard)(mini-swe-agent v2.4.6) | 77.9%(本行最佳报告得分) | 14.2% | 44.3% | 73.8%(本行第二佳报告得分) | 44.1% |
| SWEBench Multilingual(Inkling 2 Mini,仅 bash) | 73.7%(本行最佳报告得分) | 43.0% | 66.9% | 70.0%(本行第二佳报告得分) | 67.7% |
| SWEBench Verified(仅 bash) | 79.2%(本行最佳报告得分) | 46.1% | 76.0% | 77.8%(本行第二佳报告得分) | 71.1% |
| Vibe Code Bench v1.1(openhands (vals)) | 77.9%(本行最佳报告得分) | – | – | 64.9%(本行第二佳报告得分) | 3.5% |
| PMPP-Hard(AUC,0–10h)(pi v0.83.0) | 455.82(本行最佳报告得分) | – | – | 262.50(本行第二佳报告得分) | – |
| 智能体搜索、工具使用与知识工作 | |||||
| BrowseComp(Inkling 2 Mini with compaction) | 79.0%(本行最佳报告得分) | 37.0% | 63.9% | 61.6% | 78.9%(本行第二佳报告得分) |
| DeepSearchQA(Inkling 2 Mini with compaction) | 85.3%(本行最佳报告得分) | 61.7% | 74.6% | 79.7%(本行第二佳报告得分) | 77.7% |
| MCP Atlas(Public) | 82.7%(本行最佳报告得分) | 54.2% | 75.5% | 77.3%(本行第二佳报告得分) | 67.7% |
| AA-Briefcase v1.1 | 1263(本行第二佳报告得分) | 369 | 478 | 1391(本行最佳报告得分) | 999 |
| GDPVal-AA v2.1 | 1319(本行第二佳报告得分) | 627 | 792 | 1427(本行最佳报告得分) | 1162 |
| JobBench | 49.6%(本行最佳报告得分) | 8.2% | 16.1% | 33.4% | 36.5%(本行第二佳报告得分) |
| AutomationBench-AA v1.0.6 | 41.8%(本行第二佳报告得分) | 4.9% | 6.8% | 48.2%(本行最佳报告得分) | 14.8% |
| EnterpriseOps-Gym | 42.0%(本行第二佳报告得分) | 28.4% | 34.7% | 44.2%(本行最佳报告得分) | 28.1% |
| Vals Finance Index | 50.1%(本行最佳报告得分) | – | – | – | 41.0%(本行第二佳报告得分) |
| AA-AnalystAgent | 46.3%(本行最佳报告得分) | – | 20.0%(本行第二佳报告得分) | – | – |
| Diligence Bench(Best harness) | 48.6%(本行最佳报告得分) | – | 40.9% | 46.4%(本行第二佳报告得分) | 45.0% |
| 视觉理解与创作 | |||||
| GDP.pdf | 16.8%(本行最佳报告得分) | 6.0% | 11.8% | 16.4%(本行第二佳报告得分) | 8.0% |
| PerceptionBench | 57.5%(本行最佳报告得分) | 40.7% | 42.8% | 52.4%(本行第二佳报告得分) | 36.8% |
| MMMU Pro(Standard 10) | 74.9%(本行第二佳报告得分) | 73.4% | 74.3% | 76.3%(本行最佳报告得分) | 72.3% |
| OmniDocBench v1.6 | 92.8%(本行最佳报告得分) | 82.5% | 90.4% | 91.5%(本行第二佳报告得分) | 77.9% |
| ScreenSpot Pro(原始 / 结合 Python) | 76.5/87.7%(本行最佳报告得分) | 5.9%/– | 75.4%/–(本行第二佳报告得分) | 57.6/78.9% | 43.5%/– |
| Chartography(原始 / 结合 Python) | 22.1/72.5%(本行最佳报告得分) | 12.0/11.8% | 17.4/25.1%(本行第二佳报告得分) | 12.2/52.1% | 9.7/29.3% |
| ZeroBench (main)(原始 / 结合 Python) | 17.0/34.0%(本行最佳报告得分) | 9.0/12.0% | 9.0/17.0% | 12.0%/–(本行第二佳报告得分) | 11.0/12.0% |
| MuirBench | 77.5%(本行第二佳报告得分) | 72.3% | 77.6%(本行最佳报告得分) | 65.9% | 72.7% |
| BVB | 68.4%(本行第二佳报告得分) | 47.0% | 50.5% | 70.7%(本行最佳报告得分) | 52.1% |
| 推理、知识与认识论 | |||||
| HLE-Diamond | 15.2%(本行第二佳报告得分) | 7.2% | 9.1% | 15.3%(本行最佳报告得分) | 8.8% |
| CritPt v2(Full / Hard) | 31.4/17.0%(本行最佳报告得分) | –/4.0% | –/7.0% | 10.6/4.0% | 36.9/13.5%(本行第二佳报告得分) |
| Apex 2025 | 34.4%(本行最佳报告得分) | 5.2% | 4.2% | 18.8% | 22.9%(本行第二佳报告得分) |
| ARC-AGI(v1 / v2) | 84.5/49.3%(本行最佳报告得分) | – | – | 87.5/42.4%(本行第二佳报告得分) | 22.7/1.5% |
| LongBench v2 | 66.9%(本行最佳报告得分) | 52.9% | 33.1% | 52.3% | 62.1%(本行第二佳报告得分) |
| GraphWalks BFS(256K) | … |
正文超过 1 万字上限,本页为节选 · 查看原文
Hugging Face 布道师 Alejandro AO 在年度回顾中称,2026 年是他最分心的一年,因为他常同时用四到十个 Agent 推进三四个项目,每天消耗数百万 Token,仍有项目被搁置。
他反思 AI 虽让事情变简单,却不会让时间变多,小项目往往耗时超出预期,目标应是做成最重要的事,而非做很多事,并希望 2027 年专注于一两个核心项目。
作者:阮一峰
日期:2026年11月20日
这里记录每周值得分享的科技内容,周五发布。
本杂志开源,欢迎投稿。另有《谁在招人》服务,发布程序员招聘信息。合作请邮件联系([email protected])。
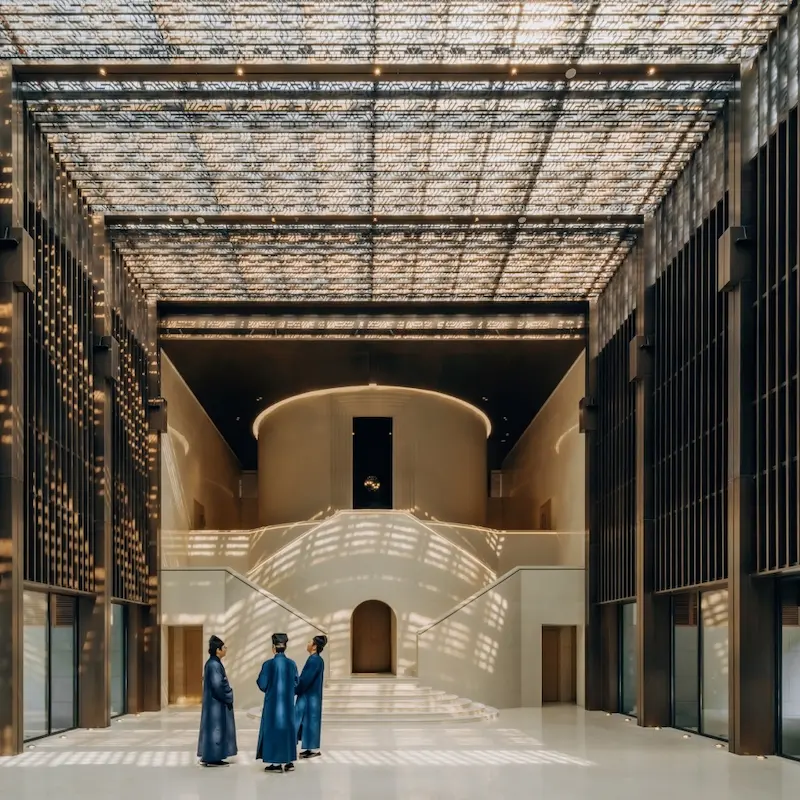
新建成的上海道教学院,由清华大学建筑设计研究院设计。(via)


法国开发者亚历杭德罗·奥(Alejandro AO),是世界最大的大模型社区 Hugging Face 的布道师。

他做了很多视频,向初学者科普 AI 知识,都放在他的 Youtube 频道。

他的内容以实操为主,也会涉及一些原理,容易看懂。我很推荐,我的很多 AI 知识就来自这里。
本周,他发布了一篇年度回顾,总结自己在 Hugging Face 的这一年。

引起我共鸣的是下面这段话。
他说,2026年是他最分心的一年。“今年几乎不可能专注于一件事。同时进行多个项目,比以往任何时候都更容易。大多数时候,我手下有四到十个 Agent 同时推进三四个不同的项目。”
大家有没有同感?
AI 让你可以同时做几件事,越来越难专注于某一件事。
“我每天消耗数百万 Token,尽力做好不同的项目。即使如此,仍然有一些项目被我搁置了。”
他感到,这样是不对的。任何一个项目如果要做到优秀,都需要投入大量时间和心力打磨。分心的直接后果,就是看上去虽然成果不少,但因为时间要分给不同的项目,结果就是每个项目都浅尝辄止,做不深入。
“我们很容易忘记,即使有 AI 编写代码,打造一个可靠的产品也绝非易事。因此,我经常会启动一些看似唾手可得的‘小’项目,但这却意味着我推迟了那些我真正想做的、更有意义的项目。而这些小项目最终耗费的时间比预期要多得多。”
AI 让人产生一种错觉,觉得只要稍微花一点点时间,构思一下提示词,就能拿到结果。于是,你就抵不住诱惑,只要脑子里蹦出的点子,都忍不住让 AI 去实现,从而将注意力从那些高优先级、急迫而重要的事情上移开。
更糟糕的是,那些你以为最多只需要一个小时的小项目,结果不断膨胀,吞噬了比预想多得多的时间。
正确的做法是,永远不要忘记,AI 可以让事情变得简单,但不会让时间变多。你每天的时间永远只有24个小时,并行的事情越多,就意味着每件事分到的时间就越少,就做不到把足够的时间花在最重要的事情上面。
你的目标不是去做很多事情,而是做成最重要的事情。
AI 越发达,每件事看上去越容易推进,就越需要我们抵制住诱惑。你要始终划分事件的优先级,筛选掉那些低优先级的事情,让工作范围更聚焦。始终把最多的时间和精力,放在最重要的事情上面。
亚历杭德罗·奥最后许愿,希望2027年不再那么分心,更专注于自己那一两个核心项目。
这也是我对自己的愿望,与其做加法(用 AI 做更多的事情),不如做减法(减少项目数量),借助 AI 把最重要的项目做得更大、更广、更深入。
《GTA5》是史上最畅销的 3A 游戏,卖出了2亿多份。它的续作《GTA6》在本周发售。

目前总体上,这个游戏好评如潮,许多玩家都对游戏的写实主义感到震惊。它栩栩如生还原了一个虚拟的充满犯罪的美国大都市(迈阿密)。
不仅街景逼真,而且各种情节也很接近现实。
一个玩家讲述了自己遇到的情节。
他正在街上开车兜风,看到前面发生了一起交通事故,一辆轿车被卡车从后面撞上。
他赶紧下车查看,卡车司机已经逃之夭夭,轿车司机被困在车里。轿车引擎已经起火了,形势危在旦夕。他将轿车司机从车里拉了出来,后者向他表示感谢,惊恐地说自己差点丧命。
这时,两人发现,肇事的卡车属于商业巨头撒哈拉公司(影射亚马逊公司)。轿车司机立刻说,这是他的机会!他可以起诉撒哈拉,索赔数百万美元。
但是,他需要确凿的身体受伤证明。于是他深吸一口气,回到车里,让火焰烧着了自己的裤子,然后带着烧伤走了出来。
他给律师打了电话。接着,救护车驶近时,他转过身来,请求那位玩家做他的证人,作为交换,他会给玩家一部分赔偿金。
玩家当时想过要不要向他勒索更多的金额,但最终还是答应帮忙。轿车司机就通过游戏里的货币,给玩家转了几千美元。
这个游戏就是设定这样的情节。
1、美国北卡罗来纳州的两个男子突发奇想,将两部电动滑板车绑在一起,然后把家里的沙发固定在滑板车上,变成了一辆沙发车。

他们就坐在沙发上,操作着滑板车的把手,上街闲逛。毫不意外,很快就被警察拦下了。
这件事报道后,引起了轰动。警察局接受采访,解释了为什么沙发车不能上街。首先,它不安全;其次,其他司机看到它会分心,导致危险驾驶。
2、科学家在西班牙发了一具梁龙化石,人们以前一直认为这种恐龙只生活在北美洲。

这表明,至少在这头恐龙生活的时代(1.5亿年前),西欧和北美之间是有陆地通道的,大西洋是后来形成的。
3、为什么黑猩猩没有进化成人?最新一项研究,提出了一种可能的原因。

研究发现,700万年前出现了一种病毒,影响了黑猩猩的大脑发育,使其无法进化出智能,而人类对这种病毒免疫。
这给人的感觉是,好险啊。要是这个病毒再高明一点,把人类也感染了,那岂不是就没有人类社会了。
1、黄仁勋事件的深层分析(英文)
一位美国分析师对黄仁勋事件的长篇分析,写得非常深入,值得一读。
2、多智能体系统的三种模式(英文)

如果你同时使用多个 AI 代理,本文认为有三种使用模式:(1)管道式(做完一步移交给下一步),(2)编排式(通过编排器来指挥),(3)白板式(每个 AI 自己阅读白板信息,自由行动)。
3、检查空格有多难?(英文)

空白字符在 Unicode 有多种表示方法,本文介绍在 Python、Java、JavaScript 里面想要过滤所有空白字符要怎么做。
4、闭源模型占据了主导地位(英文)

自从美国的模型公司对低端模型降价以后,几乎在每个价位上,都是闭源模型提供更好的性能。
5、个人如何定制芯片(英文)

本文介绍,美国出现了一个网站 wafer.space,可以接受个人的芯片订单,帮你生产出来(流片)。它的最小订购量是1000片,每片最低价格2美元。
6、AI 芯片的位置验证(英文)

为了阻止中国获得先进芯片,美国打算立法要求芯片制造商加入定位功能,可以看到芯片在哪里使用,但是这个功能需要操作系统配合。
1、sgrep

grep 的替代品,返回语义搜索的结果。
2、Netdata

开源仪表板,在一个地方显示所有服务器和服务的状态。

macOS 的瀑布式图像浏览器。
4、13ft

一个开源网站,可以抓取付费墙后面的网页内容,需要自搭建。

一个操作系统的启动盘,把 Windows、Linux、BSD 的安装文件都做在一个启动盘里面。
6、Srcbook

类似于 Jupyter Notebook 的网页互动式笔记本,但是适用于 TypeScript 和 JavaScript。

开源的基于浏览器的图片编辑器。(@Abraham721 投稿)

一个纯静态的网页应用,采用表格形式可视化编辑 XML / KML / JSON / YAML 文件。(@lizhaowu-79 投稿)
9、GCS
谷歌云的非官方命令行客户端,可以从命令行登录谷歌云的主机,进行各种操作。(@aeroxy 投稿)
10、Waytrace(漫迹)

开源的 iOS 应用,不需要手动操作,在后台全天记录你当天的足迹动向。(@lxyeternal 投稿)
11、Tomoru

跨平台桌面应用,捕获电脑或指定应用播放的声音,实时识别,并在屏幕上显示双语悬浮字幕。(@ACAne0320 投稿)
12、crFiles

跨平台的桌面文件管理器,最大特色是内置 Android Quick Share 协议,方便跟 Android 设备交换文件。(@wuruxu 投稿)
13、Arke

开源的 Windows 资源管理器替代品,特色是读取、排序、缩略图、搜索都不在界面线程上,因此打开巨大文件夹或网络共享断线,都不会卡住窗口。(@Koimsurai 投稿)
1、周刊导航站

网友做的周刊导航,共收入17,382个条目,可以检索。(@mwhzwh 投稿)
从零开始做一个中文为主的小模型,包括数据清洗、分词器、模型、预训练、SFT、蒸馏、强化学习,每一步的代码都用 PyTorch 写出来。(@cai114514114514 投稿)

浏览器里的 Lean 4 语言练习环境,自带中英双语的入门课,从基础逻辑一直讲到归纳、素数和插入排序验证。(@3y3y3y-huaiji 投稿)
4、浏览器工程(Web Browser Engineering)

免费阅读下载的英文电子书,介绍网络浏览器的工作原理,演示几千行 Python 代码构建一个简单的网络浏览器。
5、生成式 AI 基础数学入门(英文)

免费下载的 AI 数学入门教程。
1、火星钻孔
美国的好奇号火星探测车,一直在火星上钻孔取样,分析火星岩石的成分。
这些孔的直径约为1.6厘米。下面就是其中49个孔合在一起的照片。

2、不会重复的骰子
传统的骰子往往会掷出重复的数字。

怎样才能使得每次掷出的数字,总是不一样?一位美国数学家发明了一种新型骰子。
这种骰子一套有五个,每个有24面,一共包含120个不同的数字。

每个骰子掷出与上一次相同数字的概率,为1/24,那么连续5个骰子都与上一次相同,几乎是不可能的。
所以,使用这套骰子,每次得到的结果(几乎)总是不一样的。

正文超过 1 万字上限,本页为节选 · 查看原文
这篇是姚顺雨在清华姚班闭门对谈的内容整理,围绕大模型技术路线、商业化落地和个人选择,讲了他对行业的十点底层认知。关心大模型走向的从业者、创业者和学生都值得看看。
最抓人的一点是他直接点出了汇报压力和刷榜的问题,说 Eval 最后会变成敌人,这种话在公开场合不太听得到。想了解一线技术负责人怎么看行业真实的坑,这篇可以翻翻。
Claude Code 团队在 10 月发布的内部实践分享中介绍了他们现行的代码审查方式,作者为 Addy Osmani、Morgan Westlee Lunt 和 Qing Wang。团队采用分层检查后,合并的 PR 数量翻倍,回滚率下降超过 40%。
材料还提到团队此前说过 Claude Code 自身代码的规模情况,但原文此处内容不完整。
人物
(原文正文仅有“## People”这一小节标题,未包含更多内容。按照整理要求,现以简体中文保留该标题。由于原文没有其他章节、段落、列表、链接、配图或代码块,无法进一步整理或翻译。若后续补充完整正文,可按原有顺序逐节翻译并保留 Markdown 结构与配图占位。)
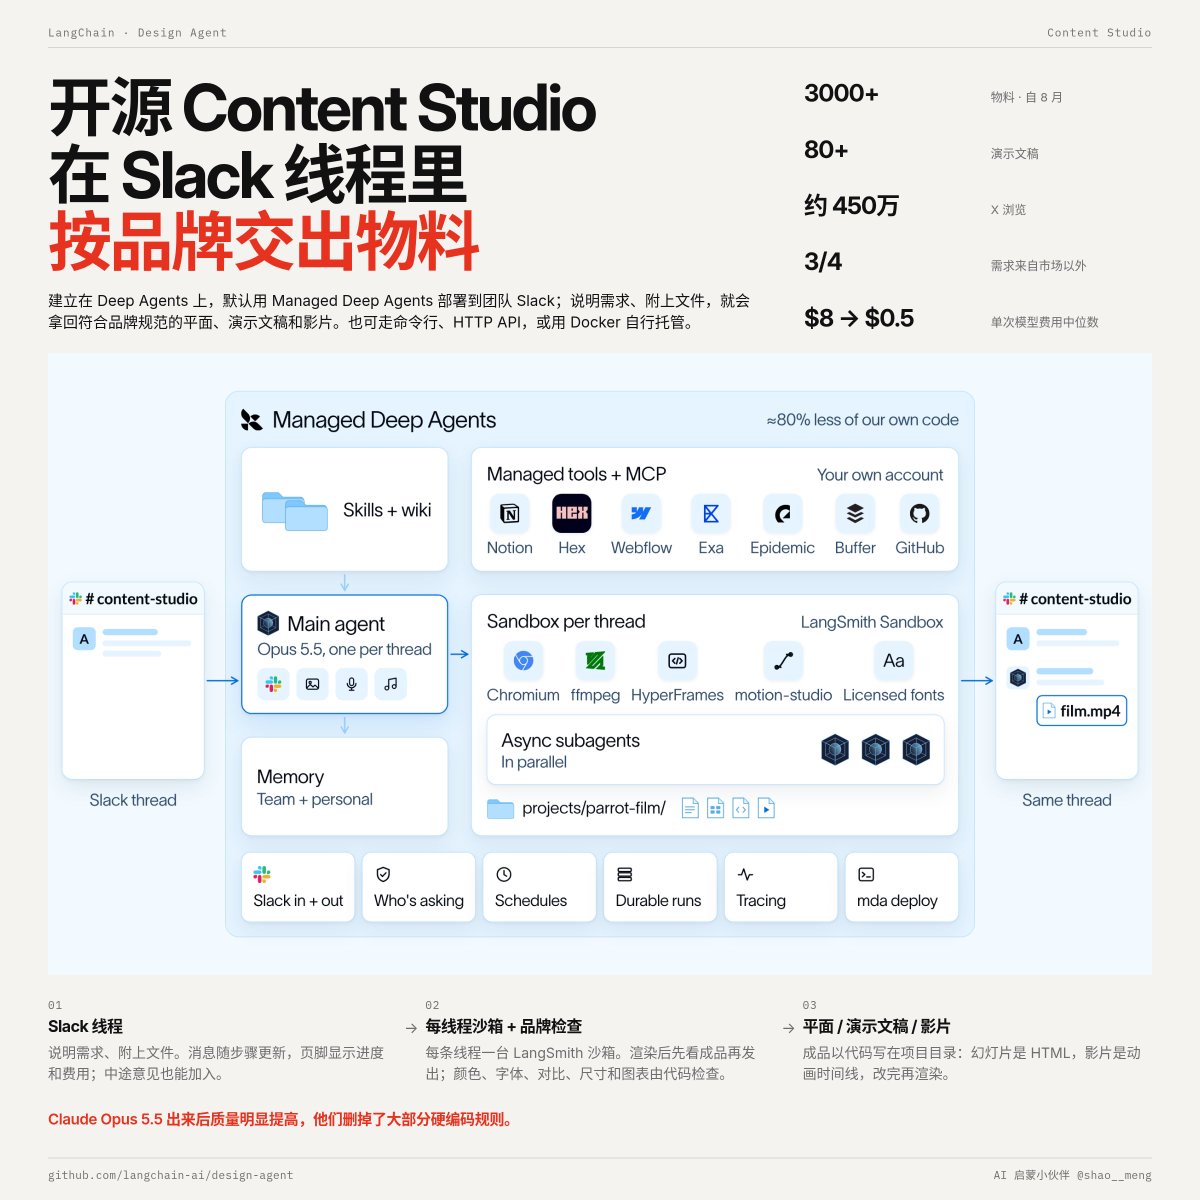
LangChain 把公司内部在用的 Design Agent「Content Studio」开源,它基于 Deep Agents 构建,默认可部署到团队 Slack,在线程里说明需求并附上文件,就能拿回符合品牌规范的平面、多尺寸广告、演示文稿、图表、分镜和影片,也支持命令行、HTTP API 或 Docker 自托管。
LangChain 开源 Design Agent,把公司在用的 Content Studio 公开,用每线程沙箱和品牌检查在 Slack 交出平面、演示文稿和影片
@LangChain 把公司内部在用的 Design Agent「Content Studio」开源。它建立在 Deep Agents 上,默认用 Managed Deep Agents 部署到团队 Slack:在线程里说明需求、附上文件,就会拿回符合品牌规范的平面、多尺寸广告、演示文稿、图表、分镜和影片。也可以用命令行、HTTP API,或自己用 Docker 托管。自 8 月起它已为公司交出 3000 多件物料,演示文稿超过 80 份;带这些视觉的帖文在 X 上大约有 450 万次浏览。四分之三的需求来自市场部门以外。单次请求的模型费用中位数大约是 0.5 美元,9 月中旬还大约是 8 美元。
开源地址:
一条 Slack 线程、一台设计用电脑
Managed Deep Agents 负责 Slack、记忆、定时任务,以及每条线程一台 LangSmith 沙箱;仓库补上设计工作流、品牌包和渲染工具。沙箱是一台 Linux 机器,里面有 Chrome、FFmpeg、HeyGen 的 HyperFrames、D2 和团队字体,由 sandbox/setup.sh 搭起来。成品都以代码写在项目目录里:幻灯片是 HTML,影片是动画时间线,改完再渲染即可。密钥不进沙箱,默认也没有外网;图像、语音、音乐在沙箱外调用,Notion、GitHub、Figma 一类 MCP 经 MDA 接入,每个人用自己的账号登录。
一条 Slack 消息会随步骤更新,页脚显示进度和目前费用,中途补的意见也能进正在进行的工作。大任务由主 Agent 拆开,在同一沙箱里后台启动子 Agent;做完、失败或卡住时,MDA 会叫醒主 Agent,它不用空等,还可以继续对话。影片按分镜、动态预演、正式制作推进,每一段先过检查再组装。HyperFrames 把影片当成时间线上的网页来做,Paper 是可以改分镜或版式的共享画布。
技能路由、品牌检查,以及它怎么变好
常驻提示很短。每次请求先读路由技能,再从 35 项技能里选出对应流程,由 Context Hub 按需加载。设计维基里是字体、色彩、版式、图表这类手艺,品牌包里是颜色、字体、标志和语气。渲染之后会先看成品再发出;颜色、字体、对比、尺寸和图表计算由代码在每次渲染时检查。规则可以说一次就记下,分成全员共享的团队记忆和每人一份的个人记忆。任务结束后,learn_from_job 按所用技能记下有依据的经验,后续任务会阅读并评分,站不住的会被丢掉。
他们写到,早期为了补模型短板做过 115 个可复用界面组件;Claude Opus 5.5 出来后质量明显提高,他们删掉了大部分硬编码规则,留下设计原则和高层指引。默认模型就是 Claude Opus 5.5,也支持 OpenAI、Google 和 LangSmith Gateway。Managed Deep Agents 在 LangSmith Cloud 上仍是公开测试;代码免费,模型和托管要另付。本地可以用脚本化模型、不配密钥跑演示,走真实的 Agent 图、沙箱和检查。
Harrison Chase@hwchase17
趣闻:
(原文正文仅此一行,无更多章节与要点可整理。)
在我们筹备发布之际,我们让内容 agent 尝试制作了一支发布视频。
我们最终没有用上它——但它确实非常出色,我们完全可以用上的!附在下面
这个智能体(agent)同样开源!