由 THE DECODER 提示 Nano Banana Pro 生成
AI 智能体越来越依赖复杂的训练流水线。TikTok 母公司字节跳动的一个团队与多所美国大学的研究者希望证明:三步就够了。
人们期望 AI 模型能够自行检索网络、运行代码并解决多步骤任务。根据一篇新论文,支撑这些能力的训练方法正变得越来越层层嵌套,许多开发者一个接一个地堆叠大量训练阶段。论文指出,现在已经几乎无法判断哪一步真正有用,而复现这些工作也正变得昂贵。
先选日期回看当天导读,再按主题筛。下面列表会跟到那一天。
今天最扎眼的是数字:纳斯达克100一周跌了10.4%,创疫情以来最差单周。另一边,字节说训练AI绕了一大圈、其实三步就够,还开源了个模型当证据。有人开始给AI算力降温,也有人盯着更玄的——一位数学家说他和Claude搞出了黎曼猜想的证明。
字节跳动团队与多所美国大学研究者发论文称,现在的训练流水线层层堆叠,已经说不清哪一步真有用。他们提出三步流程足够,并开源了一个有竞争力的模型作为佐证。
OmniRoute 采用 MIT 许可,用一个端点聚合375家厂商、1400多个模型,其中150多家厂商免费,兼容 Claude Code、Cursor 等工具,还能自动回退和压缩 token。对想省调用成本的人是现成基础设施。
数学家 Levent Alpöge 称与 Claude 合作发现黎曼猜想的证明,方法可推广到广义黎曼猜想,证明稿超过25万页,目前只放出 Lean 形式化代码,尚未获独立验证。
展开本期选读,查看 7 条精选新闻与编辑推荐
本期选读已读完 · 查看详细,返回资讯浏览
今日 AI 日报总结:根据当期推送内容整理,推荐优先关注的方向与热点。向下滚动左侧列表可浏览近半个月往期。
今天最扎眼的是数字:纳斯达克100一周跌了10.4%,创疫情以来最差单周。另一边,字节说训练AI绕了一大圈、其实三步就够,还开源了个模型当证据。有人开始给AI算力降温,也有人盯着更玄的——一位数学家说他和Claude搞出了黎曼猜想的证明。
点击左侧任意资讯,切换到具体文章阅读。
字节跳动团队与美国多所大学研究者在一篇新论文中提出,多数AI训练阶段并非必要,三步流程就足够,并开源了一个具备竞争力的模型作为佐证。论文指出,当前开发者层层堆叠大量训练阶段,已几乎无法判断哪一步真正有用,复现这些工作的成本也在上升。
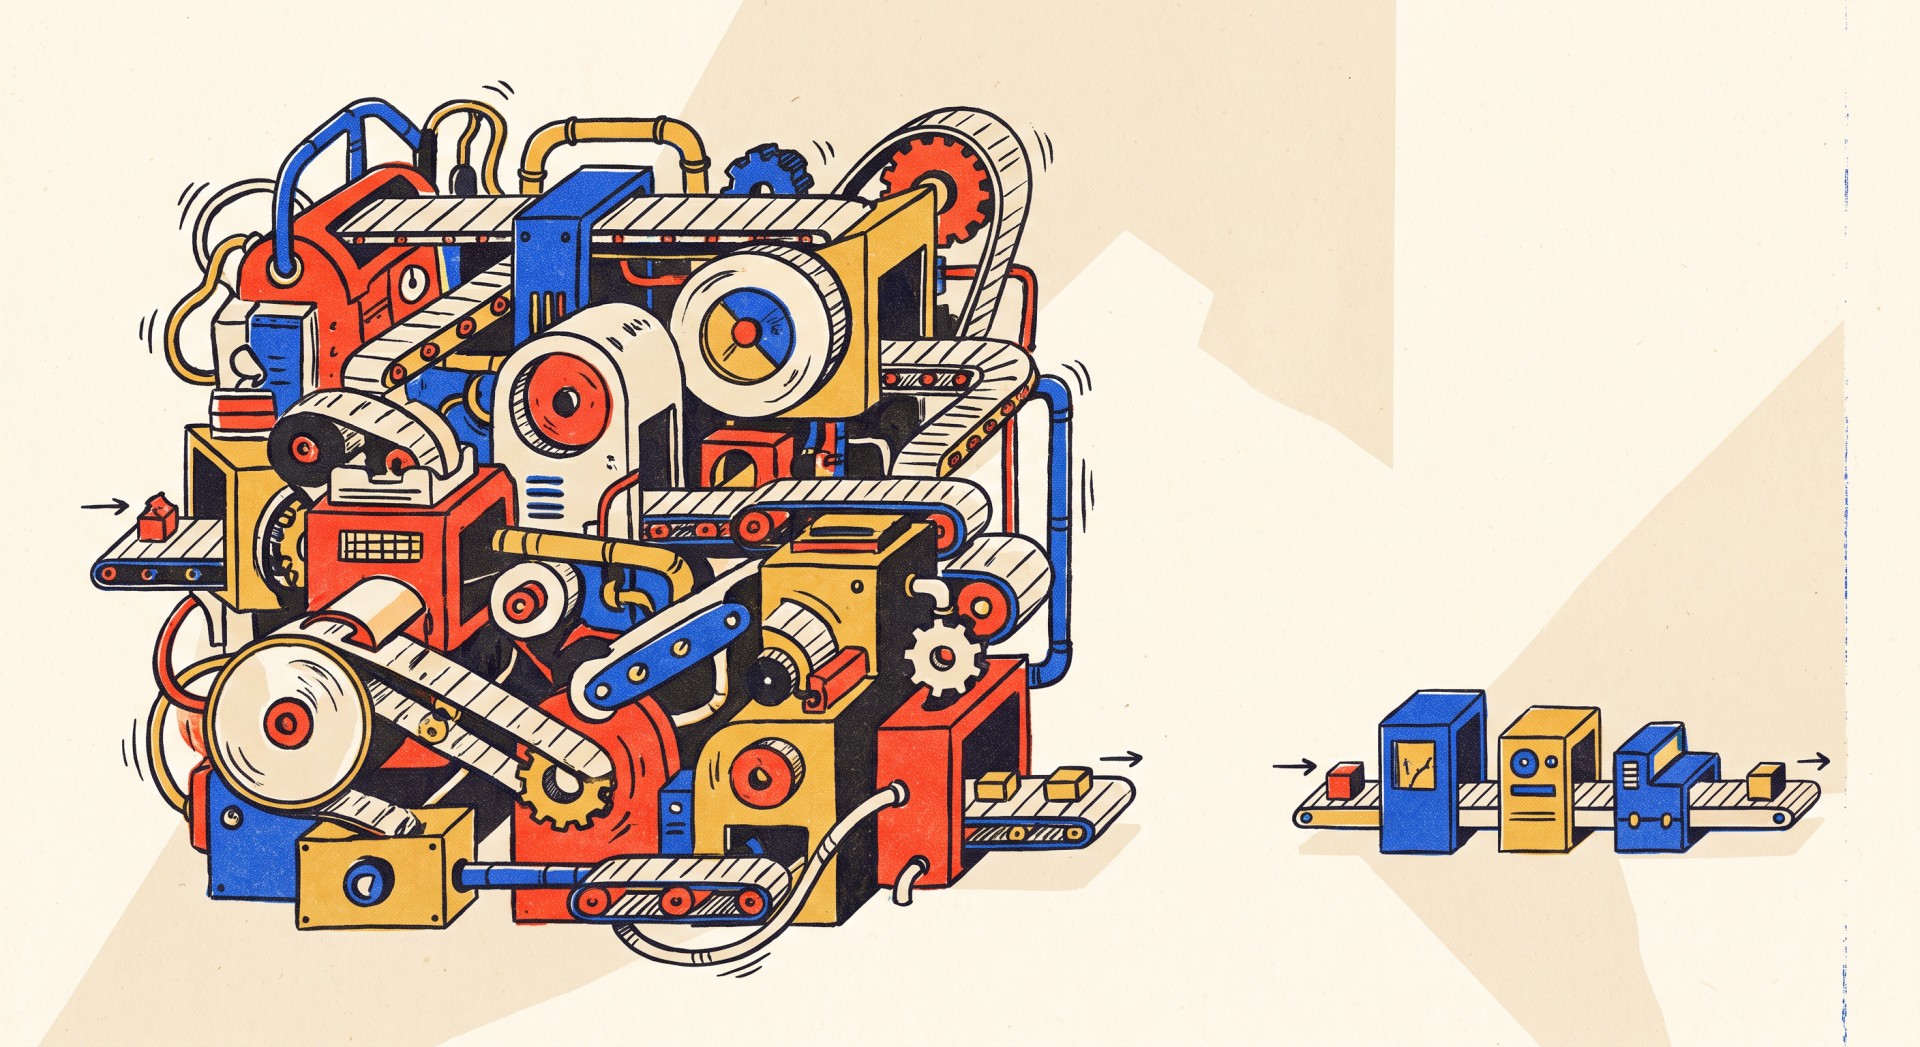
由 THE DECODER 提示 Nano Banana Pro 生成
AI 智能体越来越依赖复杂的训练流水线。TikTok 母公司字节跳动的一个团队与多所美国大学的研究者希望证明:三步就够了。
人们期望 AI 模型能够自行检索网络、运行代码并解决多步骤任务。根据一篇新论文,支撑这些能力的训练方法正变得越来越层层嵌套,许多开发者一个接一个地堆叠大量训练阶段。论文指出,现在已经几乎无法判断哪一步真正有用,而复现这些工作也正变得昂贵。
OmniRoute 是一个采用 MIT 许可的免费 AI 网关,用单一端点聚合 375 家厂商(其中 150 多家免费)、1,400 多个模型,包括 Kimi、Claude、GPT、Gemini、GLM、DeepSeek、MiniMax,兼容 Claude Code、Codex、Cursor、Cline、Copilot 等工具。
永不停歇地写代码。免费的 MIT 许可 AI 网关:一个端点,375 家厂商(150+ 家免费),1,400+ 个模型,包括 Kimi、Claude、GPT、Gemini、GLM、DeepSeek……意义所在:为交付 LLM 驱动的功能提供实用的基础设施。
GitHub 描述:永不停歇地写代码。免费的 MIT 许可 AI 网关:一个端点,375 家厂商(150+ 家免费),1,400+ 个模型,包括 Kimi、Claude、GPT、Gemini、GLM、DeepSeek、MiniMax。兼容 Claude Code、Codex、Cursor、OpenCode、Cline 与 Copilot。具备配额感知的自动回退,RTK+Caveman 压缩可节省 15-95% 的 token,支持 MCP/A2A,提供桌面版/PWA。由 900+ 位贡献者打造
在 GitHub 上查看网站☆关注分享对比
星标数
89k
最近 24 小时
+239
最近 7 天
+1.9k
分叉数
14k
GitHub 星标随时间的变化。线条越陡,说明该仓库受到的关注增长越快。
展示你实时的 OSS Radar 排名,并链接回这里。每小时更新。徽章如何工作。
复制 Markdown复制 HTML
cheaper-inference/OmniRoute 是一个 TypeScript 项目,属于 LLM 工具类别,创建于 9 个月前。它有 89k GitHub 星标和 14k 分叉,最近 7 天新增 +1.9k 星,在 OSS Radar 本周追踪的 145 个 LLM 工具仓库中排名第 13。
它有 5 天进入 OSS Radar 每日前 25 名:2026 年 10 月 23 日第 20 名(+516 星);2026 年 10 月 22 日第 23 名(+452 星);2026 年 10 月 18 日第 22 名(+419 星);2026 年 10 月 17 日第 23 名(+350 星);2026 年 10 月 14 日第 24 名(+438 星)。浏览完整的每日存档。
查看更多热门 LLM 工具仓库或本周热门 AI 仓库。想要类似的东西?参见 OmniRoute 替代方案。
语言TypeScript类别LLM 工具许可证MIT创建于2026 年 2 月 13 日最近代码推送今天(2026 年 11 月 21 日)最新版本v3.8.54 4 天前
OmniRoute 在今日排行榜中位列 450 个项目中的第 41 名。
美股科技板块遭遇疫情以来最差单周表现:纳斯达克100指数周五跌5.6%,全周累计跌10.4%,较10月峰值低20%,进入熊市区间。抛售由对数十亿美元AI建设项目的疑虑、英伟达相关丑闻与可疑中国交易、以及民主党中期选举获胜后的政治阻力共同推动。
美国科技股大幅下挫。 以科技股为主的纳斯达克 100 指数周五下跌 5.6%,本周累计下跌 10.4%,创下自 Covid-19 危机以来最差单周表现。据《金融时报》报道,这使该指数较 10 月峰值低 20%,进入熊市区间。对数十亿美元 AI 建设项目的疑虑、英伟达丑闻与可疑的中国交易,以及民主党中期选举获胜后的政治阻力,共同像一场完美风暴般推动此轮抛售。
投资者还在争论,鉴于芯片和存储类股票的周期性特征,其高估值是否仍然合理。与此同时,伊朗战争导致的高油价正在助推持续通胀,并使利率维持在高位。
英伟达周五受创最重,在有报道称美国证券交易委员会(SEC)正在审查其会计处理后,股价暴跌 14%。美国半导体指数也下跌 10.7%,闪迪、美光和博通等存储与芯片股普遍下跌。Anthropic 在上市次日下跌 9.1%。
来源:《金融时报》
姚顺雨这次把大家关心的几件事都聊了:混元4模型的进展、算力怎么投、榜单表现怎么看,还有自我改进这类问题。关心国产大模型路线的人,或者想知道混元下一步怎么走的人,可以看看。
最值得留意的一点是他透露下一代模型会大幅增加参数量。这基本说明了团队在规模上的取向,也顺带回答了一部分关于算力和投入的疑问。
榜单和刷榜的话题他也回应了,对在意模型真实水平而非排名的人比较有用。整体是一篇偏回应的短消息,信息集中在他本人的表态上。
数学家 Levent Alpöge 称与 Claude 合作发现黎曼猜想的证明,方法可推广至广义黎曼猜想,证明稿超过 25 万页,已无假设形式化为 Lean 代码共 14 个文件,尚未获独立验证。
YouTube哔哩哔哩
#1#2#3#4#7#8#9#10#11#12#13#14#15#16#17#18#19#20#1数学家 Levent Alpöge 在个人网站发布说明,称与
Claude模型合作发现了黎曼猜想的证明,方法可推广至广义黎曼猜想。完整证明稿超过 25 万页,他只放出了无假设的Lean形式化代码,论文待理解简化后再写。该证明尚未获独立验证。
正文
数学家 Levent Alpöge 在个人网站发布说明,称与 Claude 模型合作发现了数论经典难题黎曼猜想的证明,并称方法可推广至广义黎曼猜想。
他称已把论证无假设地形式化为 Lean 代码,完整写出的证明稿超过 25 万页,目前放出的代码共分 14 个文件。在他看来,贴出没人读得了的超长文档并不合适,计划待彻底理解并简化证明后再撰写常规论文。
他还预期,再多花些时间该方法可处理扩展黎曼猜想。消息迅速扩散,证明目前尚未获独立验证。
相关链接:
#2Thinking Machines 发布开源权重模型
Inkling 2 Mini,总参数 26.4B、激活参数 3.4B,官方称其采用looped transformer架构,部分基准测试得分领先所有总参数低于 100B 的开源权重模型。
正文
Thinking Machines 发布开源模型 Inkling 2 Mini,总参数 26.4B、激活参数 3.4B,采用 looped transformer 架构,中段 12 层对每个 token 跑三遍,以 Apache 2.0 许可开放权重。官方称其 DeepSWE v1.1 得分 48.2%,领先所有总参数低于 100B 的开源权重模型,AA Index 得分 20.1。该模型内存占用约 20GB,可经 Ollama 在 32GB 内存以上的 Mac 和 NVIDIA DGX Spark 上运行,已上线 Tinker 供推理和微调。

相关链接:
#3Antigravity 负责人 Varun Mohan 表示,Antigravity 正在大幅扩大
cache pool,以提高 Neon 的缓存命中率,预计用户在订阅额度内能完成的工作量至少增加 20%。升级完成后,Antigravity 将重置订阅用量。
正文
Antigravity 负责人 Varun Mohan 表示,Antigravity 正在大幅扩大 cache pool,以提高 Neon 的缓存命中率。
Mohan 称,这项调整将使缓存命中率提高约 4%,预计用户在订阅额度内能完成的工作量至少增加 20%。
由于此前配额消耗较快,Antigravity 将在调整完成后重置订阅用户用量。

相关链接:
#4OpenAI 宣布向 ChatGPT Plus 用户开放 Space 协作空间,支持多人协作创建交互式页面、幻灯片和网站,还带来移动端编辑、改版 Space 主页,页面加载更快。功能正面向所有 Plus 用户分批开放。
正文
OpenAI 宣布向 ChatGPT Plus 用户开放 Space 协作空间。Plus 用户每月支付 20 美元即可创建空间,邀请他人共同编辑,与 ChatGPT 一起创建交互式页面、幻灯片和网站。
ChatGPT Space 于 9 月的 OpenAI Dev Day 上推出,此前仅面向 Pro、Business 和 Enterprise 等付费方案。此次更新还带来移动端页面编辑、改版主页和更快的加载速度,页面还可关联已连接工具自动更新。
功能正面向全球年满 18 周岁的 Plus 用户分批开放;共享内容需登录拥有 Space 权限的付费账号,免费用户无法打开。

相关链接:
#5腾讯混元宣布开放旗舰模型
Hy4的权重,这是一款总参数 770B、激活 49B 的原生多模态MoE模型,同步发布了附带安全评估报告的System Card。
正文
腾讯混元宣布开放旗舰模型 Hy4 的权重。模型采用原生多模态 MoE 架构,语言模型主干总参数量 770B、每个 token 激活 49B,支持 1M 上下文,可理解文本、图像和视频。
权重及 GGUF 版本可在 GitHub、Hugging Face、ModelScope 和 GitCode 下载,本次开放的包括 Hy4、Hy4-FP8 和预训练模型 Hy4 base。
腾讯混元同时发布 Hy4 System Card,附带全面的安全评估报告,并计划本周五太平洋时间上午 8 至 10 时在 r/LocalLLaMA 举行 AMA。

相关链接:
#6腾讯发布开源全模态模型系列
WeMM-Video,一个模型能处理文本、图片、音频和视频,还能同时利用视频画面和原声音轨。官方称最大版本在全模态视频理解刷新开源最佳成绩,权重采用Apache 2.0协议。
正文
腾讯以Apache 2.0协议在GitHub和Hugging Face开源中英双语全模态模型系列WeMM-Video。
系列包含2B、4B、9B稠密模型和35B-A3B混合专家模型,支持文本、图像、音频和视频输入,处理视频时可同时利用画面和原始音轨,提供Instruct、Thinking双模式和FP8、AWQ、GGUF、NVFP4量化格式。
模型基于约1.2万亿多模态token预训练,官方称35B-A3B在全模态视频理解刷新开源模型最佳水平,超越Qwen3.5-Omni-Flash等闭源模型。


相关链接:
#7Codex 更新了对话线程,改善不同状态之间的切换,减少对话记录中的冗余信息,并加快应用冷启动时的对话加载。Codex 团队成员称,冷启动加载速度最多可提升 60% 至 70%。
正文
Codex 更新了对话线程,改善状态切换和对话加载体验。
Codex 团队成员表示,更新减少了对话记录中的冗余信息,让不同状态之间的切换更加流畅。
应用冷启动时,对话加载速度最高可提升 60% 至 70%。
此次更新还为对话线程加入了新的动画图标。

相关链接:
正文超过 1 万字上限,本页为节选 · 查看原文
LangChain 作者 Harrison Chase 于 2026 年 11 月 21 日撰文,提出让 AI 真正为公司发挥作用的关键是构建「知识工厂」,即收集、整理和维护知识的系统,而不是更好的模型或更多上下文。
作者:Harrison Chase(哈里森·蔡斯)
日期:2026 年 11 月 21 日
阅读时长:6 分钟
返回博客|创建 Agent
要让 AI 真正为你的公司发挥作用,缺的并不是更好的模型,也不只是更多的上下文——真正缺的是更好的知识。这种知识关乎你的公司如何运作、有哪些运营标准、数据存放在哪里以及如何访问。
你最高效的员工之所以高效,是因为这些知识装在他们脑子里。他们知道该找谁、去哪里找答案、为什么某件事要按某种特定方式来做。这些知识往往是隐性的、默会的、零散的——有时只存在于某个人脑中,有时散落在各种文档里。
要让 AI 真正为你的公司发挥作用,你需要收集、整理并维护一份知识的表示,再把它交给 Agent。帮你完成这件事的系统,我们称之为「知识工厂」。
在 LangChain,我们已经用几种方式建起了这样的知识工厂。我们内部的 GTM(Go-To-Market,市场进入)Agent 和内容工作室 Agent 都由知识工厂驱动。LangSmith Engine(我们那个运行在 trace 之上、给出修复建议的 Agent)也会为每个 Agent 维护一个知识工厂。本文分享我们的经验教训。
上下文是 Agent 在执行任务时可用的信息。
知识是我们维护的、可复用的理解,让 Agent 能正确地完成该任务:某个指标是什么意思、该信任哪个来源、我们如何处理某种特定情况。知识有时会被写下来,但往往不会。
知识工厂把零散的文档和经验转化为知识,而这些知识可以成为未来工作的上下文。
因此,知识是 Agent 将获得的一种上下文形式,但它往往不是(也不应该是)Agent 获得的唯一上下文。其他类型的上下文你已经在可靠地摄取和存储,可以直接提供给 Agent(见下文关于快速变化数据的部分)。
过去一年半里,「软件工厂」的概念迅速升温。其理念是:与其让你的顶尖工程师亲自构建软件,不如让他们去构建工厂(即系统),帮助公司里的每个人更高效地构建软件。软件的实际构建工作可以交给 Agent 完成。
如今,一般的知识工作也在走类似的路。Agent 已经足够强大,能做演示文稿、发布视频、做外呼。你应当尽可能利用它们来完成这些任务。但要让它们完成这些任务,它们需要那些隐性的、默会的、零散的知识。
这正是你应该投入资源的地方。你需要构建这些知识,更重要的是构建一个工厂来收集、整理和维护这些知识。只有这样,你才能把更多一般性知识任务外包给 Agent。
通常,你需要维护以下几类知识。
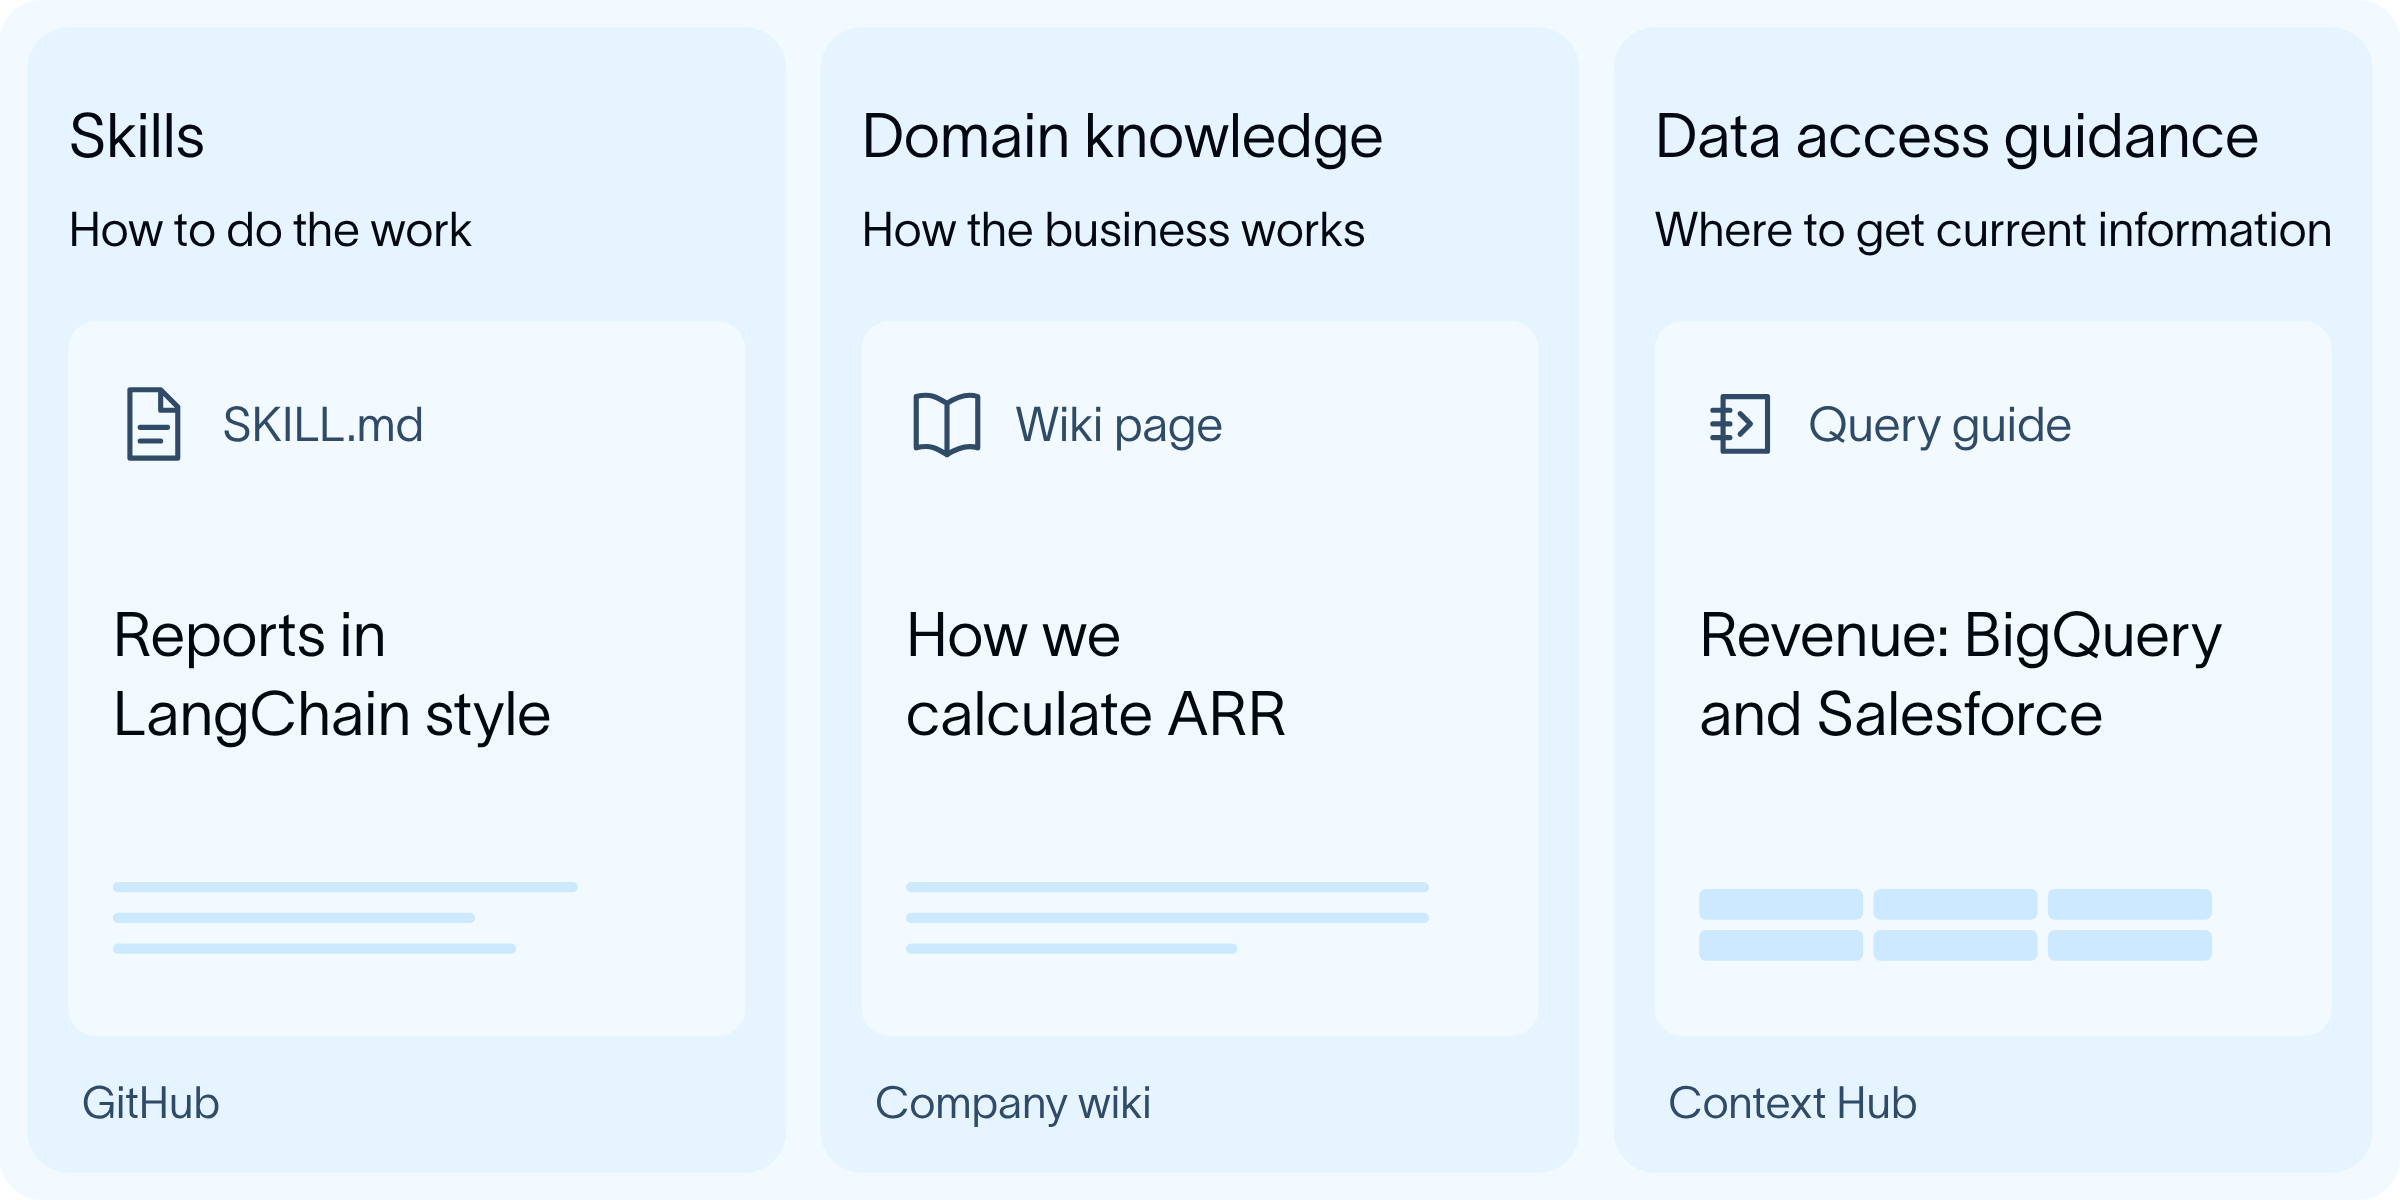
技能(Skills):这是关于在公司内部如何“正确”做事的流程,包括指令和脚本,用来按公司要求的特定方式完成任务。很多时候,这些内容从未被写下来过(而是一代代同事之间口口相传)。你应当努力把它们写下来。
领域知识(Domain knowledge):这是不容易频繁过时的知识,通常是关于人员、产品、竞争对手的核心信息。这类信息往往已经被写下来过——但通常并不完整(甚至不正确),仅仅是因为这里的知识量实在太大。
数据访问指引(Data access guidance):你应当有一套良好的数据策略(如 Snowflake、Databricks 等),这是让智能体真正有用的基础。如果数据的权威来源已经在那里,并且完整且保持最新,就无需再维护一份单独的副本。相反,你需要新维护的,是关于数据存放在哪里以及如何查询它的清晰指引。
要让智能体真正有用,上述所有信息都是必需的。不要试图手动维护它们,那是一项极其艰巨的工程。相反,你需要建立一个用于维护这些信息的系统。总体而言,这套系统的组成部分如下:
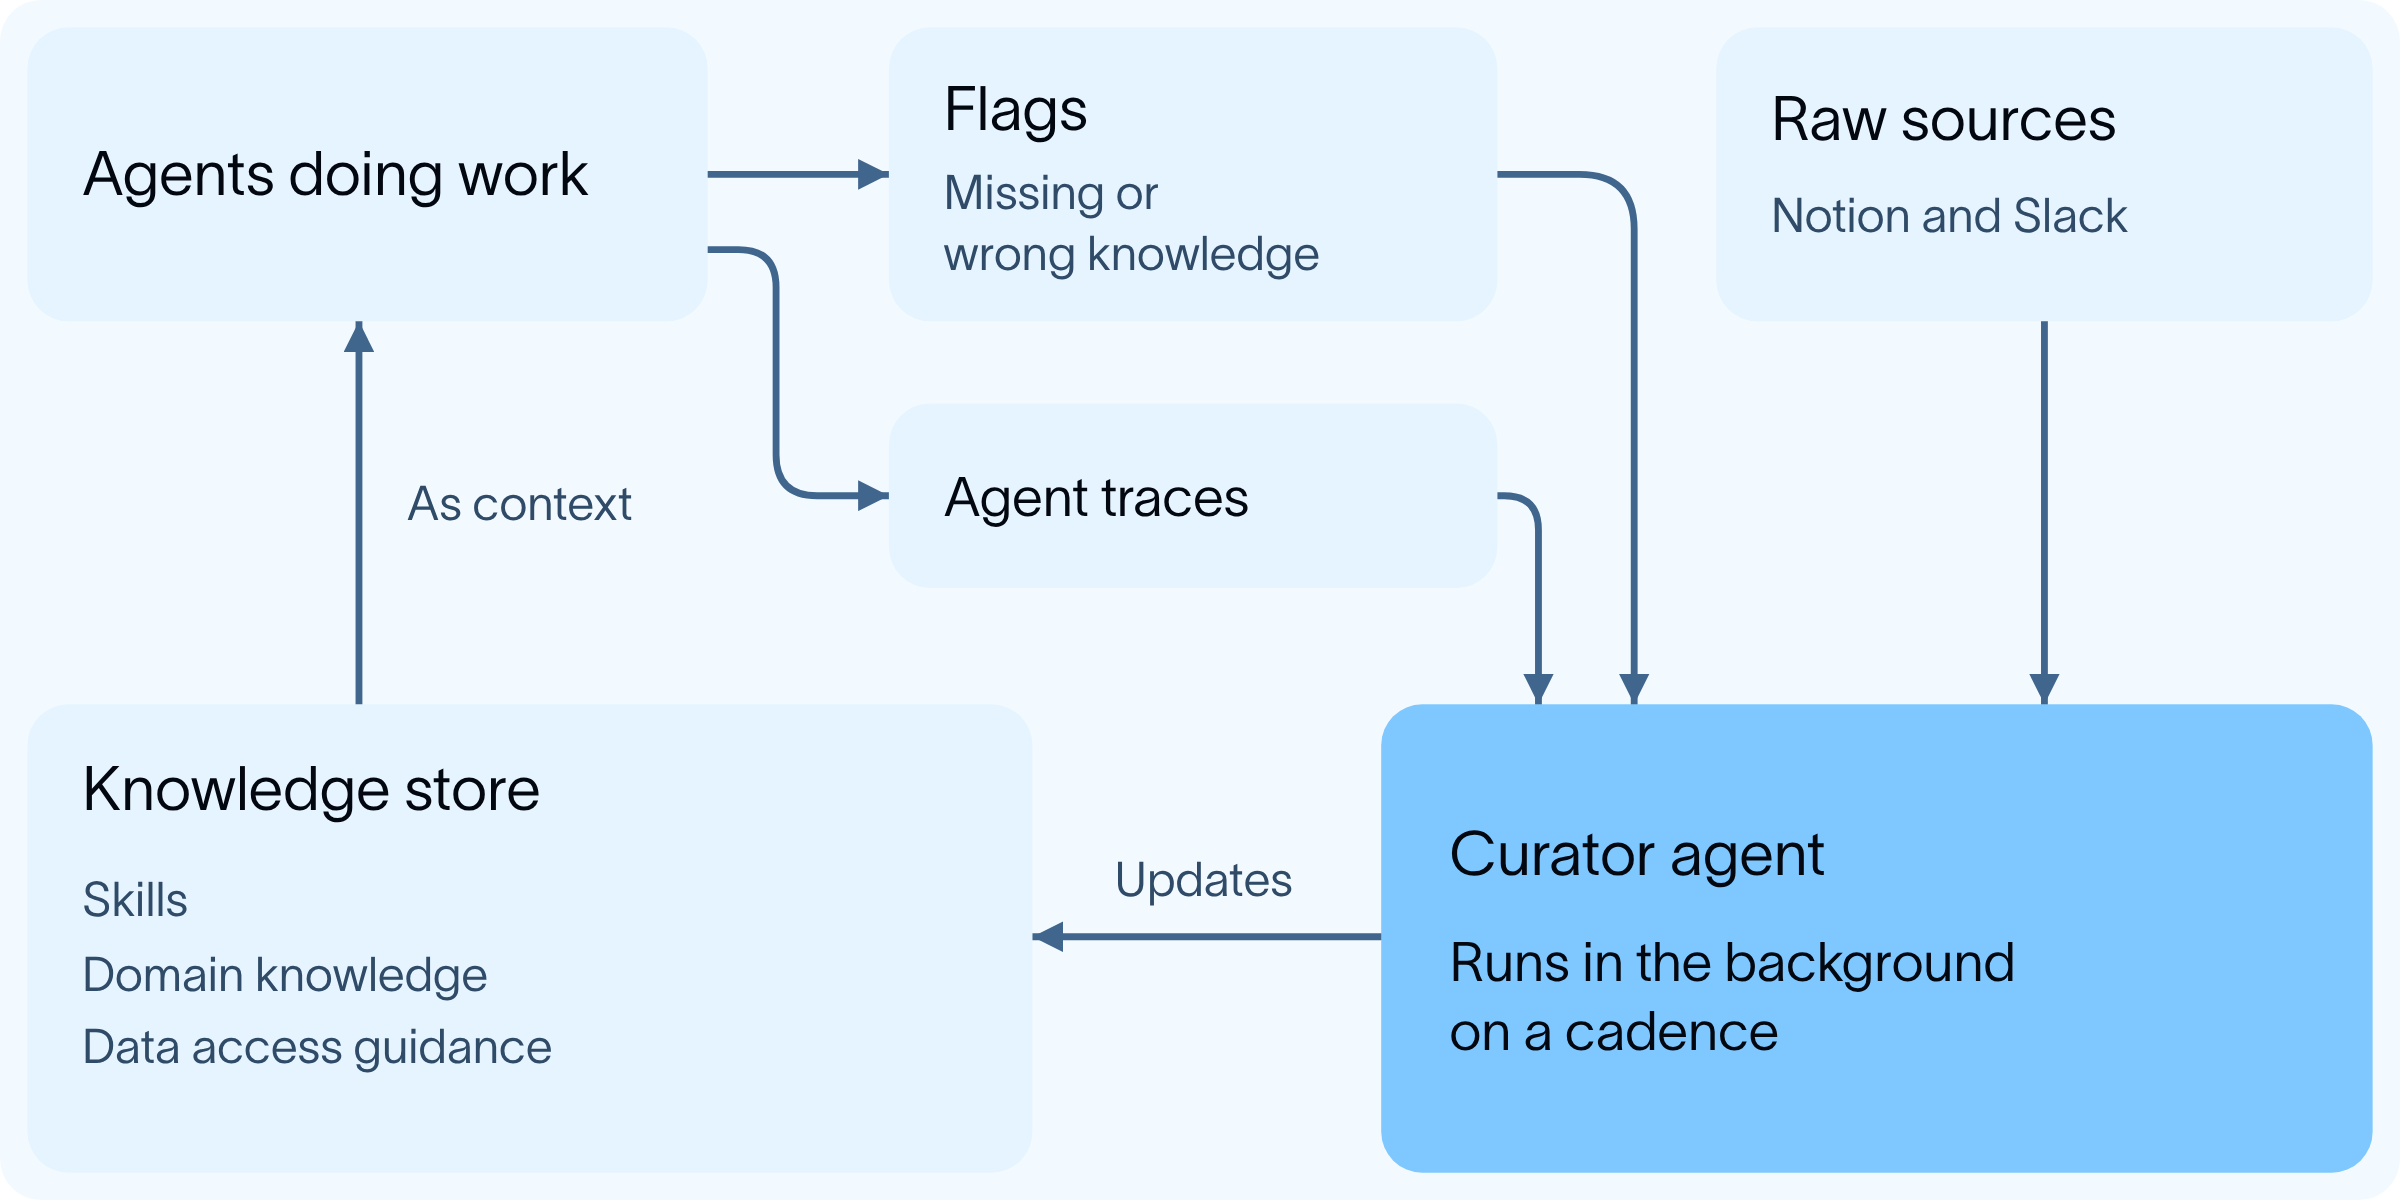
让智能体标记缺失知识的方式:了解哪些知识片段缺失的最佳方式之一,是让智能体在工作过程中主动标记出来。如果它们被要求做某件事,却找不到相关信息,或者发现找到的信息有误,就应当标记出来!给智能体提供一个工具,至少要能报告哪里有问题,并可选地建议正确的更新内容。
策展智能体:负责更新、策展和维护这些知识的智能体:这些知识不应靠人工保持最新,工作量太大。也不应仅由使用这些知识的智能体来维护更新:它们擅长标记错误或缺失之处,但修复这些问题需要深入理解底层知识及其他数据来源。如果让那些主要忙于完成自身目标的智能体去妥善更新和维护这些知识,知识库就会变得混乱且充满矛盾。相反,你需要一个在后台运行、按某种节奏(on some cadence)更新这些知识的策展智能体。它应当有权访问所有原始数据源(Notion、Slack 等),这些知识可能分散在这些地方;它应当有权访问智能体追踪记录(agent traces),从而了解人们如何使用智能体,并将其固化为技能;它还应当有权访问智能体标记为错误的内容(即上一节所述内容)。
知识的存储:在某些方面,这其实是最不重要的部分。你可以把这些知识以技能格式存储在 GitHub 中,也可以放在 Notion 的单个文件里,或以 OKF 格式存储在 LangSmith Context Hub 中,还可以存入 Neo4j 的知识图谱里。策展智能体应当知道如何与所有这些格式交互(这并不难)。从另一些方面看,这又是探索最少的领域。记忆(memory)该如何表示?作为行业,我们已经在“程序性记忆”上趋于采用技能的形式。对于更多的语义记忆,很可能会出现另一种标准(OKF?)。现在为时尚早,尚无标准出现,因此最好不要对这个格式规定得过于死板,也不要把它搞得过于复杂。
最后,用一个端到端的例子来收尾:一个 agent 正在准备一份收入报告。
agent 会需要一些基础上下文:原始收入数据,存储在 BigQuery 和 Salesforce 中。
然后是知识。知识可能由几种不同类型组成:
agent 开始运行。它可能注意到我们在 BigQuery 中重命名了某一列。它即时推断出正确的列名。它使用自己拥有的工具来上报问题、标记这一点,并建议正确的列名。
在它创建报告之后,我们的财务负责人与 agent 同步协作,修复了一些格式问题,包括告诉它使用我们现在需要用于所有 LangChain 文档的新标题。
当晚,curator agent 看到了被标记的问题。它还检查了 agent 的追踪记录,注意到与我们的财务负责人之间的这轮来回沟通。它相应地更新了相关技能(在获取数据时使用新列,在起草报告时使用新标题)。

正文超过 1 万字上限,本页为节选 · 查看原文
这篇讲的是谷歌和宾州州立大学的一篇论文,提出了一个叫“自我改进记忆(SIM)”的机制。简单说,就是让模型把自己优化过的经验写进记忆里,而且这些经验还能跨模型家族继承下去。
关心AI模型训练、模型迭代效率的人会感兴趣,尤其是做模型优化和记忆机制研究的读者。它讨论的是模型能不能像人一样积累经验、越用越强。
最值得看的一点是“经验可跨模型继承”:不是每个模型都从零学起,前一个模型摸索出的优化经验能传给后面的模型,这跟论文标题里提到的RSI直接相关。