月之暗面 10 月 23 日发布 Kimi K3.1 Pro,Kimi 网页版和 App、办公助手 Kimi Work、编程工具 Kimi Code 和 API 当天都能用。
官方说它是自家最强的开放权重模型,完整权重 11 月 4 日前放出。
K3.1 Pro 是在上一代 Kimi K3 基础上继续训练出来的,模型结构没换,多花了大量算力做强化学习,也就是让模型在几百个领域里反复做任务、按结果打分改进。
模型总共 2.8 万亿参数,处理每个 token 只动用其中约 1040 亿(token 是 AI 处理文字的单位,可以理解成文字碎片)。这种结构叫混合专家(MoE):模型里有很多分工不同的“专家”小网络,每次只叫上一小部分干活,所以比同样大的普通模型算得快,但整个模型仍要全部装进内存。它一次能读 100 万 token,相当于一个中型代码仓库或几百页财报,也能看图和视频。
【和 Claude、GPT 比怎么样】
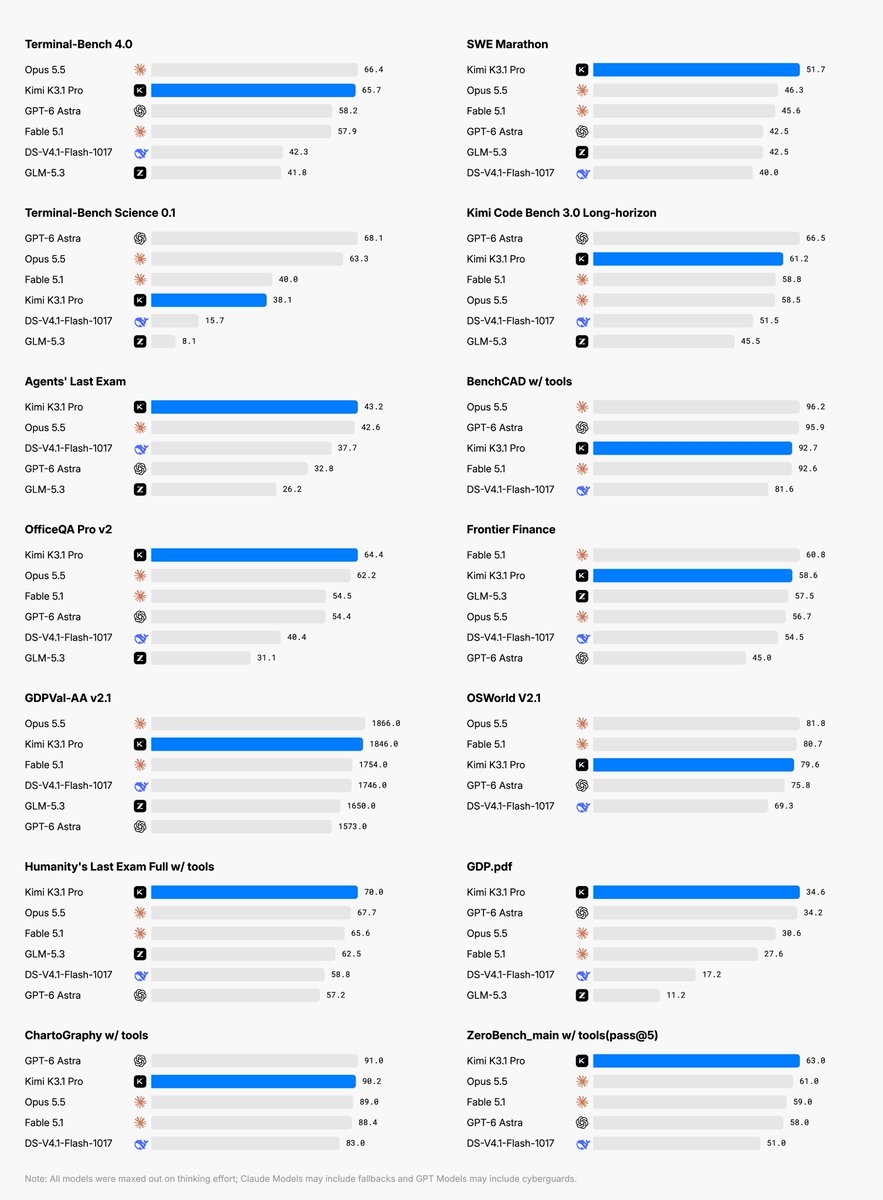
下面的成绩都来自月之暗面自己公布的对比表,对手是 Anthropic 的 Claude Opus 5.5、Claude Fable 5.1 和 OpenAI 的 GPT-6 Astra,所有模型开到最高推理强度。部分对手成绩是 Kimi 自己测的,内部测试外人无法复现。
写代码基本追平。
在命令行里完成真实开发任务的 Terminal-Bench 4.0,K3.1 Pro 65.7%,Opus 5.5 66.4%,GPT-6 Astra 58.2%;做大型软件项目的 SWE-Marathon,K3.1 Pro 51.7 分排第一,Opus 5.5 46.3。科学计算类的 Terminal-Bench Science 差距大,K3.1 Pro 38.1,GPT-6 Astra 68.1。
3D 建模稍逊。
K3.1 Pro 能直接写脚本操作 Blender、CAD 软件和 Unity、Unreal、Godot 游戏引擎,官方演示里做出了完整的 3D 游戏和能 3D 打印的台灯。在看几张渲染图、写 CAD 代码把零件还原出来的 BenchCAD 上,K3.1 Pro 92.7%,Opus 5.5 96.2%,GPT-6 Astra 95.9%。
金融是这次主打。
读真实财务文件、做多步计算的 OfficeQA Pro v2,K3.1 Pro 64.4 分排第一,Opus 5.5 62.2。Kimi 内部测试里,财务建模比 K3 高 7.2 分,写研究报告高 11.6 分。
推文说的“幻觉降低 65%”,来自 Kimi 内部一套专挑难题的事实核查测试:K3 说的每 100 个事实里有 23 个错的,K3.1 Pro 降到 8 个出头。同一测试里 Opus 5.5 是 15 个,GPT-6 Astra 是 5.5 个。官方注明这是压力测试,不代表日常使用的出错率。
【多少钱,能不能自己跑】
普通用户在 Kimi 网页版和 App 里就能用,免费用户能用多少官方没写。企业版默认关闭,要管理员手动开。
API 每百万 token 输入 2 美元、输出 10 美元,是 K3 价格的三分之二。Claude Opus 5.5 是输入 4 美元、输出 20 美元,贵一倍。快 2 到 3 倍的 Highspeed 版输入 4 美元、输出 20 美元,和 Opus 5.5 同价。API 账户要先充值至少 1 美元才能用。
开放权重是指模型文件公开,任何人都能下载,放在自己的服务器上运行、微调,数据不用经过月之暗面。但个人电脑跑不动:按 K3 采用的 4 位精度推算,光存放 2.8 万亿参数就要约 1.4TB 内存。许可证条款官方还没公布。
为了开放权重,月之暗面说训练时删掉了网络攻防相关的数据。同一套训练流程不删数据,内部漏洞利用测试能解 90.5% 的题,删了之后是 81.0%。官方称它的攻击能力仍落后于已经公开三个月以上的闭源顶级模型。
原文:
官方博客:
API 文档:
platform.kimi.ai/docs/guide/kim…
Kimi.ai@Kimi_Moonshot
隆重推出 Kimi K3.1 Pro:我们迄今最强、3T 级别开放权重模型
我们隆重推出 Kimi K3.1 Pro——这是我们迄今能力最强、专注于推理的模型,3T 级别开放权重。基于 Kimi K3(Kimi K2.5 的后继模型),K3.1 Pro 在架构、强化学习、大规模并行训练和基础设施方面带来了全面升级,其表现超越了我们之前最好的模型。
Kimi K3.1 Pro 在四项基础推理基准——编码、智能体、数学和长上下文——上都取得了扎实的提升,且所用激活参数远少于同级别的闭源模型。
主要结果
| 基准 | Kimi K3.1 Pro | Kimi K3 | DeepSeek-V4.1 | GPT-5.5 | Claude Opus 4.7 |
|---|---|---|---|---|---|
| SWE-bench Verified | 82.6 | 76.4 | 78.9 | 80.1 | 81.3 |
| SWE-bench Pro | 58.4 | 51.2 | 54.7 | 56.0 | 57.2 |
| AIME 2025 | 98.1 | 95.3 | 96.7 | 97.0 | 96.9 |
| HMMT 2025 | 96.4 | 92.8 | 94.1 | 95.2 | 95.6 |
| GPQA Diamond | 90.2 | 87.5 | 88.6 | 89.3 | 89.8 |
| LiveCodeBench | 80.8 | 77.1 | 79.2 | 78.4 | 79.1 |
| BrowseComp | 81.5 | 76.8 | 78.1 | 79.6 | 80.2 |
架构
我们在保持超稀疏 MoE(混合专家)设计的同时,扩展了总参数与激活参数预算。关键改动包括精炼的多头潜在注意力(MLA)变体、更高效的专家路由,以及改进的结构化稀疏模式,使每 token 能以更低计算量激活更多参数。
模型总参数约 3 万亿,每 token 激活约 1000 亿参数。这一规模让我们能够部署开放权重模型,同时在推理任务上保持与前沿闭源模型相当的竞争力。
强化学习
我们从头重建了强化学习流水线。主要改进包括:
- 面向智能体任务的稳定长时程 RL: 我们扩展了训练时程,并引入异步 rollout,让智能体轨迹在多个轮次间保持一致。
- 可验证奖励的规模化: 我们在数学、编码和工具使用等可验证领域扩充了奖励模型,显著减少了奖励欺骗(reward hacking)。
- 过程奖励: 我们加入了轻量过程级奖励,以在长链推理后期步骤中改进信用分配。
大规模并行训练
K3.1 Pro 在数千块加速器上完成了训练,采用全分片数据并行、专家并行和流水线并行,并受益于新的容错检查点方案,使训练能在大规模故障下持续进行。
基础设施
我们重构了推理栈,以更好利用 3T 级开放权重模型:分块预填充、专家卸载(expert offloading),以及面向长上下文的可变长度批处理。
支持状态
- 聊天界面: 所有用户均可使用。
- API: 通过我们的平台开放,并提供兼容 OpenAI 的接口。
- 开放权重: 在 Hugging Face 上以开放权重形式发布。
- 工具调用与智能体模式: 支持。
- 长上下文: 最高支持 256K token。
快速开始
pip install kimi-sdkfrom kimi import Kimi
client = Kimi(api_key="YOUR_API_KEY")
response = client.chat.create(
model="kimi-k3.1-pro",
messages=[{"role": "user", "content": "你好!"}],
)
print(response.choices[0].message.content)技术栈
- 架构: 超稀疏 MoE(混合专家),带精炼 MLA
- 训练: 全分片数据并行、专家并行、流水线并行
- 推理: 分块预填充、专家卸载、变长批处理
- 上下文长度: 最高 256K token
- 支持语言: 中英双语及多语言
评测
我们使用标准化、公开的提示与设置,并进行了多次独立运行。所有结果均通过内部流水线复现。
局限
- 在超出已训练范围的高度新颖领域,可能生成不正确内容。
- 并非对每种工具模式都完全优化。
- 通过 API 使用时的延迟可能高于较小模型。
致谢
感谢开源社区和所有贡献者。
🔹 100 万 token 上下文,总参数 2.8 万亿 / 激活参数 1040 亿(MoE),多模态。
🔹 全项目级编程:可在 Unreal、Unity 和 Godot 中制作游戏。
🔹 擅长在 Blender 和 CAD 中进行参数化 3D 建模。
🔹 在金融工作上更可靠:建模准确,幻觉降低 65%。
🔹 在编程、智能体(agentic)和知识基准测试中,与最强的专有模型不相上下。
Kimi K3.1 Pro 与 K3.1 Pro 高速版(速度提升 2–3 倍)现已上线 Kimi Work、Kimi Code 和 Kimi API。
2026 年 11 月 4 日前开放权重。
🔗 API:
🔗 技术博客: