今天,我们正式发布 Muse Spark Open,这是迄今为止美国最强的开源权重模型。
在编码与智能体(Agent)类任务中表现优异,专为长程任务、复杂软件工程与多步推理而打造。
关键模型规格
- 总参数 816B(激活参数 42B)
- 100 万 token 上下文窗口
- 原生多模态,覆盖文本、图像、视频、音频


先选日期回看当天导读,再按主题筛。下面列表会跟到那一天。
今天的内容有几个值得留住的节点。苹果国行 AI 终于有了确切上线时间,库克本人确认十月底先在大陆测试,对一直等着的人来说是个实在消息。Meta 放出一个超大规模开源多模态模型,普通苹果电脑就能跑;国产阵营里蚂蚁百灵的轻量模型、Step 5 Preview 也在同一天开源。
库克亲自确认,Apple Intelligence 将于十月底在中国大陆推出测试版,首批包含写作工具、照片中抹除多余物体、实时翻译等功能。与之前绕路方案不同,这次是真·本地化上线,国行用户等了两年终于能用上。
蚂蚁百灵开源 Ling-3.1-flash,阶跃星辰开源 Step 5 Preview,两者都支持百万级 token 上下文。此前这种能力通常只在大厂闭源产品里出现,现在开源就能上手,处理长文本、代码库分析等场景更方便。
Meta 发布开源权重模型 Muse Spark Open,总参数 816B、激活 42B,上下文 100 万 token,原生支持文本、图像、视频与音频。官方称其为目前美国最强开源权重模型,且两台 Mac Studio 即可运行,将顶级多模态 AI 的体验门槛拉低。
展开本期选读,查看 5 条精选新闻与编辑推荐
本期选读已读完 · 查看详细,返回资讯浏览
一份日报,一点新的想法。30TOOL / DAILY BRIEF
今日 AI 日报总结:根据当期推送内容整理,推荐优先关注的方向与热点。向下滚动左侧列表可浏览近半个月往期。
今天的内容有几个值得留住的节点。苹果国行 AI 终于有了确切上线时间,库克本人确认十月底先在大陆测试,对一直等着的人来说是个实在消息。Meta 放出一个超大规模开源多模态模型,普通苹果电脑就能跑;国产阵营里蚂蚁百灵的轻量模型、Step 5 Preview 也在同一天开源。
点击左侧任意资讯,切换到具体文章阅读。
Meta发布并开源Muse Spark Open,参数量816B,上下文100万Token,原生支持文本、图像、视频和音频,两台Mac Studio即可运行,定位为美国最强开源权重模型。
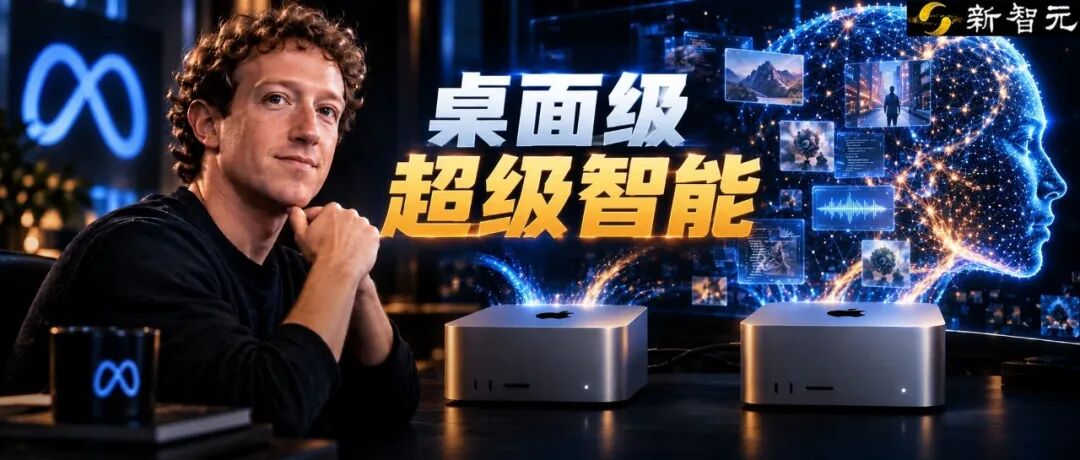
Meta 又放大招了,这次直接甩出一个 816B 参数的开源多模态模型 Muse Spark Open,原生就把文本、图片、视频和音频全包了,上下文还能塞下 100 万 token。
最炸的是,它号称美国最强开源权重模型,而且两台 Mac Studio 就能跑起来,普通玩家也能玩。对搞 AI 的开发者、喜欢折腾开源大模型的技术宅来说,这条消息值得蹲一蹲。
最大亮点就是它把这么大的参数规模压到普通苹果电脑也能跑,这在以前基本是不敢想的事,等于把顶级多模态 AI 的门槛一下子拉低了一大截。
APPSO现场采访确认苹果智能Apple Intelligence将于10月底在中国大陆推出测试版,首批包括写作工具、图像消除、实时翻译等功能,国行用户等待两年的苹果AI终于落地。
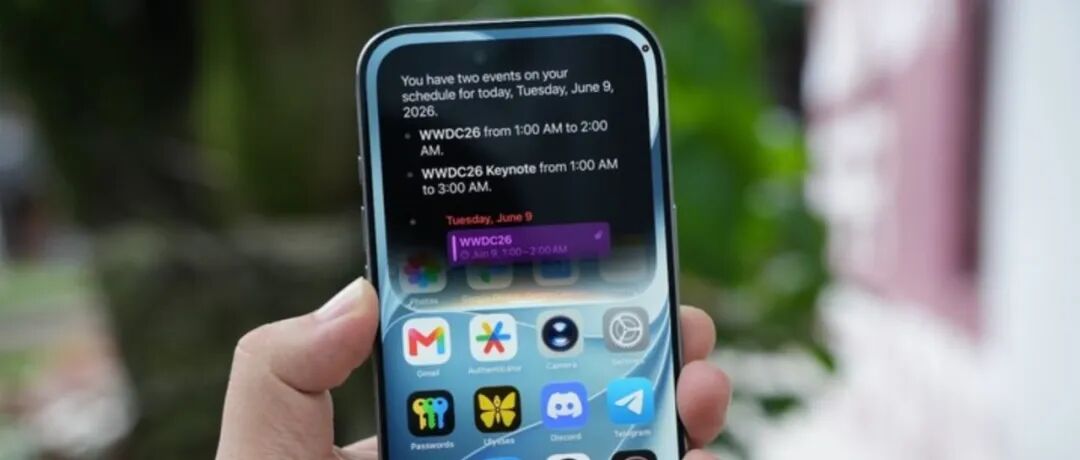
等了两年,国行苹果的 AI 总算要来了。库克亲自确认,十月底就能在大陆先用上测试版,首批功能包括帮你改稿子、抹掉照片里多余的东西、还有实时翻译。对于天天在 iPhone 上写东西、拍照、跟老外聊天的朋友来说,这波更新可能会改变你用手机的习惯。
最值得盯的一点是:苹果 AI 这回是真·本地化上线,不是搞个曲线方案绕一圈,这说明在国内跑 AI 这件事上,他们终于把路给蹚平了。
DeepSeek服务宕机数小时,官方事后向受影响用户补偿金额,引发社区广泛好评,体现厂商对服务故障的担当。
DeepSeek 这回宕机了好几个小时,结果官方不光认账,还主动给受影响用户补了钱,评论区一片叫好。这事儿看着小,其实挺有意思——现在 AI 产品出故障基本都是冷冰冰一条公告,DeepSeek 愿意掏真金白银补偿,说明它把用户感受当回事。
对经常用国产大模型干活、怕关键时刻掉链子的人来说,这种态度比啥宣传都管用。最值得看的就一点:AI 公司开始愿意为“服务挂了”买单了,这对整个行业的服务标准是个挺积极的信号。
Meta正式发布开源权重模型Muse Spark Open,总参数达816B,激活参数42B,上下文窗口为100万token,并支持文本、图像、视频与音频的原生多模态处理。
该模型主打编码与智能体类任务,针对长程任务、复杂软件工程和多步推理进行了优化,被定位为美国目前最强的开源权重模型。
今天,我们正式发布 Muse Spark Open,这是迄今为止美国最强的开源权重模型。
在编码与智能体(Agent)类任务中表现优异,专为长程任务、复杂软件工程与多步推理而打造。
关键模型规格
文章以"个人记账分析助手"为例,演示如何用 Pydantic AI 从零搭建一个能真正干活的 AI Agent。
很多人第一次写 AI Agent,写完都有点失望。
代码确实能跑,模型也确实在说话,但往下走两步就露馅了:
返回的是一段字符串,你得自己 json.loads(),还得写一堆兜底防止它今天返回 JSON、明天返回 Markdown;
想让它查你自己的数据,就得手写一个 prompt 解释"我有个函数叫 xxx,参数是 yyy,你可以这样调用",prompt 越写越长;
等你想给它写个单元测试,发现代码里到处是全局变量和一个写死的路径,根本没法测。
问题不在模型不够聪明,而在中间缺一层工程约束。
而 Pydantic AI 可以干这层活:它把你熟悉的 Python 写法,类型注解、Pydantic 模型、装饰器、数据类——直接接到大模型上,让"输出必须是这个结构","这个函数可以被调用","这个数据源运行时再给"等等这些事在代码层面被约束住,而不是靠 prompt 里的恳求。
本文尝试从零搭一个个人记账分析助手:你问一句"上个月我花了多少,钱花在哪了",它自己去读账单、算环比、拆分类、挑出异常消费,最后交回一个结构完整的结论对象。
LLM 不等于 Agent。 调一次接口问一句答一句,那叫"用大模型"。
Agent 多出来的是它可以自己决定接下来干什么:调用你写的函数,拿到结果继续想下一步,最后交出校验过的对象。少一样,它就是个会说话的字符串生成器。
Pydantic AI:它是 Pydantic 团队做的 Agent 框架。
思路就一句话:用类型系统把 Agent 管起来。
你定义输出模型,它替你生成 Schema、替你校验、不过自动让模型重答;你注册一个函数,它替你翻译成模型看得懂的调用说明;你声明依赖类型,它替你在运行时把数据源送进工具。
要戒掉的坏习惯。 是那种"我先解析一下试试"的临时代码。不确定性能在框架层消掉,就别再手写 try/except 去兜。
最终要搭的东西,画出来是这样:
整条链路里真正属于"AI"的只有中间那个方块。左边是你的问题,右边是 Excel 和推送,中间读账单、算分类、找异常全是实打实的 Python。
账单的好处是数据你自己就有。
支付宝和微信支付都能导出交易明细,整理成一张带日期、类别、金额、支付方式、备注的表(date / category / amount / method / note)就能用。
要回答的问题也就这几个:花了多少、比上个月多还是少、钱主要在哪几类、有没有不该花的。 注意这套流程是固定的——取数、聚合、算环比、拆分类、找异常;变化的是"用户想问哪段时间、关心哪个类别"。
固定的写进 Python,理解意图的交给模型,这是全文最重要的一条。
别急着搭,先确认"模型能说话"。
python -m venv venv
source venv/bin/activate  # Windows 用 venv\Scripts\activate
pip install "pydantic-ai" pandas numpy
export OPENAI_API_KEY="sk-xxxx"  # Windows 用 setx OPENAI_API_KEY "sk-xxxx"
第一个 Agent 有两个必填项:
from pydantic_ai import Agent
from pydantic_ai.models.openai import OpenAIChatModel
from pydantic_ai.providers.openai import OpenAIProvider
MODEL = OpenAIChatModel(
    "deepseek-ai/DeepSeek-V3.2",
    provider=OpenAIProvider(
        base_url="https://api.siliconflow.cn/v1",
        api_key=os.getenv("OPENAI_API_KEY"),
    ),
)
ledger_agent = Agent(
    MODEL,
    instructions=("你是一名个人财务分析助手。"),
)
result = agent.run_sync("什么是大语言模型?")
print(result.output)
我使用的是硅基流动中的 DeepSeek 模型,instructions 是系统级人设,对每一次运行都生效。
run_sync 是同步版,塞进 FastAPI 时换成 await agent.run(...),API 面完全一样。
到这里 result.output 还是个字符串,能用,但没法直接进你的表格。
这是收益最大的一步:给 Agent 指定 output_type。你把想要的结构用 Pydantic 模型描述出来,剩下的框架全包——生成 JSON Schema、和 prompt 一起发出去、拿回结果做校验、不过就带着报错让模型重答。
本文这个助手最终要交出的东西:
class MetricChange(BaseModel):
    name: str = Field(description="指标名,如 支出总额 / 笔数 / 单笔均值")
    current: float
    previous: float
    change_pct: float = Field(description="环比变化百分比,保留一位小数,单位 %")

class SpendingInsight(BaseModel):
    period: str = Field(description="分析区间,形如 2026-09-01 ~ 2026-09-30")
    headline: str = Field(description="一句话结论:花超了还是省下来了,把数字带上")
    top_categories: list[str] = Field(description="花钱最多的前三个类别,按金额降序")
    anomalies: list[str] = Field(default_factory=list, description="异常消费,没有就返回空列表",)
    suggestions: list[str] = Field(description="下个月能做的具体动作,不要写套话")
    confidence: float = Field(description="结论可信度,0 到 1 之间", ge=0.0, le=1.0)
每个字段都挂了 Field(description=...),这不是注释,它会出现在发给模型的 Schema 里,是在明确告诉模型这个字段到底要什么,写得清楚能直接减少重试次数。
这个模型其实就是一份接口契约:定了之后,写 Excel 也好、推送到群里也好,拿到的永远是同一套字段。
光有结构化输出,模型还是不知道你上个月到底花了多少。工具就是把你的 Python 函数借给它用。
先看清一次调用的完整循环:
两个关键点:第③步和工具之间可以来回好几轮,模型会一步步补信息;而每一次工具调用都是一次模型请求,工具做得越碎,钱和时间花得越快。所以工具的设计原则是一次给足信息。
一个普通函数是怎么被模型看懂的:
装饰器的区别只有一处:@agent.tool_plain 用于不需要运行时上下文的函数;@agent.tool 第一个参数是 RunContext[...],用来拿注入进来的东西。
@ledger_agent.tool
def get_metrics(ctx: RunContext[LedgerRepo], start: str, end: str,
               categories: list[str] | None = None) -> str:
    """查询一段日期内的支出总额、笔数、单笔均值,
    并自动与上一个等长周期做环比。
    Args:
        start: 开始日期,YYYY-MM-DD。
        end: 结束日期,YYYY-MM-DD。
        categories: 消费类别列表,不传表示全部。
    """
    return json.dumps(ctx.deps.query_metrics(start, end, categories),
                      ensure_ascii=False)
那段 docstring 不是注释,是给模型看的调用说明书,写得含糊它就会在错误的时候乱调。
还有一条实操经验:所有计算都放进工具里。环比、占比、均值必须是 Python 算好再返回,模型只负责"读懂数字、说出人话"。
到这里代码能跑,但账单数据源是写死的。每次换文件、每次写测试都要改工具代码,改完还得祈祷没改错。依赖注入解决的就是这件事:Agent 声明自己需要什么类型,具体给哪个实例,运行时再说。
把所有取数收进一个数据类,它就是你和数据源之间的接口:
@dataclass
class LedgerRepo:
    frame: pd.DataFrame  # 换成数据库、换成 API 都一样

    def available_dimensions(self) -> dict: ...
    def query_metrics(self, start, end, categories=None) -> dict: ...
    def breakdown_by_category(self, start, end) -> dict: ...
    def top_expenses(self, start, end, limit=5) -> dict: ...
Agent 上声明 deps_type=LedgerRepo,运行时把实例塞进去就行:
repo = LedgerRepo(frame=pd.read_csv("bill.csv", parse_dates=["date"]))
result = ledger_agent.run_sync("上个月我花超了吗?", deps=repo)
insight = result.output  # 一个 SpendingInsight 实例
print(insight.headline, insight.top_categories)回报在写测试时立刻兑现——不用改 Agent 的任何定义,直接把依赖换成 mock:
with ledger_agent.override(deps=build_mock_repo()):
    result = ledger_agent.run_sync("看一下最近花了多少")
想连模型调用都省掉,官方还有 TestModel / FunctionModel,同样 override 掉 model 就能离线跑。
框架把可复用行为做成了可组合的 capabilities,挂上去就行,不挑供应商。
from pydantic_ai.capabilities import Thinking, WebSearch

agent = Agent(
    "deepseek-ai/DeepSeek-V3.2",
    instructions="你是一名个人财务助手,结论必须有数字支撑。",
    capabilities=[Thinking(effort="high"), WebSearch()],
)
Thinking 让它先一步步推再作答,适合"消费为什么涨"这种归因;WebSearch 给它外部视角,比如某月多花是不是赶上了节假日。
要不要开看场景:算数已经交给 Python 了,日常关掉更省钱,也免得它被网上不相干的内容带偏。
完整代码:ledger_agent_demo.py:(访问密码:6872)
有兴趣的话可以用这个代码尝试一下:
export OPENAI_API_KEY="sk-xxxx"MODEL = OpenAIChatModel(
"deepseek-ai/DeepSeek-V3.2",
provider=OpenAIProvider(
base_url="https://api.siliconflow.cn/v1",
api_key=os.getenv("OPENAI_API_KEY"),
),
)
csv_path = os.getenv("LEDGER_CSV")执行结果(默认方式 python ledger_agent_demo.py):
$ python ledger_agent_demo.py
pydantic-ai v2.54.0 • Python 3.12.12
/ \  agent: ledger_agent • model: openai:deepseek-ai/DeepSeek-V3.2 • output: SpendingInsight • tools: 4
/ \  capabilities: 0
/___\___\
/ | \  observability: off — see every model and tool call live, with cost
   / | \  set it up free with Logfire and a GitHub login: https://pydantic.dev/ai-setup.md
`---.._|_..---' or use any OpenTelemetry backend: https://pydantic.dev/docs/ai/logfire/#otel
goes away once observability is on — or PYDANTIC_AI_NO_BANNER=1
== 上个月花超了,总支出 16,864.79 元,比上个月多花 67.1%
-- 区间: 2026-09-01 ~ 2026-09-30
   支出总额: 16864.79(环比 67.1%)
   笔数: 243.0(环比 37.3%)
   单笔均值: 69.4(环比 21.7%)
-- 花钱最多的类别: 购物、餐饮、娱乐
-- 异常消费:
   - 2026-09-01 居住类支出 2,439.86 元
-- 原因分析:
   - 购物支出 4,825.27 元占总支出 28.61%,比上个月明显增加
   - 9 月初有大额居住支出 2,439.86 元一次性拉高整体消费
   - 餐饮消费 3,870.85 元笔数达 90 笔,单日消费频次较高
-- 下个月怎么做:
   - 下个月重点关注购物类消费,把单笔购物控制在 200 元以内
   - 餐饮支出过高,尝试工作日午餐自带或降低外卖频次
   - 大额居住消费已发生,下个月房租支出会恢复正常
-- 可信度: 0.95
如果使用自己的数据,请先导出自己的交易明细,整理成带 date / category / amount / method / note 五列的 CSV(比如文件名 bill.csv);
然后 LEDGER_CSV=./bill.csv python ledger_agent_demo.py。

Anthropic 旗下 Claude 平台的 Opus 5.5 快速模式已结束研究预览阶段,正式取消等待名单。该模式基于相同的 Opus 5.5 模型,速度最高提升至 2.5 倍,定价为每百万 token 输入 8 美元、输出 40 美元。
Claude 平台上的 Opus 5.5 快速模式(fast mode)已结束研究预览阶段,我们已取消等待名单!
它是相同的 Opus 5.5,但速度最高提升至 2.5 倍,价格为每百万 token 8 美元 / 40 美元。
它也可在 Microsoft Foundry(由 Azure 提供托管)中使用,Google Cloud 支持即将推出。
Claude Code(命令行版 Claude)中的快速模式(Fast mode)保持不变,仍按原有方式运行,并使用额外的使用额度(extra usage credits)。
查看我们的文档:[相关链接]
platform.claude.com/docs/en/build-…
ClaudeDevs
Claude Opus 4.7 的快速模式(Fast mode)现已在 API(研究预览版)和 Claude Code 中开放使用。
每日AI要闻速览:Claude Code桌面版更新多会话体验并新增自动压缩; TypeSafe AI更新Jev模型; SpaceXSI发布Grok Voice 3.0语音模型;蚂蚁百灵开源Ling 3.1 flash;昆仑万维开源Matrix Game 4.0等。
YouTube 哔哩哔哩
#3#4#5#6#7#8#9#10#14#15#16#17#18#19#20#21#22#23#24#25#1Anthropic 更新了 Claude Code 桌面应用,重点改善多个会话并排运行的体验,开会话更快,拆分工作更方便,也能随时看到每个会话在做什么。用户让 Claude 并行处理任务时,它会为每项任务开一个嵌套会话,完成后再把结果汇报回主会话。另外,Claude 会在工作中主动建议后续任务,一键就能另开会话,侧边栏也会标出哪些会话还在运行、哪些需要用户处理。…−
正文
Anthropic 更新 Claude Code 桌面应用,围绕多会话并行改进会话启动、工作拆分和状态查看。
新会话界面可一键打开近期文件夹,用户还能把几个文件夹、一台 SSH 主机或云端保存为环境,直接在其中启动会话,并可为每个文件夹单独使用 worktree。
用户要求并行执行任务时,Claude 会为每项任务启动嵌套会话,完成后把结果汇报回主会话;Claude 主动建议的后续工作可一键作为独立会话运行,用 /btw 提出的旁支问题会在单独标签页打开,主会话继续运行。
侧边栏会标出哪些会话正在工作、哪些需要用户介入,会话内还有跟随计划更新的实时待办列表和总结本轮的回顾卡片。
用户更新桌面应用并新建会话即可使用。
相关链接:
#2Anthropic 介绍近期为
Claude Code终端加入的闲置会话自动压缩功能,该功能可在缓存过期前把长对话压成摘要。用户可自行调整触发压缩的最低token数,或关闭该功能。…−
正文
Anthropic 为 Claude Code 终端加入闲置会话自动压缩功能:默认达到 200K token 的对话闲置约 54 分钟后,会在 1 小时的 prompt cache 过期前压缩为摘要。
用户返回后只需重新处理摘要,而非整段对话,以节省用量,但 Claude 也将基于摘要而非完整上下文继续工作。
用户可调整触发压缩的最低 token 数,或关闭该功能;这两项配置需要 v2.1.290 或更新版本。


相关链接:
#3TypeSafe AI 发布 Jev 新版本,同时开放图像输入、图像目标定位和更长上下文等实验性功能。这些功能需要在
API中主动开启,官方提醒,目前可靠性仍不足以支持生产场景。…−
正文
TypeSafe AI 发布 Jev 1.14.0,通过 jev-preview 提供,并开放图像输入、box 类型和长上下文等实验性功能,需通过 API 请求头中的 danger zone 标记主动开启,官方尚不建议用于生产场景。
图像可放入状态、问题指令或判断标准中,Jev 1.13 和 1.14 均支持;用于定位图像目标的 box 类型仅支持 1.14,每个问题返回单个边界框。
两个版本开启长上下文后,单次请求和单个问题的上下文上限均为 262k token,但速度和准确率会下降。
新版本价格与 1.13 相同,每百万输入 token 为 0.042 美元,输出 token 免费。


相关链接:
#4SpaceXSI发布端到端语音模型
Grok Voice 3.0,已通过API开放,价格与前代相同,在Artificial Analysis语音综合评测中排名第一,官方称星链客服每天用它处理2万通来电,约七成无需人工介入。…−
正文
SpaceXSI 发布 Grok Voice 3.0 端到端语音模型,已通过 Voice Agent API 开放,维持前代每分钟 0.08 美元的价格,使用 grok-voice-latest 的应用已自动切换。
官方称,该模型在 Artificial Analysis Speech to Speech 综合指数中以 86.9 分排名第一,响应时间低于 1 秒。
官方还表示,星链客服每天使用 Grok Voice 处理 2 万通来电,其中约 70% 无需人工介入即可解决。

相关链接:
#5蚂蚁百灵宣布开源
Ling-3.1-flash,开发者目前可在 Hugging Face 和 ModelScope 获取模型权重与相关文档。…−
正文
蚂蚁百灵宣布开源 Ling-3.1-flash,总参数约 5600 亿,每个 token 激活约 250 亿参数,支持最高 100 万 token 上下文。权重与文档已在 Hugging Face 和 ModelScope 提供。
蚂蚁百灵称,本地部署采用 MXFP4 专家权重和 block-FP8 稠密层后,权重体积从约 534GB 降至约 292GB,一套经过测试的 Hopper 配置所需 GPU 从 8 张减至 4 张。

相关链接:
10月16日AI速递:Anthropic确认Claude Max/Team用户月度额度可用于第三方应用;另汇总DeepSeek崩盘、元器停服等多条要闻。
最近AI圈的瓜有点多,腾讯研究院的AI速递帮你一次性捋清楚。这期最劲爆的消息是:Anthropic终于松口,Claude Max和Team用户的月度调用额度,可以拿给第三方应用去花了。这对经常把Claude用在工作流里的朋友来说,是个真金白银的省钱信号。
同期的DeepSeek崩盘和元器停服也值得留意,不然哪天你常用的工具突然罢工都不知道为啥。整体来看,这期就是一份AI圈的当日便签,适合每天扫一眼跟上节奏的打工人。
10月15日AI日报汇总:xAI发布Grok Voice 3.0定价0.08美元;蚂蚁百灵开源Ling-3.1-flash支持1M上下文;阶跃星辰开源Step 5 Preview百万上下文MoE模型。
今天的AI圈挺热闹,三家都甩出了新东西。xAI把语音助手Grok Voice升到了3.0版,定价只要0.08美元,听起来是想跟别人拼性价比。蚂蚁家把百灵大模型做了个轻量版Ling-3.1-flash,直接开源,上下文窗口拉到100万token,处理长文本应该挺顺手。阶跃星辰也不藏着掖着,把Step 5 Preview这个百万上下文的MoE模型放出来了,想白嫖的可以试试。
搞AI应用、做大模型微调、或者做智能体产品的同学,这波可以重点看看Ling-3.1-flash和Step 5 Preview,都是开源能直接上手的,尤其处理超长文档、做代码库分析这类场景比较有用。做语音产品的也别错过Grok Voice 3.0,价格是真便宜。
最值得划重点的是:现在百万级上下文已经开始卷到开源阵营了,这俩模型都能免费用上,之前这种能力基本只在大厂闭源产品里有。想试试长上下文到底有多能打的,现在是个好机会。
Anthropic 周三向投资人披露,由其他公司对其模型进行"蒸馏"所产生的收入占总营收的 5%–7%,且第三季度该项收入已大幅下滑。蒸馏指用大型模型输出来训练小模型,对手实验室通过付费接口向 Claude 大量提问收集回答,相关调用按用量计费。
报道指出蒸馏合作伙伴在第三季度"需求疲软",公司未透露收入下滑具体原因。
Anthropic 告诉投资人:蒸馏占营收 5% 到 7%,三季度已大幅削减
据报道,Anthropic 在与投资者的最新沟通中透露,由其他公司对其模型进行「蒸馏」(distillation)所产生的收入占其总营收的 5% 到 7%。所谓蒸馏,是指用大型模型的输出结果来训练更小、更高效的模型。Anthropic 表示,第三季度该项收入已经出现「大幅下降」(substantial decline)。
这一披露让外界得以一窥这个通常高度保密的指标。蒸馏业务为 Anthropic 提供了一条相对稳定的收入来源,同时也意味着公司可以从竞争对手的 AI 开发中获得收益——即便这些产品最终被用来与 Anthropic 自家模型竞争。
Anthropic 并未具体说明蒸馏收入下滑的原因,但报告指出,蒸馏合作伙伴在第三季度「经历了需求疲软」。该报道还提到,Anthropic 目前预计其年化营收将在年底前达到约 70 亿美元,高于此前在夏季设定的 50 亿美元目标。
Anthropic 周三向投资人通报,“蒸馏”带来的收入占公司营收的 5% 到 7%,第三季度公司已经把这部分“大幅”削减。消息来自英国《金融时报》(FT),援引四位直接知情人士;The Information 也报道了同样的区间。
蒸馏是什么?就是拿更强模型的回答当教材,训练自己的模型。对手实验室向 Claude 大量提问,把回答收集起来喂给自家模型,就能用较低成本学到 Claude 的一部分本事。
既然是“学”,为什么会算进 Anthropic 的营收?因为这些提问走的是付费接口,每一次调用都按用量计费。蒸馏动辄要问几百万、上千万次,FT 的说法是蒸馏“涉及大量使用和花费”。也就是说,这笔收入是对手实打实付的钱,只是付钱的目的是训练竞争对手的模型。Anthropic 的商业服务条款明确禁止用它的服务“训练有竞争关系的 AI 模型”。
5% 到 7% 是多少钱?报道没说这是哪个时段的占比,所以只能估算。网上流传的算法是按二季度营收 115 亿美元算,对应约 5.75 亿到 8 亿美元。注意这是推算,不是报道里的数字。115 亿美元这个数,来自 8 月彭博社看到的公司文件,原文是“超过 115 亿美元”,属于初步数字,Anthropic 没有公开确认。
报道也没说这些钱来自哪几家公司。今年 2 月,Anthropic 曾发文点名 DeepSeek、月之暗面(Moonshot)和 MiniMax,说三家通过约 2.4 万个虚假账号,绕过 Claude 不对中国提供服务的限制,和 Claude 进行了 1600 多万次对话来蒸馏。
主动砍掉这部分收入是有代价的。Anthropic 正在筹备上市,同一次通报显示,它三季度营收 168 亿美元,比二季度增长约 46%,而二季度比一季度翻了一倍多,增速已经放慢。据报道,公司告诉投资人,蒸馏收入减少会拖累本季度的数字;换来的是对手更难靠抄 Claude 的答案追上来。
Simon Willison@simonw
Anthropic 周三告诉投资者,精馏(distillation)贡献了其 5% 到 7% 的营收。
如果这是真的,并且第二季度营收为 115 亿美元,那么其他实验室蒸馏 Anthropic 的模型就花费了超过 5 亿美元!

Krea 发布面向生产环境的图像编辑模型 Krea 3,宣称速度比 Nano Banana Pro 快 4 倍,并主打“只改你要改的部分”。

对比对象
Krea 3 是一款为生产环境打造的图像编辑模型。它只改动你要求修改的部分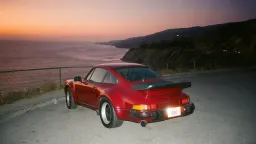
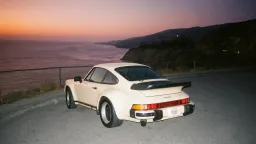
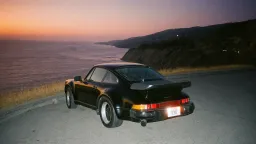
 ,单次编辑耗时低于 X 秒(原文为 0s),单张图片费用为 $0.00。
$0.00 单张图片价格
0 倍 比 Nano Banana Pro 更快
低于 0 秒 单次编辑耗时
Krea 3
我们通过全球领先的机构进行分发,助力他们推动各自行业的发展:
fal Baseten Comfy Luminal Together AI Envato  Creative Fabrica Oxen Civitai RouterPlus Mito AI Flora Eachlabs
fal Baseten Comfy Luminal Together AI Envato Creative Fabrica Oxen Civitai RouterPlus Mito AI Flora Eachlabs
 1
 2
 3
在图 1 的蓝色布景上,以手冲滴滤器与马克杯为主体,搭配图 2 的礼盒,礼盒内装两罐图 3 的咖啡罐,生成一张入门套装捆绑页主视觉。
将图 1 中路边广告牌重新换皮为一个意面品牌,并用图 2 中旋转的意式干面条替换原图中的桃子。
将图 1 中的质感插画转为同一视角下的实景照片,保留原图中所绘的凉亭、水池、露台与绿植。
用图 2 中的 Logo 把图 1 中的红色购物袋替换成 Halo Bagels 袋。
在图 1 的街拍照片中,用图 2 中的棕色真皮手提包替换原图中的粉色手提包,并让她用手中的提手提着它。
将图 1 中的四个像素角色转换为图 2 风格的风格化 3D 角色,保留每个角色的设计与配色。
为图 1 中的书桌生成一张近距离特写:图 2 中的演员(金色头发、有胡茬、棕色高领衫)进入画面,用左手拿起桌上的红色旋转拨号电话听筒贴到耳边。
将两位人物合成一张抓拍照片,背景为图 3 的复古客厅。
按图 1 的鱼眼自拍构图,从上往下拍摄一张鱼眼自拍:图 1 中的男子将图 2 中的腊肠犬抱在怀中。
Krea 3
画一个框并说明要改的内容。Krea 3 会重绘框内区域,其余画面保持原样。
对同一张图像进行的三次 Krea 3 局部编辑。被改动的像素量是与原图的对比结果。
给出一个十六进制色号,Krea 3 就会在产品上——且仅在产品上——匹配该颜色。挑一个色卡试试。
原图 改成 #7EC8F2 #FFC12E #D9C3A3 #2F5D46 #B9A3E8 原图
毛绒玩具
911
桌面风扇
连衣裙
厨房中岛
玻璃展架
唇彩
沙发
隧道
提示词
让 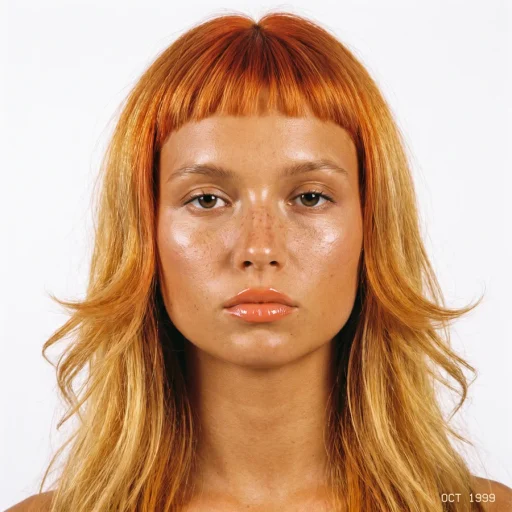 中的女子坐在烛光摇曳的艺术装饰风格酒吧里,身穿
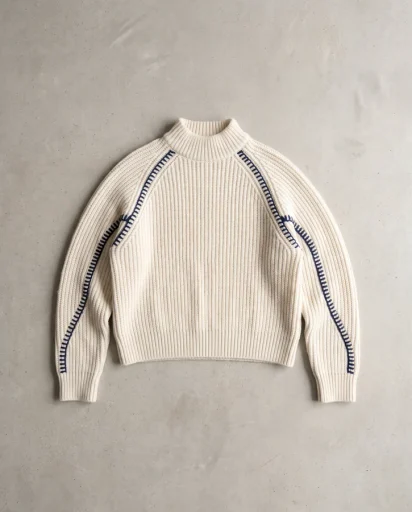 中的针织毛衣,吧台上放着
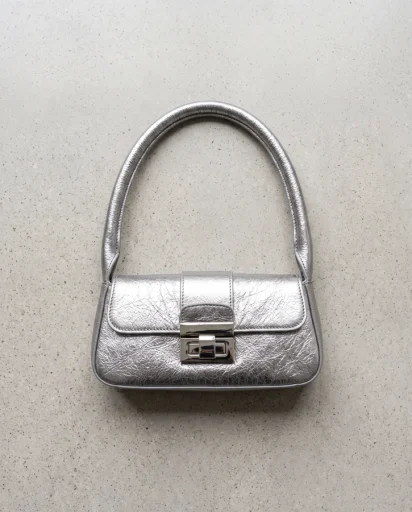 中的银色手提包。
IMG_5547.jpg
Sweater.jpg
Bag.png
用编号指认人物、产品、场景与风格。Krea 3 会将它们整合到同一张图片中。
在保持面部特征一致的前提下,改变造型、场景与氛围。通过一系列编辑,体验角色一致性带来的表现力。
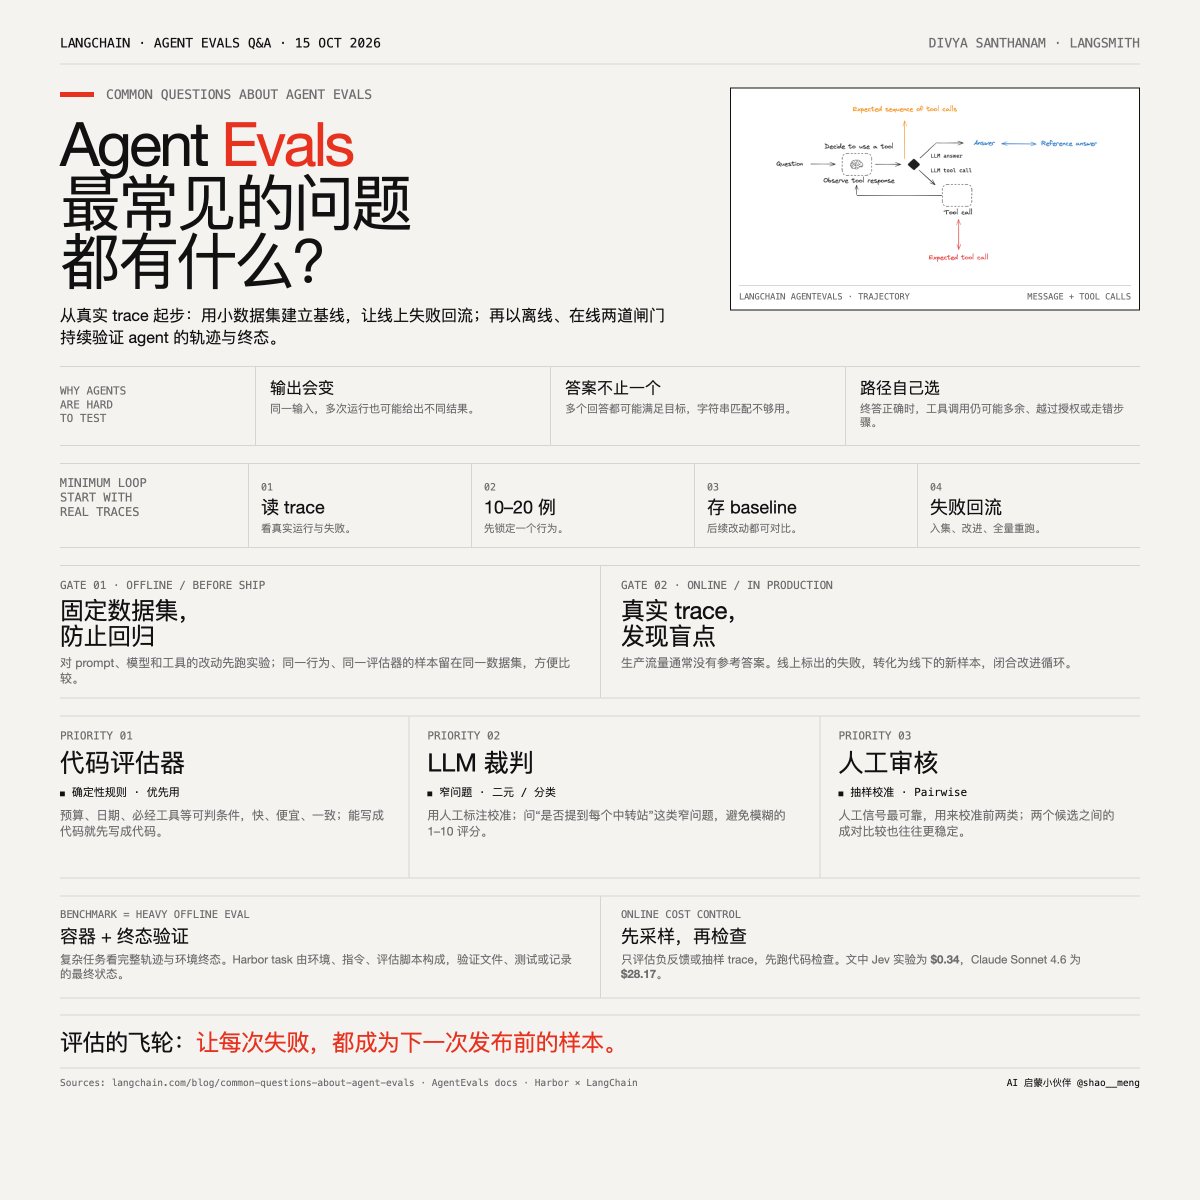
LangChain 团队的 divyasan0 以 Q&A 形式分享 Agent 评估实践指南。文章指出 Agent 测试难在输出不确定、答案不唯一、路径自选三点。推荐从真实 trace 起步、建 10–20 条小数据集做基线,并把失败案例回流迭代。评估应分离线发布前回归与在线生产监控两层闭环。
Agent Evals 最常见的问题都有什么?
@LangChain 团队 @divyasan0 以 Q&A 形式分享了 Agent Evals 实践指南,把常见问题一次性回答了。她给出的可落地工程流程:从真实 trace 起步、小数据集建立基线、失败案例回流迭代、离线/在线分层评估、代码优先于 LLM 裁判、benchmark 用容器化环境验证最终状态。
QA 博客地址:
为什么 Agent 难以测试 ?
· 输出不确定性:同一输入,多次运行结果不同;
· 答案非唯一:多个不同回答都可能是正确的,无法做字符串精确匹配;
· 路径自选:Agent 自己决定执行步骤,即使最终答案正确,路径也可能是“错的”(调用了不必要的工具、未经授权就行动)。
起点:从 trace 开始的最小闭环
一条清晰路径值得直接采纳:
读一批真实 trace → 选定一个行为 → 建 10–20 条小数据集 → 跑基线实验 → 之后所有改动都与基线对比。
其中最有价值的工程习惯是失败回流机制:发现一次失败 → 作为新样本加入数据集 → 改进 agent → 重跑全量。这让数据集随系统演化而增长,评估从“一次性验证”变成“持续改进的飞轮”。未上线的团队可以用内部 dogfooding 产生 trace。
离线 vs 在线:两道互补的闸门
· 离线评估(Offline):发生在发布前、对数据集、用来测新 prompt/模型/工具防回归
· 在线评估(Online):发生在生产环境、对真实流量 trace、用来持续监控线上质量
两者形成闭环:线上标出的失败,转化为线下的新样本。数据集组织原则也很实用,同一行为、同一组评估器的样本放一起;输入、评估器或目的不同就另建数据集,避免一个大盘子什么都装。
评估器的优先级:代码 > LLM 裁判 > 人工
· 代码评估器:确定性检查(如“价格是否低于预算”),快、便宜、零歧义,能用则必用;
· LLM-as-a-judge:处理代码判不了的主观维度(如“回复是否清晰确认了航班信息”);
· 人工审核:最贵但最可靠的信号,用于抽样校准前两者;
· Pairwise(成对比较):让裁判二选一,比绝对打分更稳定。
评估对象的颗粒度也分层:单步 → 最终回复 → 完整对话 → 环境终态(如容器内记录、文件、测试是否通过)。
LLM 裁判能否信任:三条可操作建议
Eval ≠ Benchmark:一个重要的概念澄清
Benchmark 本质是 “重型离线 eval”,其特殊性在于:
· 任务长链路,涉及数十次工具调用;
· 每个任务自带独立的容器化隔离环境;
· 评分方式是检查运行后的环境状态(订票记录是否存在、代码测试是否通过),而非比对文本。
文中介绍了开源评估 harness Harbor(Terminal-Bench 的底层引擎),每个任务构建一个容器,结果记录到 LangSmith 实验。自建 benchmark 的路径:从 trace 收集任务 → 定义评分规则 → 对分数做 hill climbing(爬山式迭代优化),甚至可以做成 Karpathy 式的自动化研究循环。
线上评估的成本控制
生产流量全量打分不现实,博客给出三层降本:
不必从零自建
生态已提供相当多现成件:针对幻觉、PII 泄露等常见问题的预置 LLM 评估器模板、开源 agentevals 包(针对消息和工具调用)、可从代码仓库和 trace 直接生成可运行评估的 Eval Engineering Skill、从 issue 聚类自动生成数据集和断言的 LangSmith Engine。且整个体系框架无关;支持 OpenAI Agents SDK、Claude Agent SDK,或用 @ traceable 装饰器裸接。
迁移也不必推倒重来:数据集以 CSV/JSONL 导入,pytest/Vitest 集成保留现有测试体系,已有裁判 prompt 直接粘贴复用。
两个进阶难题
多轮对话:每一轮都看似正常、整体却失败的“累积性失败”是单点评估的盲区。解法是给 trace 附上 thread ID 将各轮聚合,再挂载面向整段对话的在线评估器(如“用户是否被迫重复了自己的需求”);离线侧则把完整对话存为样本,或用 LLM 模拟用户。
超越最终输出:复杂 agent 需要检查轨迹(消息/工具调用序列)与终态(仓库变更、测试结果)。例如编码 agent 跑完后直接在其工作环境里执行该 repo 的测试套件;这正是 Harbor + 容器化沙箱的设计动机。