先快速梳理一下过去几个月里 OpenAI 和 Anthropic 发布的主要大模型。以下价格数字格式均为 输入 MTok / 输出 MTok / 缓存读取 MTok。
2026 年 6 月 26 日#
OpenAI 宣布推出 GPT-5.6 Sol 和 Luna。Sol 是 GPT 5.5 的直接继任者,价格保持不变,为 $5 / $30 / $0.50;Luna 则是专为更便宜的使用场景设计的小模型,价格为 $1 / $6 / $0.10。他们还宣布了一款介于两者之间的 Terra 模型,但没什么人关注。
2026 年 6 月 30 日#
Anthropic 宣布推出 Claude Sonnet 5,Anthropic 声称它更接近自家的 Opus 系列,但反馈褒贬不一。值得注意的是,它的首发价格为 $2 / $10 / $0.20,原本只是临时价,之后会上涨。
2026 年 7 月 24 日#
Anthropic 宣布推出 Claude Opus 5。考虑到 Opus 4.5 对智能体编程兴起的影响,这是一次备受期待的大版本更新,价格为 $5 / $25 / $0.50(与 GPT-5.6 Sol 相近)。尽管部分基准测试结果出人意料地超过了规模大得多的 Fable 5,但真实世界反馈仍较为分化。
2026 年 7 月 30 日#
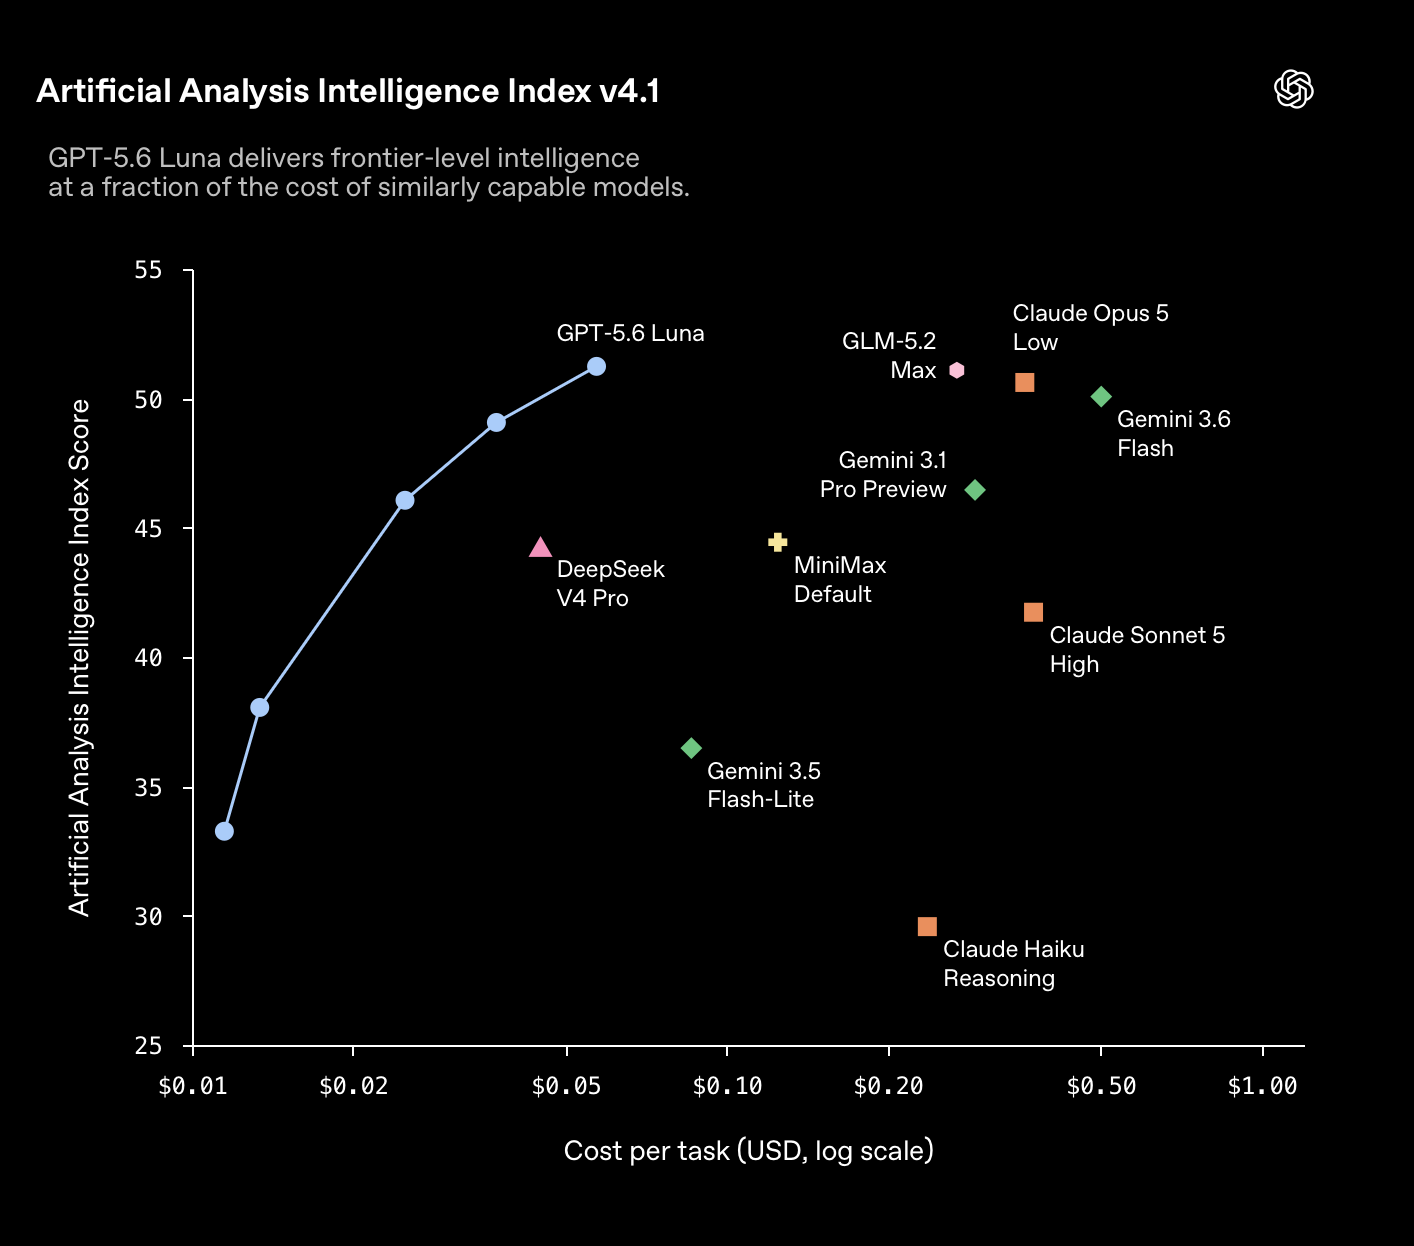
OpenAI 宣布将 GPT-5.6 Luna 的价格下调 80%(???),降至 $0.20 / $1.20 / $0.02。
2026 年 8 月 10 日#
Anthropic 宣布,Sonnet 5 首发时的临时降价现已永久生效。
2026 年 8 月 21 日#
OpenAI 宣布在未来三个月内将 GPT-5.6 Sol 的价格下调约 20%($4 / $20 / $0.40)。
2026 年 9 月 1 日#
Anthropic 宣布推出 Fable 5.1,价格为 $10 / $50 / $0.25。相较于 6 月发布、价格为 $10 / $50 / $1 的 Fable 5,它不仅在所有领域的基准测试表现都严格更好,还把缓存读取成本降低了 75%。
缓存读取成本
在使用智能体编程时,缓存读取成本占 token 总支出的绝大部分(96% - 99%),因为缓存中包含了每一轮之前的完整对话。此外,缓存的命中率通常在 90% - 100% 左右(因 LLM 推理提供方的基础设施而异)。综合来看,缓存读取成本降低 75%,意味着使用该模型的成本降低约 70% - 75%——这显然值得注意,即便缓存成本通常只是个脚注!
2026 年 9 月 3 日#
OpenAI 宣布推出 GPT-6 Astra,其规模与 Fable 5.1 相近,定价也类似,为 $10 / $50 / $1,但没有更低的缓存读取成本。Astra 的模型表现确实与 Fable 相当。
2026 年 9 月 22 日#
OpenAI 宣布推出 GPT-6 Sol,价格惊人地低至 $2 / $10 / $0.20,输入和输出价格只有临时降价的 GPT-5.6 Sol 的一半!他们同时发布了 GPT-6 Luna,输入和输出价格也只有上一版本的一半($0.10 / $0.50 / $0.01)。
就在同一天,Anthropic 宣布推出 Claude Opus 5.5,并明确表示“Opus 5.5 服务所需的算力比 Opus 5 更少,其定价也反映了这一点”。其价格 $4 / $20 / $0.20 总体上远低于 Opus 5,因为输入/输出成本降低了 20%,缓存读取成本降幅更大,使得这款甚至比 Fable 5.1 更强的模型总成本降低了 40-60%(关于 Opus 5.5 我有很多话想说,但那是另一篇文章的事了)。
2026 年 9 月 29 日#
结果 GPT-6 Sol 在性能上表现不佳,因此一周后 OpenAI 宣布推出 GPT-6.1 Sol。令人意外的是,它的性能可与 Astra 相比(个人使用后可以确认),但 OpenAI 随手把缓存价格减半($2 / $10 / $0.10),与 Anthropic 相当于输入价格 5% 的缓存读取成本对齐,使这一模型系列累计便宜了 75%。
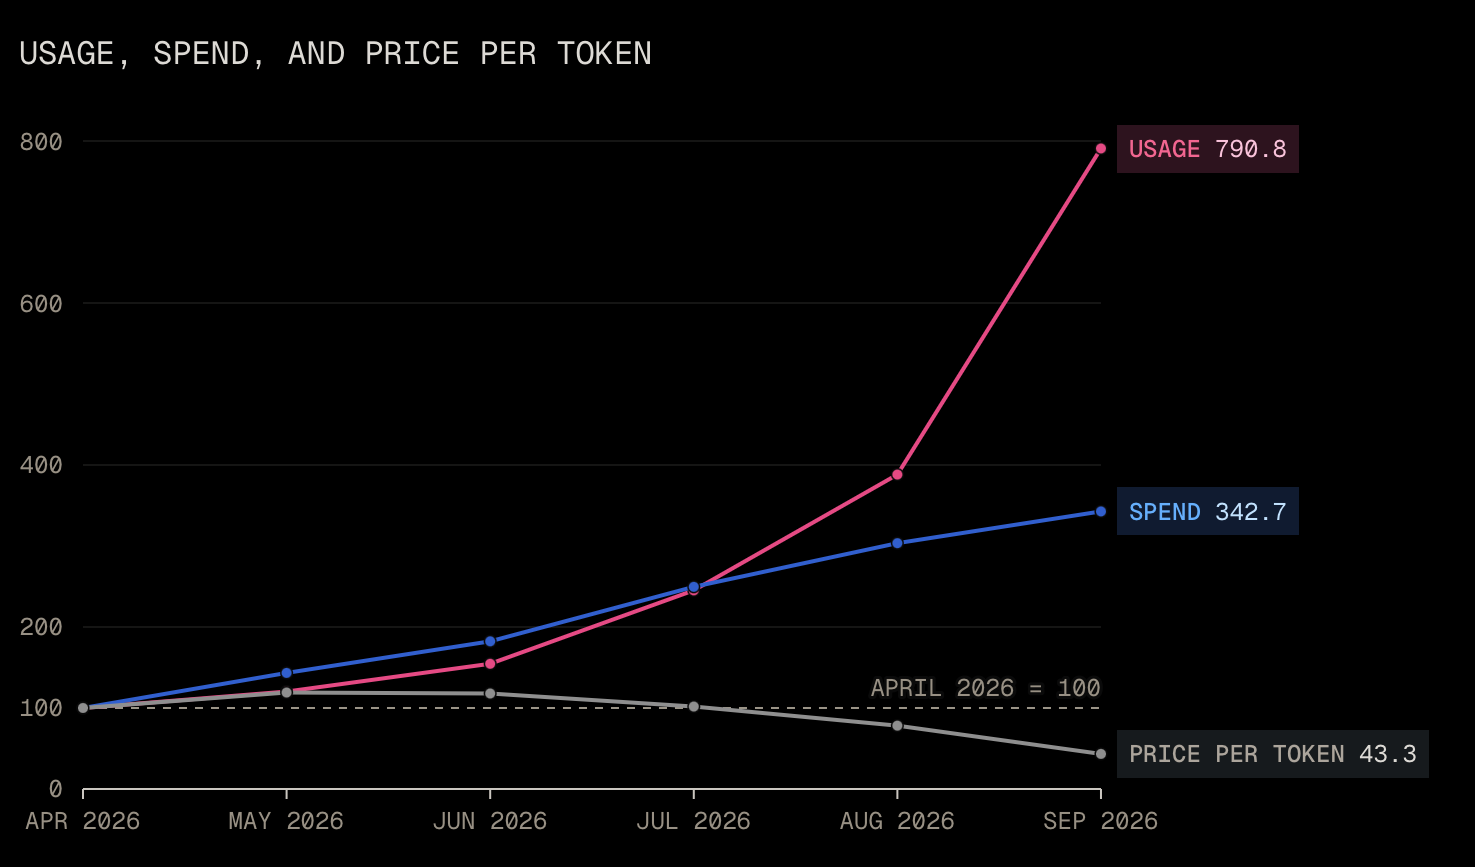
总体而言,从 6 月 GPT-5.6 系列发布到现在,使用这些热门 LLM 的成本已经大幅下跌,这在一年前是我不会预料到的。这些降价同样适用于通过 Codex 和 Claude Code 等订阅式智能体运行框架使用模型的情况。更重要的是,这些模型似乎并没有为了降价而在输出质量上偷工减料。

从上面的时间线可以看出,Anthropic 和 OpenAI 之间存在明显的针锋相对,可以合理推测这两家的这些降价是在互相回应。然而,除非有某种外部因素在起作用,否则没人会一口气降价 80%。那么,原因何在?
LLM 的行为经济学与竞争对手的定价压力#
如果你在新 LLM 发布时就用智能体测试它们,会发现除了主观感受之外很难区分彼此。自去年 11 月智能体 LLM 爆发式增长以来,模型越来越像大宗商品:只需在 OpenCode 和 Zed Agent 这类运行框架里切换一个开关,或通过 OpenRouter 换一个 API 端点字符串,就能在自己的代码库上试用新模型,门槛极低,因此护城河很小。此外,竞争者众多——不只是 Google 和 Meta 这样的大公司——它们都能提供充分替代的模型,从而形成定价压力。
对于开放权重模型,再看看 DeepSeek Flash V4.1,它最近还发布了更新版 1017 变体。
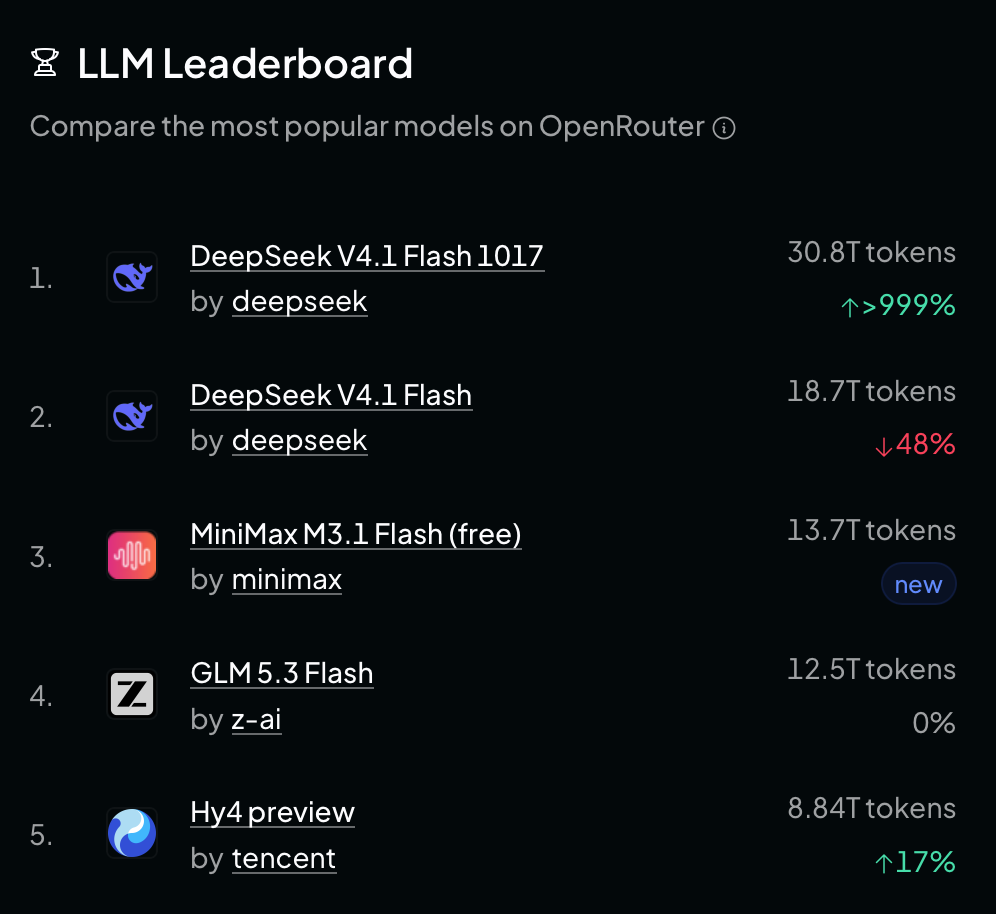
最初的 DeepSeek V4 Flash 0420 于2026 年 4 月发布,价格为 $0.14 / $0.28 / $0.0028,因此迅速走红,尤其是当时 OpenAI 还没有面向简单任务的小模型。那个 $0.0028 是关键:2% 的缓存读取占比远低于上述 OpenAI 和 Anthropic 模型的 5%-10%,使实际成本甚至比宣传的还低。我怀疑 7 月 GPT-5.6 Luna 降价 80% 就是为了专门与这些较小的开放权重模型竞争。如今,新的 DeepSeek Flash V4.1 1017 模型在基准测试上比 DeepSeek Flash V4 表现明显更好(在 Artificial Analysis 指数上为 45,而此前为 24),而 DeepSeek 的成本仍与之相近,为 $0.15 / $0.60 / $0.003。请注意关键词是“DeepSeek 的”。
在 OpenRouter 上,任何推理提供方都可以上架自己托管的模型;当用户调用 OpenRouter API 时,请求会被路由到这些模型之一——默认情况下会为了负载均衡路由到任一可用模型,但开发者可以在 API 请求中指定偏好,例如“最低价格”。今年 5 月,我曾指出,当时 OpenRouter 上有 13 家不同的提供方托管 DeepSeek V4 Flash。对于更新的 1017 变体,现在有 29 家不同的提供方。
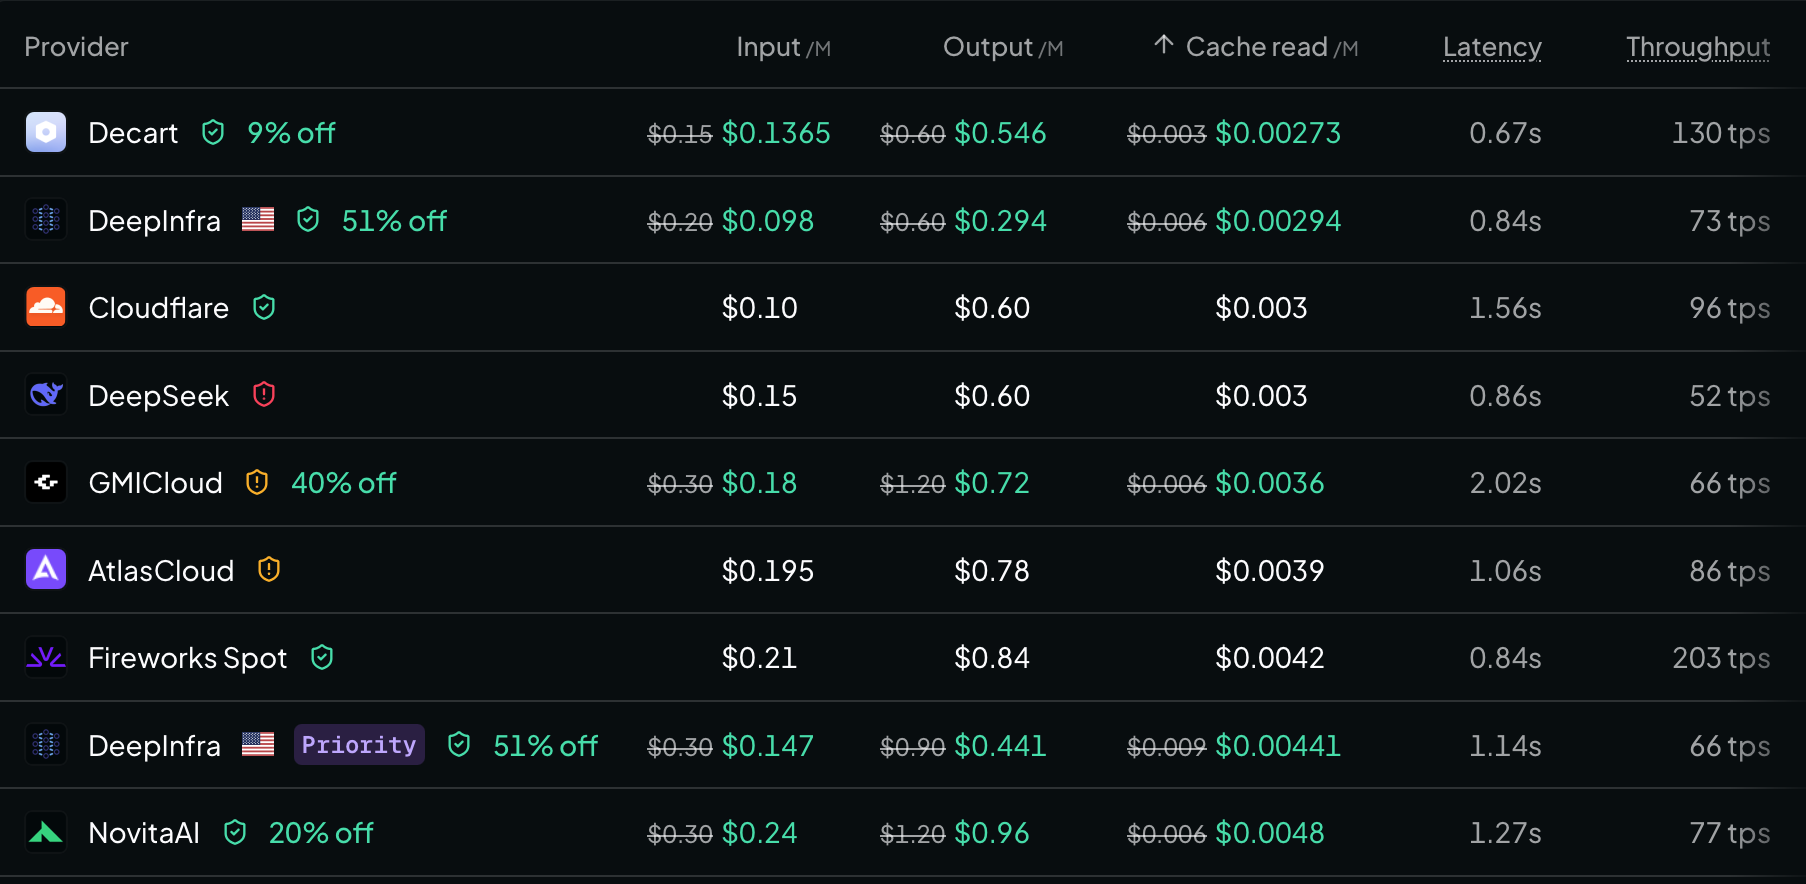
然而,从有效输入成本(综合考虑了缓存读取成本与缓存命中率之间的相互作用)来看,许多不同提供方的成本都很接近。